YKS Sıralama Hesaplama nedir?
YKS (Yükseköğretim Kurumları Sınavı), Türkiye'deki üniversiteye giriş sınavıdır ve yerleştirmede ham puanınızdan çok Türkiye sıralamanız belirleyicidir. Bu araç, puan dağılımını normal (çan) eğrisi olarak modelleyerek belirli bir puanın tüm adaylar arasında nereye düştüğünü tahmin eder ve puanınızı bir yüzdelik dilime ve yaklaşık bir sıraya çevirir.
Nasıl kullanılır?
YKS puanınızı, tüm adayların ortalama puanını, puanların standart sapmasını ve toplam aday sayısını girin. Araç; tahmini Türkiye sıralamanızı, yüzdelik diliminizi (kaç adaydan daha yüksek puan aldığınızın yüzdesini) ve z-puanınızı verir.
Formülün açıklaması
Önce puan, z-puanı ile standartlaştırılır; burada \(x\) = puanınız, \(\mu\) = ortalama puan ve \(\sigma\) = standart sapmadır:
$$z = \frac{x - \mu}{\sigma}$$Kümülatif normal dağılım \(\Phi(z)\), sizden daha düşük puan alan adayların oranını verir; dolayısıyla sizden daha yüksek puan alanların oranı \(1 - \Phi(z)\) olur. Bunu toplam aday sayısı \(N\) ile çarpmak tahmini sırayı verir:
$$\text{Rank} = (1 - \Phi(z)) \times N$$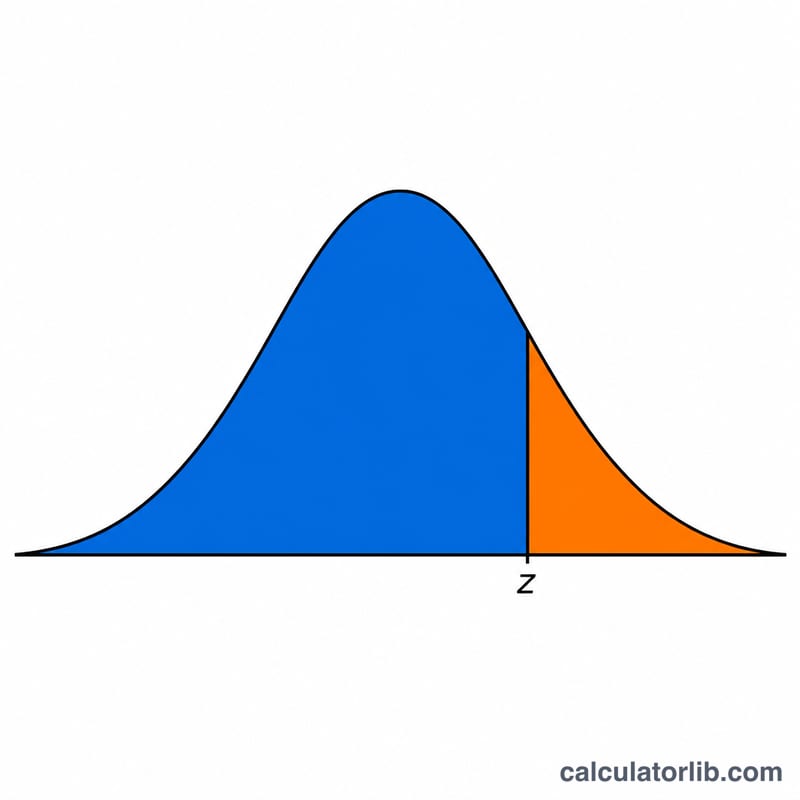
Örnek hesaplama
Diyelim ki puanınız 350, ortalama 250, standart sapma 50 ve 3.000.000 aday var. Z-puanı şöyle olur:
$$z = \frac{350 - 250}{50} = 2$$Normal CDF, \(\Phi(2) \approx 0.9772\) verir; yani adayların yaklaşık %97,72'sinden daha yüksek puan almışsınız ve sıra şöyle hesaplanır:
$$\text{Rank} = (1 - 0.9772) \times 3{,}000{,}000 \approx 68{,}250$$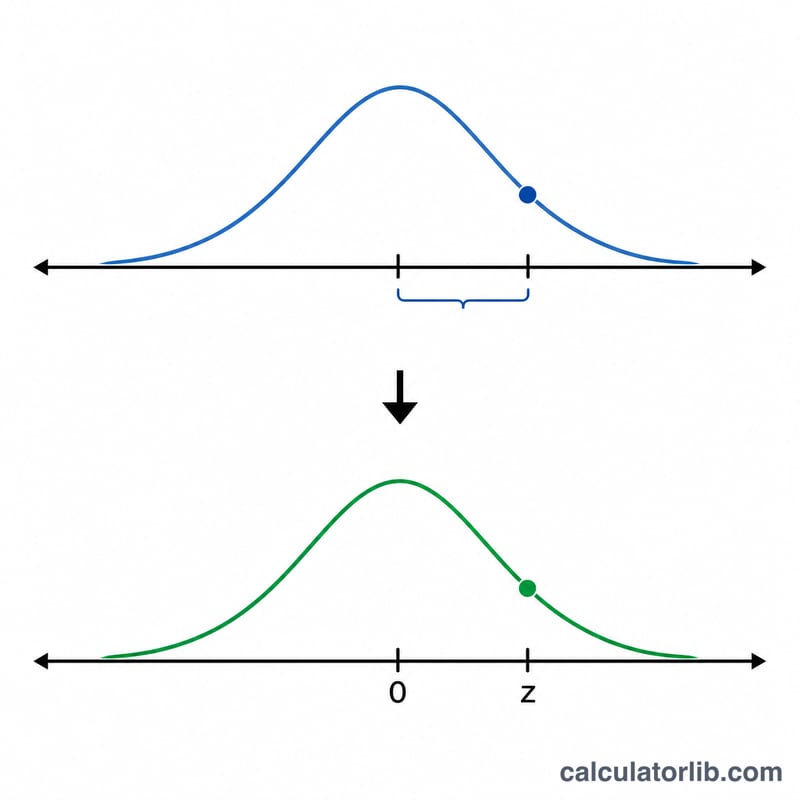
Z-Skoru ile Yüzdelik Dilim ve Sıralama Referans Tablosu
Hesaplayıcı puanınızı bir z-skoruna dönüştürür, \(z = \dfrac{\text{Puan} - \text{Ortalama}}{\text{Std. Sapma}}\). Ardından iki değeri tahmin etmek için standart normal kümülatif dağılım fonksiyonunu \(\Phi(z)\) kullanır. Yüzdelik diliminiz \(P = \Phi(z) \times 100\)'dür. Sıralamanız ise sizden daha yüksek puan almasının beklendiği aday sayısıdır: \(R = (1 - \Phi(z)) \times N\).
Aşağıdaki tabloda N = 3,000,000 aday kullanılmıştır. Bu, yalnızca açıklayıcı bir örnek değeridir; ÖSYM'nin resmi bir rakamı değildir. Gerçek aday sayıları yıla ve puan türüne göre farklılık gösterir, bu yüzden size uygulanan sayıyı girin.
| z-skoru | Φ(z) | Yüzdelik dilim | Daha yüksek puan alanların oranı (1 − Φ(z)) | Tahmini sıralama (örnek N = 3,000,000) |
|---|---|---|---|---|
| −1.0 | 0.1587 | 15.87% | 0.8413 | ≈ 2,524,000 |
| 0.0 | 0.5000 | 50.00% | 0.5000 | 1,500,000 |
| 0.5 | 0.6915 | 69.15% | 0.3085 | ≈ 925,600 |
| 1.0 | 0.8413 | 84.13% | 0.1587 | ≈ 476,000 |
| 1.5 | 0.9332 | 93.32% | 0.0668 | ≈ 200,400 |
| 2.0 | 0.9772 | 97.72% | 0.0228 | 68,250 |
| 2.5 | 0.9938 | 99.38% | 0.0062 | ≈ 18,630 |
| 3.0 | 0.99865 | 99.865% | 0.00135 | ≈ 4,050 |
Hesaplayıcı Φ(z) değerini tam hassasiyetle hesaplar. Bu nedenle gösterilen sıralamalar, N'yi yuvarlatılmış dört ondalıklı değerlerle çarpmaya kıyasla hafifçe farklılık gösterir. Örneğin z = 2 için: $$R = (1 - 0.97725) \times 3{,}000{,}000 \approx 68{,}250$$ Bu sonucu, puanınız 400, ortalama 300 ve standart sapma 50 olduğunda elde edersiniz, çünkü \(z = (400 - 300)/50 = 2\).
Tahmini Sıralamanızı Yorumlama
Yüzdelik dilim ve sıralama iki farklı ölçüdür. Yüzdelik diliminiz, sizden eşit veya düşük puan almasının beklendiği adayların oranıdır. 97.72 yüzdelik dilim, grubun yaklaşık %97.72'sinin sizden daha yüksek puan almadığı anlamına gelir. Sıralamanız ise kişi sayısıdır: sizden daha yüksek puan almasının beklendiği yaklaşık aday sayısı. Bu hesaplayıcıda 1. sıra en üst konumdur, dolayısıyla küçük sayı daha iyidir. Yüzdelik dilim grup büyüklüğünü dikkate almaz. Sıralama ise girdiğiniz aday sayısıyla doğrudan orantılı olarak artar.
Girdileriniz sonucu belirler. Tahmin tamamen girdiğiniz ortalama, standart sapma ve aday sayısına bağlıdır. Ortalamayı veya standart sapmayı biraz değiştirirseniz z-skoru kayar; bu da dağılımın ortasında tahmini sıralamayı on binlerce basamak değiştirebilir. Aday sayısını değiştirmek ise sıralamayı aynı oranda artırır ya da azaltır. Puanınızla aynı sınav yılına ve aynı puan türüne ait rakamları kullanın.
Çan eğrisi modeli yalnızca bir yaklaşımdır. Hesaplayıcı, puanların normal (çan biçimli) dağılım izlediğini varsayar. Gerçek YKS puanları bu şekle tam olarak uymaz:
- ÖSYM puanlarının sabit sınırları vardır, yaklaşık 100 ile 500 arasında. Normal eğrinin ise sınırı yoktur.
- Gerçek puan dağılımları genellikle simetrik değil, çarpık olur ve birçok aday belirli düzeylerde yığılır.
- ÖSYM, TYT ile SAY, EA, SÖZ ve DİL puan türleri için puanları ve sıralamaları ayrı ayrı yayımlar. Her birinin kendi aday sayısı ve kendi yayılımı vardır; bu yüzden bunları birleştiremez ya da birbiriyle değiştiremezsiniz.
Bu nedenlerle tahmin, dağılımın ortasına yakın bölgelerde, yaklaşık z = −1 ile z = 1 arasında en güvenilirdir. Kuyruklarda, yani çok yüksek ya da çok düşük z-skorlarında en az güvenilirdir. Orada modelle gerçek dağılım arasındaki küçük farklar, tahmini sıralamayı büyük bir oranda değiştirebilir.
Tahmin resmi sonucunuz değildir. Türkiye'de üniversite yerleştirmesi, ÖSYM'nin resmi başarı sıralamalarını ve her program için yayımlanan taban sıralamalarını kullanır. Bu tahmini kullanmaz. Hesaplayıcının çıktısını kaba bir istatistiksel yaklaşım olarak değerlendirin ve herhangi bir karar için ÖSYM'nin resmi sonuçlarınızı kontrol edin.
Sıkça Sorulan Sorular
Bu resmi bir sıralama mı? Hayır. Normal dağılım modeline dayanan istatistiksel bir tahmindir; resmi sıralamalar sınavdan sonra ÖSYM tarafından açıklanır.
Ortalama ve standart sapmayı nereden bulurum? ÖSYM her yıl istatistikleri yayımlar; ayrıca TYT veya AYT bölümleri için paylaşılan tahmini değerleri de kullanabilirsiniz.
Neden normal dağılım kullanılıyor? Büyük sınav kitleleri genellikle çan biçimli bir eğriye yakın davranır; bu da yüzdelik dilim ve sıralama için makul ve basit bir yaklaşım sağlar.