这个计算器能做什么
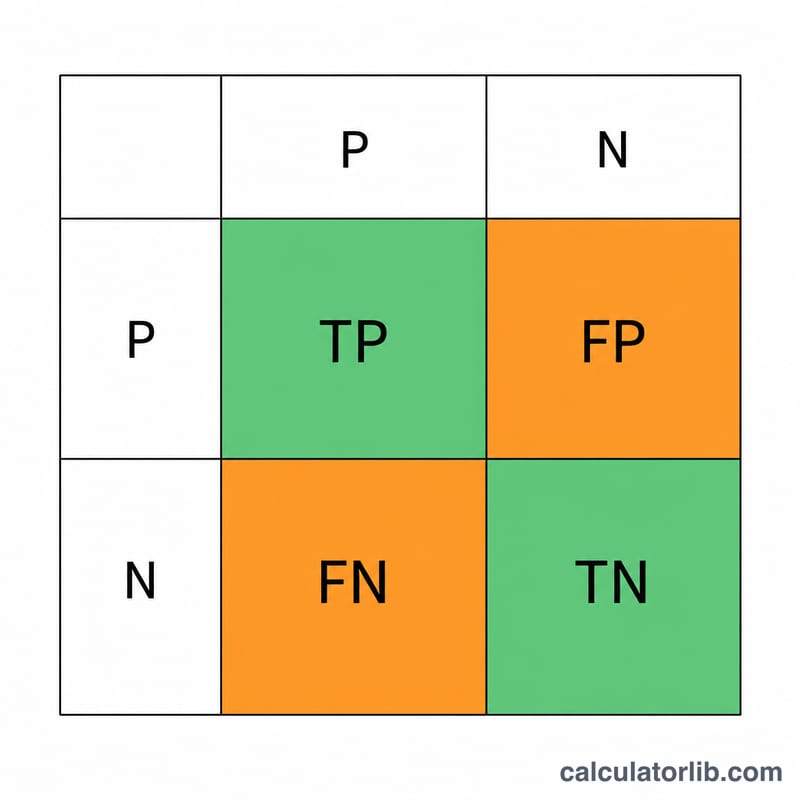
本工具用于评估二分类诊断试验或分类模型的表现。只需输入2×2混淆矩阵中的四个数值——真阳性(TP)、假阴性(FN)、真阴性(TN)和假阳性(FP),即可一键计算出灵敏度、特异度、阳性预测值(PPV)、阴性预测值(NPV)以及总体准确率。这些指标在医学、流行病学和机器学习领域都被广泛使用。
使用方法
把研究或模型中每一类结果的数量分别填入对应输入框。这里的"阳性"通常表示存在某种疾病或状况(或模型预测为正类)。TP和FP是被判定为阳性的病例,TN和FN则是被判定为阴性的病例。填好后点击"计算",五项指标就会以百分比形式一并呈现。
计算公式详解
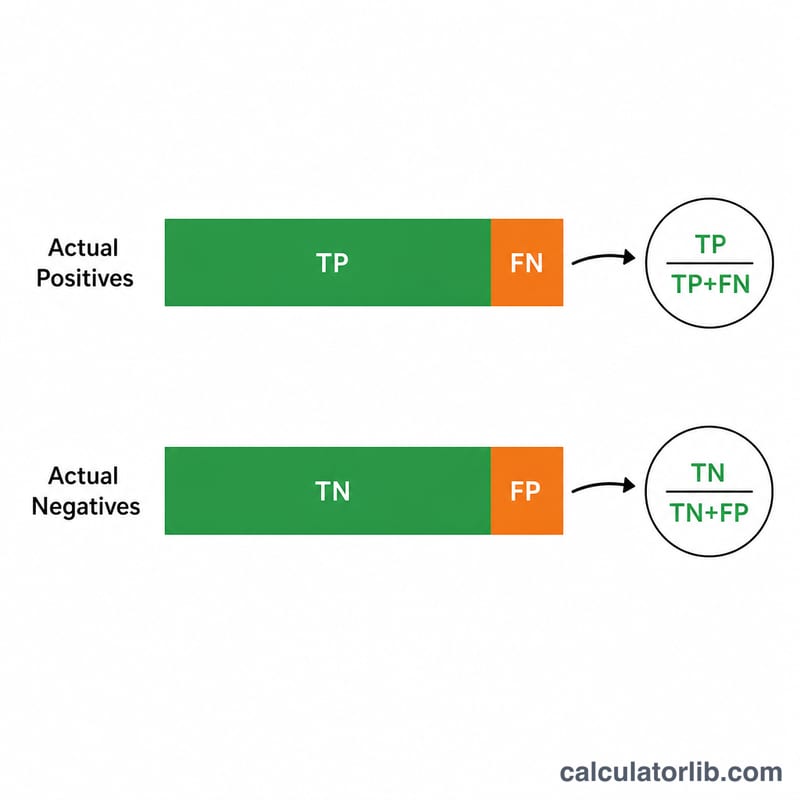
灵敏度 = TP /(TP + FN),反映试验"抓出"真实患者的能力——数值越高,说明被漏诊的患者越少。特异度 = TN /(TN + FP),反映试验排除健康人群的能力——数值越高,说明误报越少。PPV(阳性预测值)= TP /(TP + FP),表示检测结果为阳性时确实患病的概率;NPV(阴性预测值)= TN /(TN + FN),表示结果为阴性时确实未患病的概率。准确率 =(TP + TN)/ 总例数,用来概括整体判断的正确程度。
$$\text{Sensitivity} = \frac{\text{TP}}{\text{TP} + \text{FN}} \times 100\%$$
$$\text{Specificity} = \frac{\text{TN}}{\text{TN} + \text{FP}} \times 100\%$$
$$\text{PPV} = \frac{\text{TP}}{\text{TP} + \text{FP}} \times 100\%$$
$$\text{NPV} = \frac{\text{TN}}{\text{TN} + \text{FN}} \times 100\%$$
$$\text{Accuracy} = \frac{\text{TP} + \text{TN}}{\text{TP} + \text{FN} + \text{TN} + \text{FP}} \times 100\%$$
实例演算
假设某项检测得到 \(\text{TP} = 90\)、\(\text{FN} = 10\)、\(\text{TN} = 80\)、\(\text{FP} = 20\)。那么灵敏度 $$\frac{90}{90 + 10} = 90\%$$;特异度 $$\frac{80}{80 + 20} = 80\%$$;PPV $$\frac{90}{90 + 20} \approx 81.82\%$$;NPV $$\frac{80}{80 + 10} \approx 88.89\%$$;准确率 $$\frac{90 + 80}{200} = 85\%$$。
解读敏感性、特异性、PPV和NPV
敏感性是指真正患有该病的人中,被检测正确判定为阳性的比例:\(\text{TP}/(\text{TP}+\text{FN})\)。特异性是指未患该病的人中,被检测正确判定为阴性的比例:\(\text{TN}/(\text{TN}+\text{FP})\)。
- 高敏感性(SnNout):假阴性很少,因此阴性结果有助于排除该病。
- 高特异性(SpPin):假阳性很少,因此阳性结果有助于确认该病。
- 低敏感性:许多病例被漏检,因此阴性结果不太可靠。
- 低特异性:许多健康人检测呈阳性,因此阳性结果需要进一步确认。
阈值的权衡
大多数检测会产生一个连续数值(分数、浓度或概率),再通过临界值将其判定为阳性或阴性。降低临界值通常会提高敏感性,但会降低特异性;提高临界值则产生相反的效果。对于某一特定检测,没有任何阈值能同时提高两者,因此合适的临界值取决于漏检与误报的相对代价。ROC曲线展示了所有阈值下的这种权衡。
PPV和NPV取决于患病率
PPV为\(\text{TP}/(\text{TP}+\text{FP})\),NPV为\(\text{TN}/(\text{TN}+\text{FN})\)。与敏感性和特异性不同,它们会随该病在受检人群中的常见程度而变化。患病率较低时,即使是良好的检测,相对于真阳性也会产生很多假阳性,因此PPV下降、NPV上升;患病率较高时则相反。一项研究得出的PPV和NPV仅适用于患病率相近的人群。参见下表。
准确率的局限
准确率为\((\text{TP}+\text{TN})/\text{total}\)。在数据不平衡时,它可能产生误导。如果样本中只有1%的人患病,一项把所有人都判为阴性的检测准确率为99%,但敏感性为0%。因此务必将准确率与敏感性、特异性和PPV/NPV一起解读。
这些数据描述的是您输入的样本,存在抽样误差,仅供一般参考,不构成个人医疗建议。任何个人检测结果请与合格的医疗专业人员讨论。
患病率如何影响PPV和NPV
该表假设一项检测的敏感性为90%、特异性为90%,应用于10,000人。仅患病率发生变化。
| 患病率 | TP | FN | TN | FP | PPV | NPV | 准确率 |
|---|---|---|---|---|---|---|---|
| 1% | 90 | 10 | 8,910 | 990 | 8.33% | 99.89% | 90% |
| 5% | 450 | 50 | 8,550 | 950 | 32.14% | 99.42% | 90% |
| 10% | 900 | 100 | 8,100 | 900 | 50.00% | 98.78% | 90% |
| 25% | 2,250 | 250 | 6,750 | 750 | 75.00% | 96.43% | 90% |
| 50% | 4,500 | 500 | 4,500 | 500 | 90.00% | 90.00% | 90% |
1%患病率下的核对计算
患病者:10,000 × 0.01 = 100,因此 TP = 100 × 0.90 = 90,FN = 10。健康者:9,900人,因此 TN = 9,900 × 0.90 = 8,910,FP = 990。
$$\text{PPV} = \frac{90}{90+990} = \frac{90}{1080} \approx 8.33\%, \qquad \text{NPV} = \frac{8910}{8910+10} = \frac{8910}{8920} \approx 99.89\%$$
要点:同一检测,在1%患病率时,阳性结果约每12次中只有1次是正确的;而在50%患病率时,约每10次中有9次正确。每一行的准确率都保持在90%,这说明为什么仅看准确率会掩盖这一效应。
关键术语与词汇表
- 混淆矩阵
- 一个2×2表格,将检测结果(阳性/阴性)与真实情况(存在/不存在)交叉列出。其四个单元格为TP、FP、FN和TN。
- 真阳性(TP)
- 确实患病、且被检测正确判为阳性的人。
- 假阳性(FP)
- 未患病、却被检测错误判为阳性的人。
- 真阴性(TN)
- 未患病、且被检测正确判为阴性的人。
- 假阴性(FN)
- 患病、却被检测错误判为阴性的人。
- 敏感性(召回率、真阳性率)
- TP /(TP + FN)。患病者中检测呈阳性的比例。
- 特异性(真阴性率)
- TN /(TN + FP)。未患病者中检测呈阴性的比例。
- 阳性预测值(PPV、精确率)
- TP /(TP + FP)。阳性结果中为真阳性的比例。
- 阴性预测值(NPV)
- TN /(TN + FN)。阴性结果中为真阴性的比例。
- 准确率
- (TP + TN)/(TP + FP + TN + FN)。所有结果中正确的比例。
- 患病率
- (TP + FN)/ 总数。受检人群中患病的比例。
- 假阳性率
- FP /(FP + TN),等于 1 − 特异性。
- 假阴性率
- FN /(FN + TP),等于 1 − 敏感性。
常见问题
灵敏度和特异度有什么区别?灵敏度衡量的是试验能否准确检出真正患病的人;特异度衡量的是试验能否准确判定未患病的人。
为什么PPV、NPV和灵敏度、特异度不一样?预测值(PPV/NPV)会随样本中疾病的患病率而变化,而灵敏度和特异度则是试验本身固有的特性,不受患病率影响。
灵敏度达到100%的试验就一定好用吗?不一定。如果一个试验把所有人都判为阳性,那它的灵敏度是100%,但特异度却是0%,毫无实用价值。所以这两个数值必须结合起来看。