這個計算器的用途
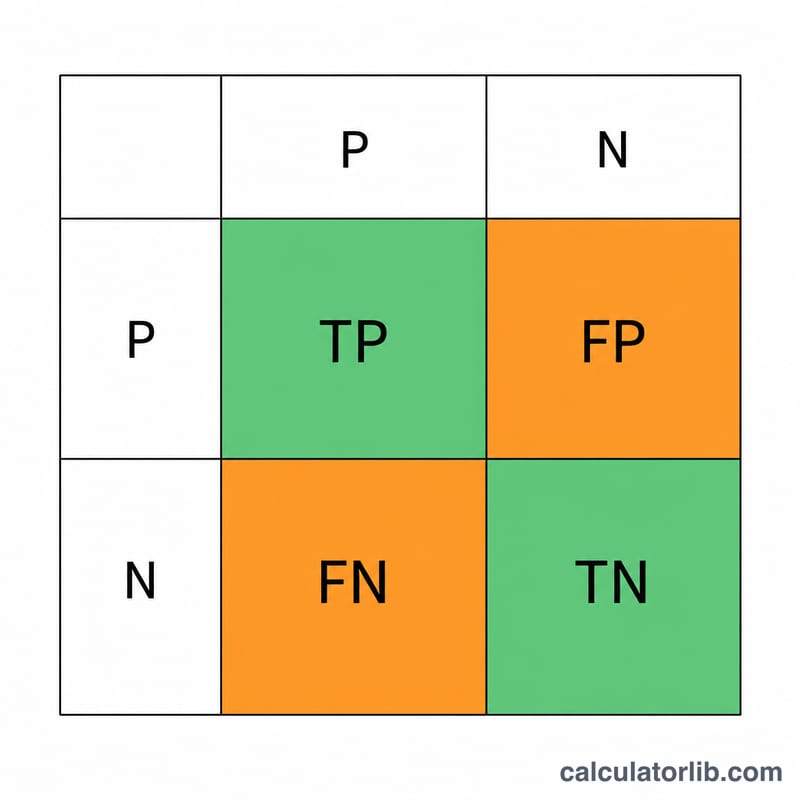
這項工具用來評估二元診斷檢測或分類模型的表現。只要輸入 2×2 混淆矩陣的四個格子——真陽性(TP)、偽陰性(FN)、真陰性(TN)與偽陽性(FP)——即可計算出敏感度、特異度、陽性與陰性預測值(PPV/NPV),以及整體準確率。這些指標廣泛應用於醫學、流行病學與機器學習領域。
使用方式
請依研究或模型結果,填入各類別的數量。所謂「陽性」通常代表受測者確實患病(或模型預測為陽性類別)。TP 與 FP 是檢測判定為陽性的案例;TN 與 FN 則是檢測判定為陰性的案例。按下計算,即可看到五項指標的百分比結果。
公式解析
敏感度 = TP /(TP + FN),代表檢測抓出真實病例的能力——數值越高,被漏掉的病患越少。特異度 = TN /(TN + FP),代表正確排除健康者的能力——數值越高,誤判(假警報)越少。PPV = TP /(TP + FP),是陽性結果為真的機率;NPV = TN /(TN + FN),則是陰性結果確實為陰性的機率。準確率 =(TP + TN)/ 總數,用來概括整體判斷的正確程度。
$$\text{Sensitivity} = \frac{\text{TP}}{\text{TP} + \text{FN}} \times 100\%$$$$\text{Specificity} = \frac{\text{TN}}{\text{TN} + \text{FP}} \times 100\%$$$$\text{PPV} = \frac{\text{TP}}{\text{TP} + \text{FP}} \times 100\%$$$$\text{NPV} = \frac{\text{TN}}{\text{TN} + \text{FN}} \times 100\%$$$$\text{Accuracy} = \frac{\text{TP} + \text{TN}}{\text{TP} + \text{FN} + \text{TN} + \text{FP}} \times 100\%$$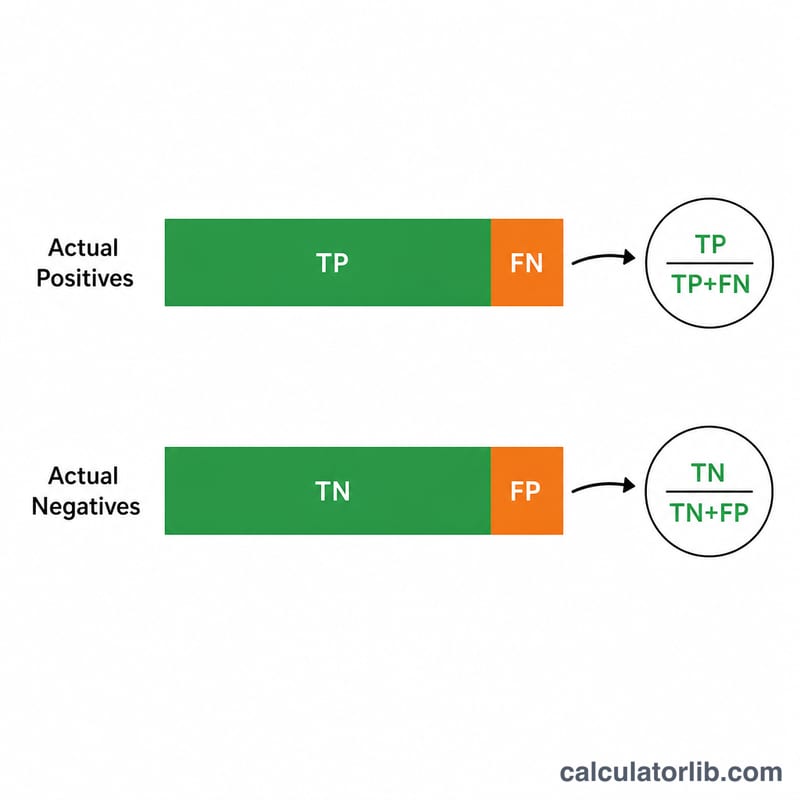
實際範例
假設某項檢測的結果為 TP = 90、FN = 10、TN = 80、FP = 20。則敏感度 = \(90 / (90 + 10) = 90\%\);特異度 = \(80 / (80 + 20) = 80\%\);PPV = \(90 / (90 + 20) \approx 81.82\%\);NPV = \(80 / (80 + 10) \approx 88.89\%\);準確率 = \((90 + 80) / 200 = 85\%\)。
解讀敏感度、特異度、PPV 與 NPV
敏感度是真正患有該疾病、且被檢測正確判為陽性的人所佔的比例:\(\text{TP}/(\text{TP}+\text{FN})\)。特異度是未患該疾病、且被檢測正確判為陰性的人所佔的比例:\(\text{TN}/(\text{TN}+\text{FP})\)。
- 高敏感度(SnNout):偽陰性很少,因此陰性結果有助於排除該疾病。
- 高特異度(SpPin):偽陽性很少,因此陽性結果有助於確認該疾病。
- 低敏感度:許多病例被漏掉,因此陰性結果不太能令人安心。
- 低特異度:許多健康的人檢測結果為陽性,因此陽性結果需要進一步確認。
閾值的取捨
大多數檢測會產生連續數值(分數、濃度或機率),再透過截斷值(cut-off)判定為陽性或陰性。降低截斷值通常會提高敏感度,但會降低特異度;提高截斷值則正好相反。對於某一特定檢測,沒有任何閾值能同時提升兩者,因此最適合的截斷值取決於漏判與誤判之間的相對成本。ROC 曲線會描繪所有閾值下的這種取捨。
PPV 與 NPV 取決於盛行率
PPV為\(\text{TP}/(\text{TP}+\text{FP})\),NPV為\(\text{TN}/(\text{TN}+\text{FN})\)。與敏感度和特異度不同,它們會隨該疾病在受檢族群中的常見程度而改變。當盛行率低時,即使是良好的檢測,相較於真陽性也會產生許多偽陽性,因此 PPV 下降、NPV 上升。盛行率高時則情況相反。某項研究得出的 PPV 與 NPV,只適用於盛行率相近的族群。請參見下表。
準確率的限制
準確率為\((\text{TP}+\text{TN})/\text{total}\)。在資料不平衡時,它可能會產生誤導。若樣本中只有 1% 患有該疾病,一項把所有人都判為陰性的檢測,準確率為 99%,但敏感度卻是 0%。解讀準確率時,務必同時參考敏感度、特異度與 PPV/NPV。
這些數據描述的是您輸入的樣本。它們帶有抽樣誤差,僅供一般資訊參考,並非個人醫療建議。任何個別結果都應與合格的醫療專業人員討論。
盛行率如何改變 PPV 與 NPV
此表假設檢測的敏感度為 90%、特異度為 90%,並套用於 10,000 人。只有盛行率會改變。
| 盛行率 | TP | FN | TN | FP | PPV | NPV | 準確率 |
|---|---|---|---|---|---|---|---|
| 1% | 90 | 10 | 8,910 | 990 | 8.33% | 99.89% | 90% |
| 5% | 450 | 50 | 8,550 | 950 | 32.14% | 99.42% | 90% |
| 10% | 900 | 100 | 8,100 | 900 | 50.00% | 98.78% | 90% |
| 25% | 2,250 | 250 | 6,750 | 750 | 75.00% | 96.43% | 90% |
| 50% | 4,500 | 500 | 4,500 | 500 | 90.00% | 90.00% | 90% |
1% 盛行率的計算驗證
患病者:10,000 × 0.01 = 100,因此 TP = 100 × 0.90 = 90,FN = 10。健康者:9,900 人,因此 TN = 9,900 × 0.90 = 8,910,FP = 990。
$$\text{PPV} = \frac{90}{90+990} = \frac{90}{1080} \approx 8.33\%, \qquad \text{NPV} = \frac{8910}{8910+10} = \frac{8910}{8920} \approx 99.89\%$$
重點:使用相同的檢測時,在 1% 盛行率下,陽性結果只有約每 12 次中有 1 次是正確的;但在 50% 盛行率下,則約每 10 次中有 9 次正確。準確率在每一列都維持在 90%,這說明了為何只看準確率會掩蓋這種效應。
關鍵術語與詞彙表
- 混淆矩陣
- 一個 2×2 表格,將檢測結果(陽性/陰性)與真實狀況(存在/不存在)交叉列表。其四個格子分別為 TP、FP、FN 與 TN。
- 真陽性(TP)
- 患有該疾病、且被檢測正確標示為陽性的人。
- 偽陽性(FP)
- 未患該疾病、卻被檢測錯誤標示為陽性的人。
- 真陰性(TN)
- 未患該疾病、且被檢測正確標示為陰性的人。
- 偽陰性(FN)
- 患有該疾病、卻被檢測錯誤標示為陰性的人。
- 敏感度(召回率、真陽性率)
- TP /(TP + FN)。患有該疾病的人中,檢測為陽性的比例。
- 特異度(真陰性率)
- TN /(TN + FP)。未患該疾病的人中,檢測為陰性的比例。
- 陽性預測值(PPV、精確率)
- TP /(TP + FP)。陽性結果中確實為真陽性的比例。
- 陰性預測值(NPV)
- TN /(TN + FN)。陰性結果中確實為真陰性的比例。
- 準確率
- (TP + TN)/(TP + FP + TN + FN)。所有結果中正確的比例。
- 盛行率
- (TP + FN)/ 總數。受檢族群中患有該疾病的比例。
- 偽陽性率
- FP /(FP + TN),等於 1 − 特異度。
- 偽陰性率
- FN /(FN + TP),等於 1 − 敏感度。
常見問題
敏感度與特異度有什麼差別?敏感度衡量檢測「找出真正患病者」的能力;特異度則衡量它「正確排除未患病者」的能力。
為什麼 PPV、NPV 會跟敏感度/特異度不同?預測值會受到樣本中疾病盛行率的影響,而敏感度與特異度則是檢測本身的固有特性,不隨盛行率改變。
一項檢測有可能 100% 敏感卻毫無用處嗎?有可能——如果一項檢測把所有人都判為陽性,它的敏感度是 100%,但特異度卻是 0%,所以這兩個數字必須一起看才有意義。