什麼是連續性校正?
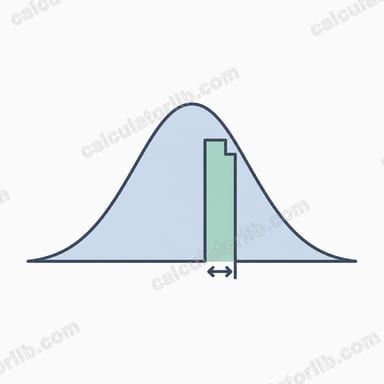
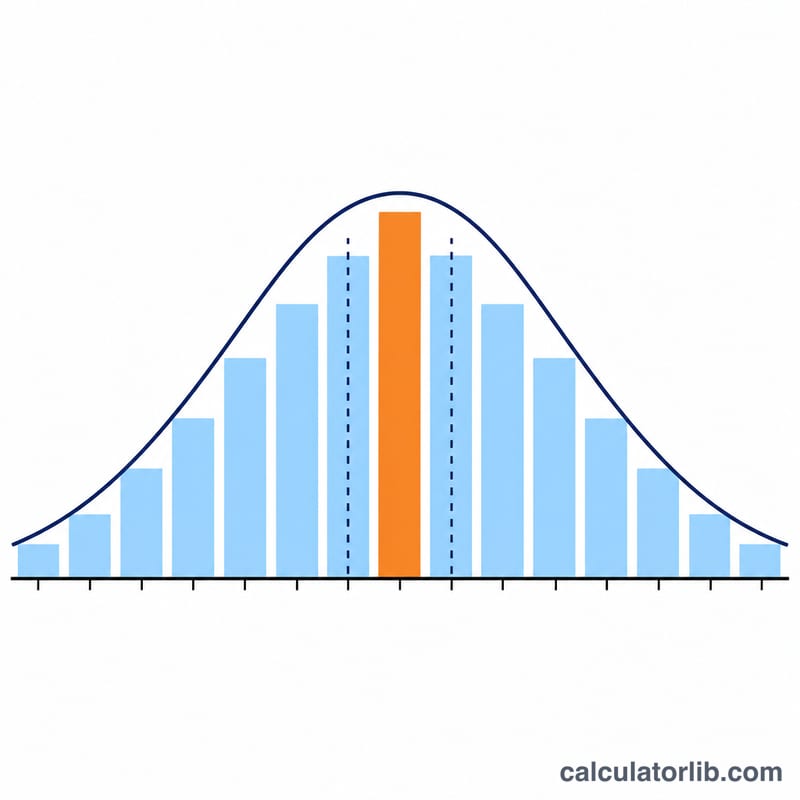
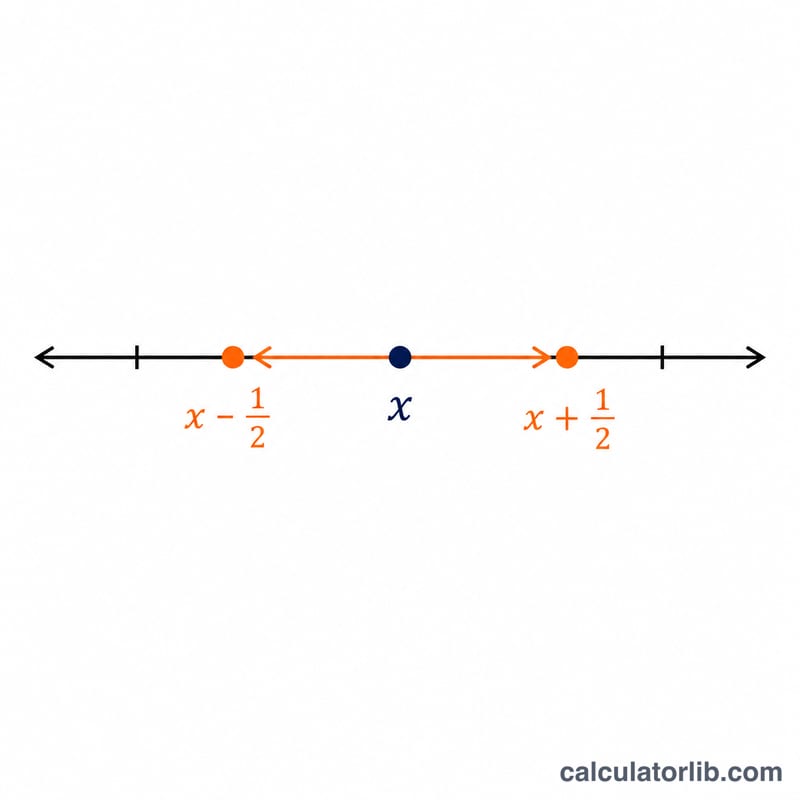
當我們用連續的常態分布來近似離散的二項分布時,原本集中在整數上的機率質量,會被「攤平」到一條平滑的曲線上。連續性校正的作用,就是在計算 \(z\) 分數之前先把邊界值平移 \(\pm 0.5\),藉此補償這種落差,讓常態近似的結果明顯更準確——尤其在樣本數偏小或中等的情況下,效果特別顯著。
如何使用這個計算器
先輸入試驗次數 n、成功機率 p,以及你想計算的值 x。接著選擇要近似的機率類型:\(P(X \le x)\) 會把 \(x\) 加上 0.5,\(P(X \ge x)\) 會減去 0.5,而 \(P(X = x)\) 則會同時回傳上下兩個邊界的 \(z\) 分數。計算器會列出校正後的 \(z\) 分數,以及平均數(\(np\))與標準差 \(\sqrt{np(1-p)}\)。
公式說明
二項分布的平均數為 \(\mu = np\),標準差為 \(\sigma = \sqrt{np(1-p)}\)。連續性校正後的 \(z\) 分數則是
$$z = \frac{(\text{x} \pm 0.5) - np}{\sqrt{np(1 - p)}}$$算出 \(z\) 值後,再查標準常態分布表(或使用常態累積分布函數 CDF),即可得到近似機率。
實例演練
假設 \(n = 100\)、\(p = 0.5\),要求 \(P(X \le 60)\)。平均數 \(np = 50\),標準差 \(\sigma = \sqrt{100 \cdot 0.5 \cdot 0.5} = \sqrt{25} = 5\)。套用校正:
$$z = \frac{60 + 0.5 - 50}{5} = \frac{10.5}{5} = 2.1$$因此 \(P(X \le 60) \approx \Phi(2.1) \approx 0.9821\)。
常見問題
什麼時候要加 0.5、什麼時候要減 0.5?當不等式由下方包含該值(\(P(X \le x)\))時加 0.5;由上方包含該值(\(P(X \ge x)\))時減 0.5。
常態近似在什麼情況下才適用?常見的經驗法則是同時滿足 \(np \ge 5\) 與 \(n(1-p) \ge 5\)。
為什麼一定要做校正?若不校正,常態近似在處理離散資料的尾端機率時,會系統性地低估或高估;加上 \(\pm 0.5\) 的平移,能消除其中大部分的偏誤。