什麼是經驗法則?
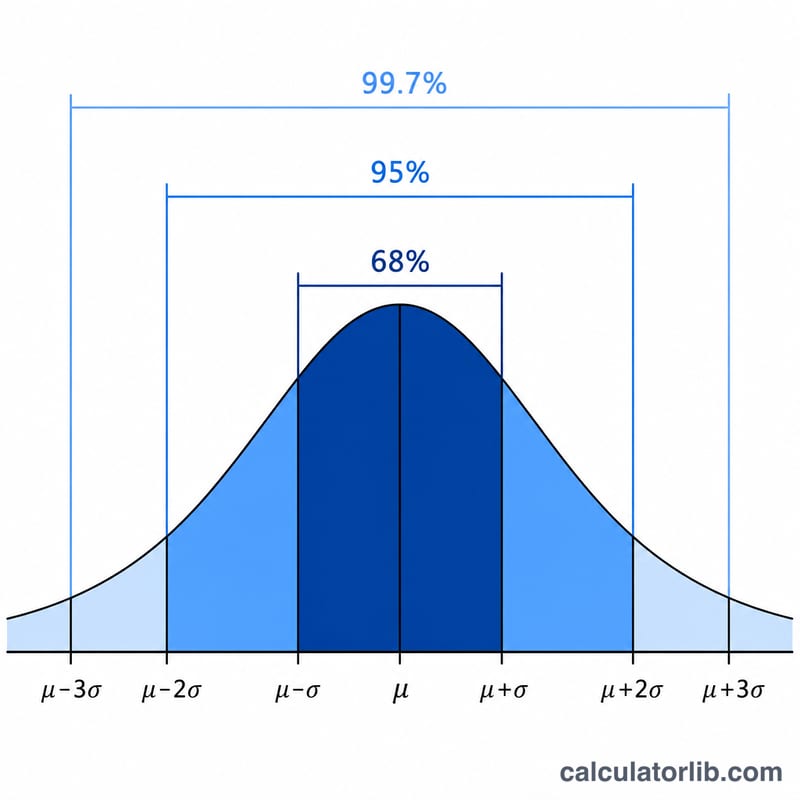
經驗法則(Empirical Rule)又稱為 68-95-99.7 法則或三倍標準差法則,用來描述資料在常態分布(鐘形曲線)中的分布情形。它指出:大約 68% 的數值落在平均值的一個標準差之內,約 95% 落在兩個標準差之內,而約 99.7% 落在三個標準差之內。這個計算器能將平均值(\(\mu\))與標準差(\(\sigma\))即時換算成上述三個區間。
如何使用這個計算器
輸入資料集的平均值與標準差,即可讀出三個對應範圍。最上方顯示的是 \(\mu \pm 1\sigma\) 區間,約涵蓋 68% 的觀測值;下方表格則進一步列出 95% 與 99.7% 的範圍。請注意,這項法則僅適用於近似常態分布的資料。
公式說明
每一個範圍都來自同一個簡單算式:
$$\mu \pm k\sigma = \text{Mean }(\mu) \pm k \cdot \text{SD }(\sigma), \quad k = 1, 2, 3$$其中 \(k\) 為 1、2 或 3。下界為平均值減去 \(k\) 倍標準差,上界為平均值加上 \(k\) 倍標準差。\(k\) 值越大,區間就越寬,所涵蓋的資料比例也越高。
$$\begin{gathered} \mu \pm k\sigma = \text{Mean }(\mu) \pm k \cdot \text{SD }(\sigma) \\[1.5em] \text{where}\quad \left\{ \begin{aligned} 68\% &: \mu \pm 1\sigma \\ 95\% &: \mu \pm 2\sigma \\ 99.7\% &: \mu \pm 3\sigma \end{aligned} \right. \end{gathered}$$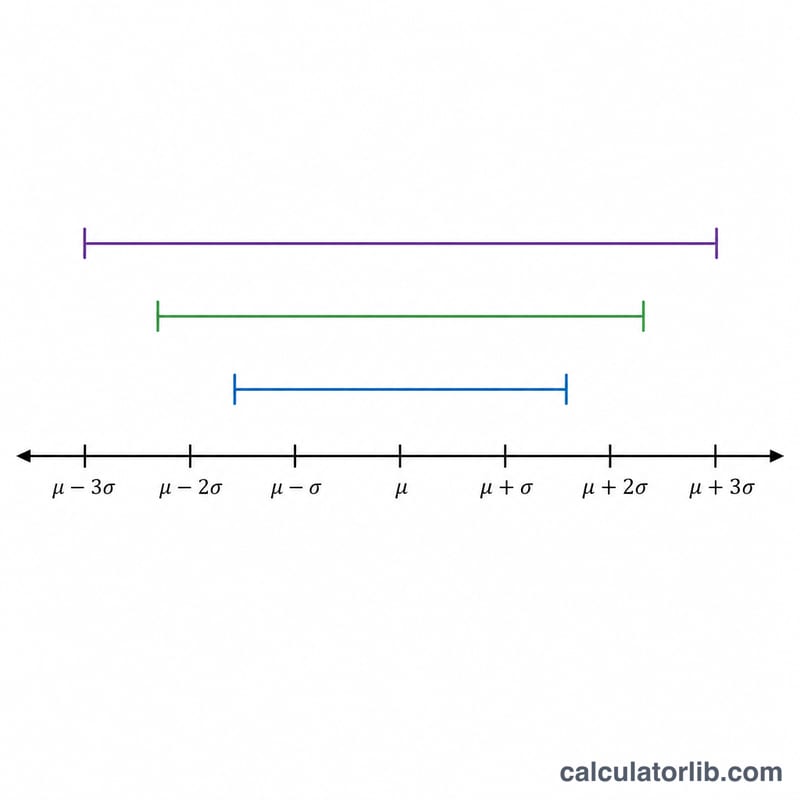
實例演算
假設某次考試的成績呈常態分布,平均值為 100,標準差為 15。那麼 68% 的成績會落在 85 到 115 之間(\(100 \pm 15\)),95% 落在 70 到 130 之間(\(100 \pm 30\)),而 99.7% 落在 55 到 145 之間(\(100 \pm 45\))。換句話說,幾乎所有成績都介於 55 到 145 之間。
常見問題
經驗法則一定準確嗎?不一定——它只適用於近似常態(對稱且呈鐘形)的資料。若資料呈偏態,則應改用柴比雪夫不等式(Chebyshev's inequality)。
為什麼是 68、95 與 99.7%?這些百分比來自標準常態曲線下、距平均值 1、2、3 個標準差範圍內的面積。
超過 \(3\sigma\) 的數值又如何?只有大約 0.3% 的資料落在三個標準差之外,因此這類觀測值通常被視為罕見值或潛在的離群值。