그러브스 이상치 검정 계산기의 기능
이 계산기는 최대 정규화 잔차 검정이라고도 불리는 그러브스 검정을 측정값 목록에 적용합니다. 가장 큰 값, 가장 작은 값 또는 평균에서 가장 멀리 떨어진 값이 단일 이상치인지 확인합니다. 유의수준에서의 G 통계량, 임계값, 그리고 기각/기각하지 않음 판정을 제공합니다. 의심스러운 측정값 하나를 빠르게 확인해야 하는 실험실 분석가, 엔지니어, 학생에게 적합합니다. 이 방법은 NIST/SEMATECH e-Handbook의 정의를 따릅니다.
사용 방법
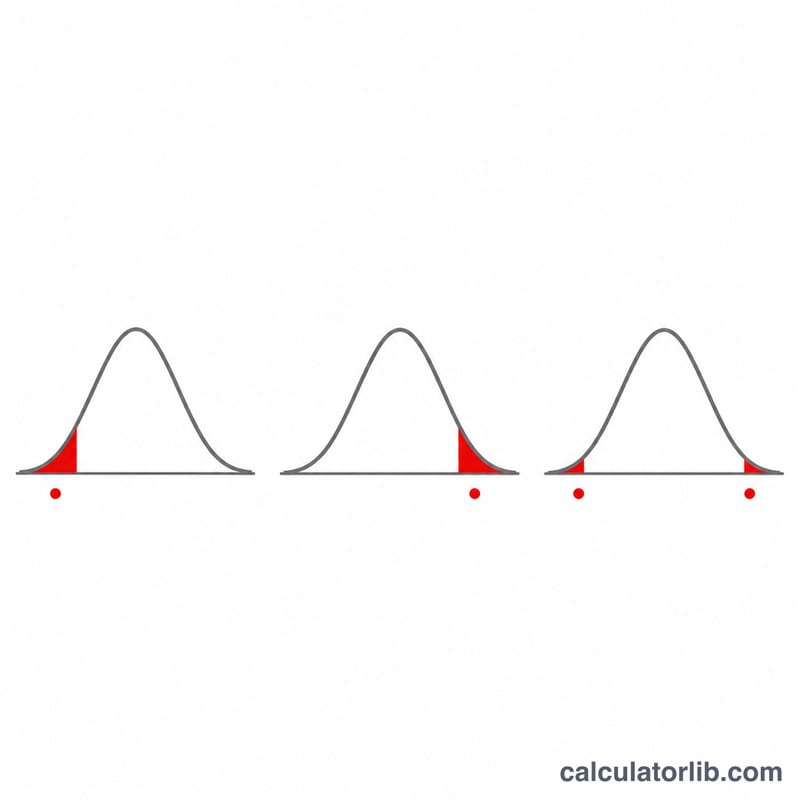
공백, 줄바꿈 또는 세미콜론으로 구분된 최소 3개의 숫자를 데이터 값에 입력하고, 소수점은 마침표를 사용합니다. 검정 유형을 선택합니다: 최댓값(단측), 최솟값(단측), 또는 가장 극단적인 값(양측). 0과 1 사이(0과 1은 제외)의 유의수준 알파를 설정하며, 일반적으로 0.05를 사용합니다. 결과에는 의심 값, N, 평균, 표본 표준편차, G, 임계값 및 판정이 표시됩니다.
공식
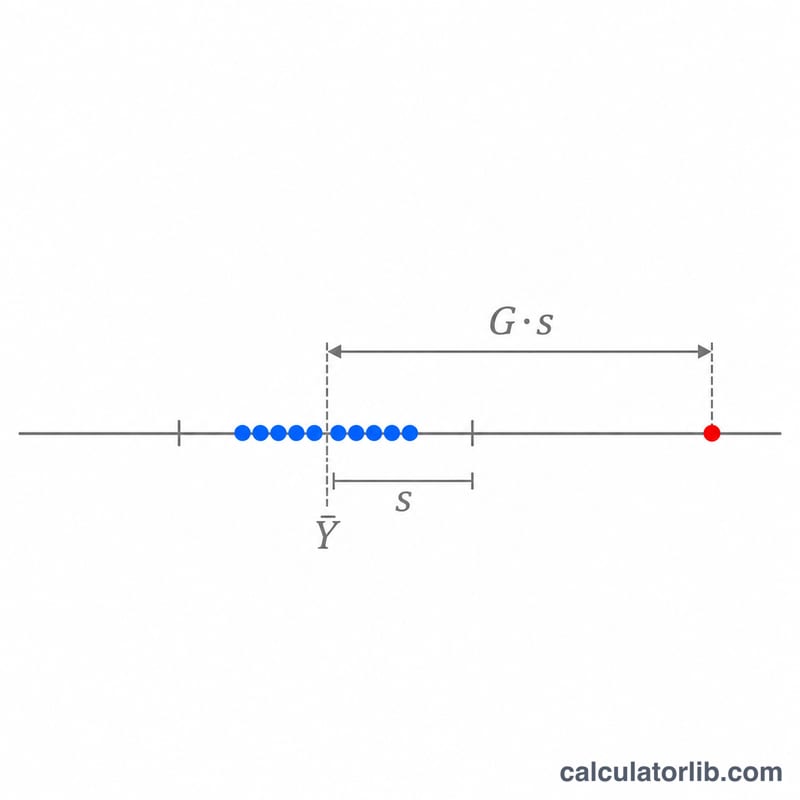
표본 \(Y_1,\dots,Y_N\)에 대해, 평균 \(\bar Y\)와 표본 표준편차 \(s\)를 사용하며, 통계량은 검정 유형에 따라 달라집니다:
$$G=\frac{\max|Y_i-\bar Y|}{s}\quad\text{(양측)},\qquad G=\frac{Y_{max}-\bar Y}{s},\qquad G=\frac{\bar Y-Y_{min}}{s}$$
임계값은 다음과 같습니다:
$$G_{crit}=\frac{N-1}{\sqrt{N}}\sqrt{\frac{t^2}{N-2+t^2}}$$
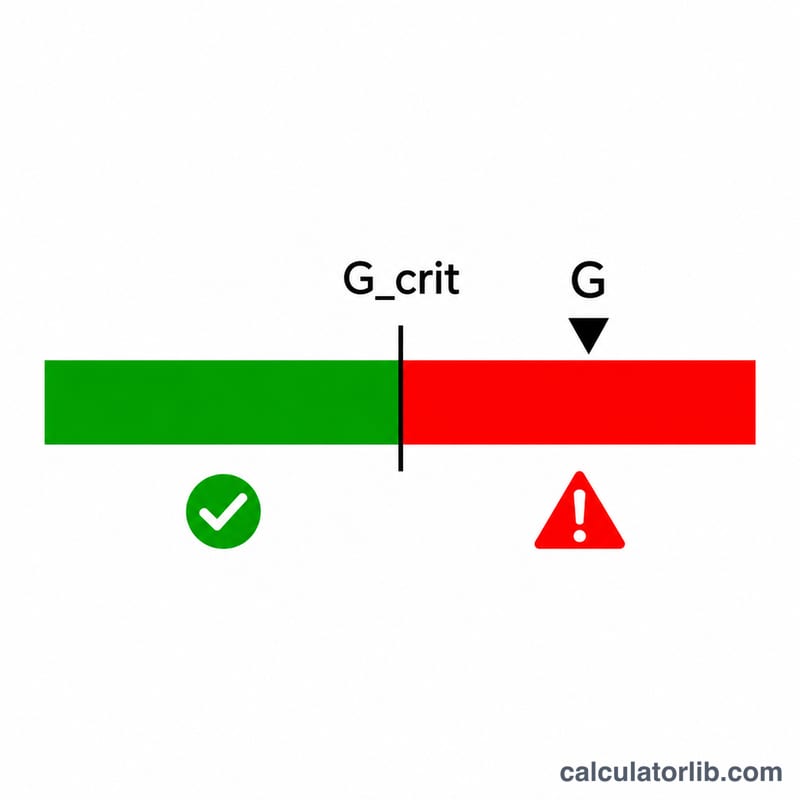
여기서 \(t\)는 자유도 \(N-2\)인 스튜던트 t 분포의 상측 임계값이며, 양측 검정에서는 \(P(T>t)=\alpha/(2N)\), 단측 검정에서는 \(\alpha/N\)입니다. 이상치가 없다는 귀무가설은 \(G>G_{crit}\)일 때 기각됩니다.
규약 및 가정
- 표준편차는 분모에 \(N-1\)을 사용하는 표본 형식입니다. 이는 NIST 예제를 재현합니다.
- 판정은 엄격합니다: G가 임계값과 같으면 기각하지 않습니다.
- t 분위수는 정규화 불완전 베타 함수로부터 상대 허용오차 \(10^{-12}\)까지 수치적으로 구합니다.
- 계산은 전체 배정밀도로 수행되며, G와 임계값은 소수점 넷째 자리까지 표시됩니다.
- 이 검정은 이상치 하나만 대상으로 합니다. 여러 이상치가 의심되면 Tietjen-Moore 검정 또는 일반화 ESD 검정을 사용하십시오.
- 데이터는 대략 정규분포를 따라야 합니다. 3개에서 5000개 사이의 값이 허용되며, 모든 값이 동일하면 안 됩니다.
예제 풀이
NIST 우라늄 동위원소 데이터는 199.31, 199.53, 200.19, 200.82, 201.92, 201.95, 202.18, 245.57이며, \(\alpha=0.05\)에서 최댓값으로 검정합니다. 여기서 \(N=8\), \(\bar Y=206.43375\), \(s=15.852564\)입니다.
$$G=\frac{245.57-206.43375}{15.852564}=2.4688$$
꼬리 확률은 \(\alpha/N=0.05/8=0.00625\)이며, 임계값은 다음과 같습니다:
$$G_{crit}=2.0317$$
\(2.4688>2.0317\)이므로 H0는 기각되며, 245.57은 이상치로 판정됩니다.
결과 해석 및 한계
기각은 의심 값이 선택한 수준에서 나머지 값들과 같은 정규 모집단에서 나왔을 가능성이 낮다는 뜻입니다. 값이 왜 극단적인지는 말해주지 않으므로, 제거하기 전에 기록 오류나 실제 공정 변화를 확인하십시오. 기각하지 않음은 이상치에 대한 증거가 충분하지 않다는 뜻입니다. 표본이 작으면 검정력이 낮습니다. 두 번째 극단값이 존재하면 마스킹으로 인해 이상치가 가려질 수 있습니다. 같은 데이터 세트에 검정을 반복 적용하면 오류율이 바뀌므로 하지 마십시오.
자주 묻는 질문
양측 옵션은 언제 사용해야 하나요?
의심 값이 데이터의 양 끝 어느 쪽에도 있을 수 있을 때 사용합니다. 데이터를 보기 전에 높은 값 또는 낮은 값만 문제라고 판단했을 때만 단측 검정을 사용하십시오.
임계값이 왜 알파를 N으로 나눈 값에 기반하나요?
이 검정은 N개 값 중 가장 극단적인 값을 보므로, 전체 오류율을 알파로 유지하기 위해 본페로니형 보정을 사용합니다.
이상치가 두 개라고 생각되면 어떻게 하나요?
그러브스 검정은 하나만 처리합니다. 대신 Tietjen-Moore 검정 또는 일반화 ESD 검정을 사용하십시오.
데이터는 왜 대략 정규분포를 따라야 하나요?
임계값은 관측값이 정규분포를 따른다고 가정하는 t 분포에서 나오기 때문입니다. 치우친 데이터는 잘못된 이상치를 만들 수 있습니다.
G의 최댓값은 얼마인가요?
\((N-1)/\sqrt{N}\)입니다. N = 3이면 1.1547이므로, 임계값은 이 상한에 가깝습니다.
출처
- 1.3.5.17.1. Grubbs' Test for Outliers – NIST/SEMATECH e-Handbook of Statistical Methods