Kruskal–Wallis 계산기의 기능
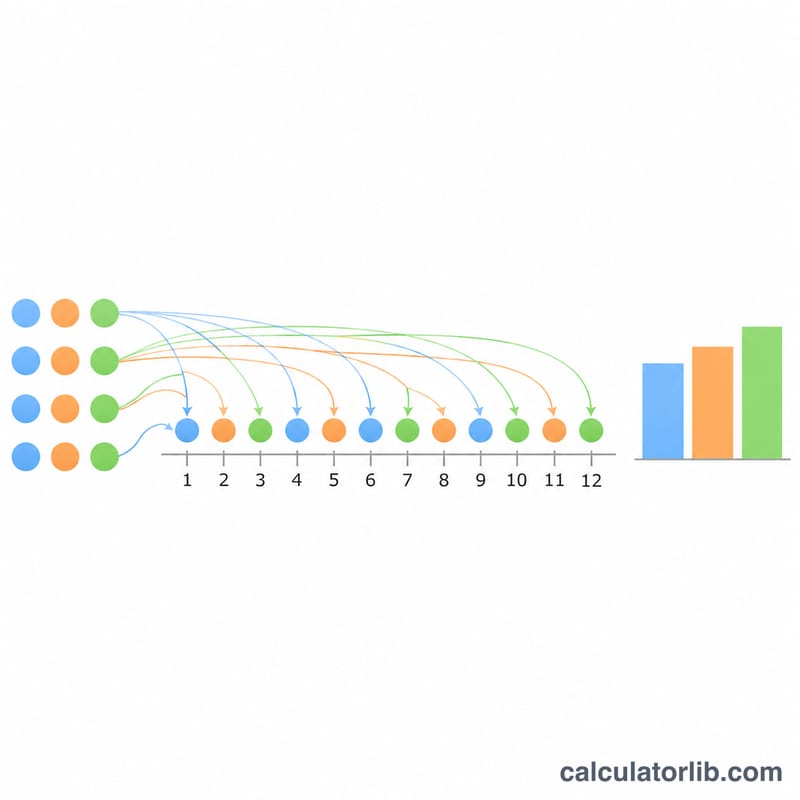
Kruskal–Wallis 검정은 k개의 독립 표본이 동일한 모집단에서 왔는지 확인하는 순위 기반 일요인 검정입니다. 일원 분산분석(ANOVA)의 비모수 대응 검정이며, 데이터가 순서형이거나 왜도가 있거나 이상치를 포함할 때 사용합니다. 계산기는 관측값을 통합하고, 순위(동점의 경우 평균 순위)를 부여한 뒤, 순위합, 동점 보정된 H 통계량, 카이제곱 p-값, 임계값 및 기각 또는 채택 결정을 계산합니다.
사용 방법
집단 1, 집단 2, 집단 3의 관측값을 쉼표, 세미콜론 또는 공백으로 구분된 숫자로 입력합니다. 집단 1~3은 필수입니다. 집단 4, 5, 6은 선택 사항이며, 사용하지 않는 집단에는 -를 입력합니다. 그다음 유의수준 알파(기본값 0.05)를 설정합니다. 집단 크기는 달라도 되며, 집단 순서는 H에 영향을 주지 않고, 전체 관측값은 5000개를 넘을 수 없습니다.
공식
동점이 없을 때 통계량은 다음과 같습니다.
$$H_0=\frac{12}{n(n+1)}\sum_{i=1}^{k}\frac{R_i^2}{n_i}-3(n+1)$$여기서 \(n_i\)는 집단 i의 관측값 수, \(R_i\)는 집단 i의 순위합, \(n\)은 전체 관측값 수, \(k\)는 집단 수입니다. 동점이 있을 때는 다음과 같습니다.
$$C=1-\frac{\sum_j (t_j^3-t_j)}{n^3-n},\qquad H=\frac{H_0}{C}$$여기서 \(t_j\)는 j번째 동점 묶음의 크기입니다. p-값은 다음과 같습니다.
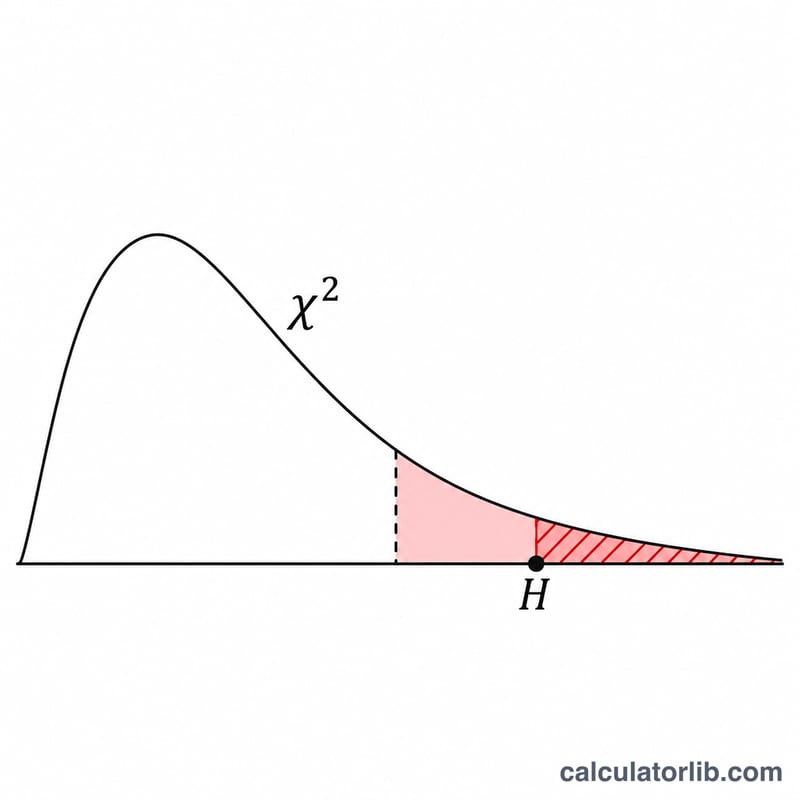
$$p=P(\chi^2_{k-1}\ge H)$$H가 자유도 k − 1의 카이제곱 분포에서 1 − alpha에 해당하는 백분위수보다 크면 귀무가설을 기각합니다.
규칙과 가정
- 동점 값은 해당 순위들의 평균을 받습니다. 보고되는 H는 동점 보정된 값이며, 동점이 없으면 보정되지 않은 H와 같습니다. 동점 보정은 NIST 페이지에 제시되어 있지 않으므로 설계상의 선택으로서 표준 Conover/Kruskal–Wallis 방식을 사용합니다.
- H는 자유도 k − 1의 카이제곱 분포와 상측 꼬리를 사용하여 비교합니다.
- 결정 규칙: H가 임계값보다 크면 H0를 기각합니다. 기본 알파는 0.05입니다.
- 어느 집단이라도 관측값이 5개 미만이면, 카이제곱 근사가 부정확할 수 있으므로 소표본 경고가 표시됩니다. 결과는 여전히 계산됩니다.
- 모든 값이 동일하면 C = 0이고 H는 정의되지 않으므로 계산기는 오류를 표시합니다. 최소 두 개의 집단이 필요합니다. H = 0이면 p = 1입니다.
- 내부적으로는 원래 값을 사용합니다. 표시: H, p, 임계값 및 C는 소수점 넷째 자리까지, 순위합은 소수점 첫째 자리까지 표시합니다.
예제
각 6개 값으로 이루어진 세 집단: 집단 1 = 27, 2, 4, 18, 7, 9; 집단 2 = 20, 8, 14, 36, 21, 22; 집단 3 = 34, 31, 3, 23, 30, 6; 알파 = 0.05. 여기서 \(n=18\), \(k=3\)이며 동점은 없습니다.
$$R_1=39.0,\quad R_2=65.0,\quad R_3=67.0$$$$H_0=\frac{12}{18\times 19}\left(\frac{39^2}{6}+\frac{65^2}{6}+\frac{67^2}{6}\right)-3\times 19=2.8538$$동점 계수는 \(C=1\)이므로 \(H=2.8538\)입니다(보정 전과 동일). 자유도는 2, p-값은 0.2401, 임계값은 5.9915입니다. 2.8538이 5.9915보다 작으므로 H0를 기각하지 않습니다. 각 집단의 관측값이 6개이므로 소표본 경고는 적용되지 않습니다.
결과 해석과 한계
p-값이 작으면(알파보다 작으면) 적어도 한 집단이 다른 집단보다 큰 값 또는 작은 값을 가지는 경향이 있음을 시사합니다. 이 검정은 어느 집단이 다른지 알려주지 않으므로, 유의한 결과가 나오면 쌍별 비교를 수행하십시오. 이 검정은 독립 표본을 가정하며, 중앙값의 차이로 해석하려면 분포 모양이 비슷하다고 가정합니다. 집단 크기가 5보다 작으면 카이제곱 근사보다 정확한 표를 사용하는 것이 좋습니다.
자주 묻는 질문
ANOVA 대신 Kruskal–Wallis를 언제 사용해야 하나요?
정규성이 의심스럽거나, 데이터가 순서형이거나, 이상치가 있을 때 사용합니다.
동점은 어떻게 처리되나요?
동점 값은 해당 순위들의 평균을 공유하며, H는 보정 계수 C로 나눕니다.
소표본 경고는 무엇을 의미하나요?
적어도 한 집단의 값이 5개 미만이므로 카이제곱 p-값은 근사값일 뿐입니다.
집단 크기가 달라도 되나요?
네. 공식은 각 순위합에 해당 집단의 크기를 가중치로 적용합니다.
사용하지 않는 집단에 왜 -를 입력해야 하나요?
빈 칸은 기본값으로 대체되므로, 하이픈은 집단을 사용하지 않음으로 표시합니다. 집단 4~6만 사용하지 않을 수 있습니다.
출처
- Dataplot KRUSKAL WALLIS command reference, NIST Information Technology Laboratory, 2023