Kruskal–Wallis 計算機的功能
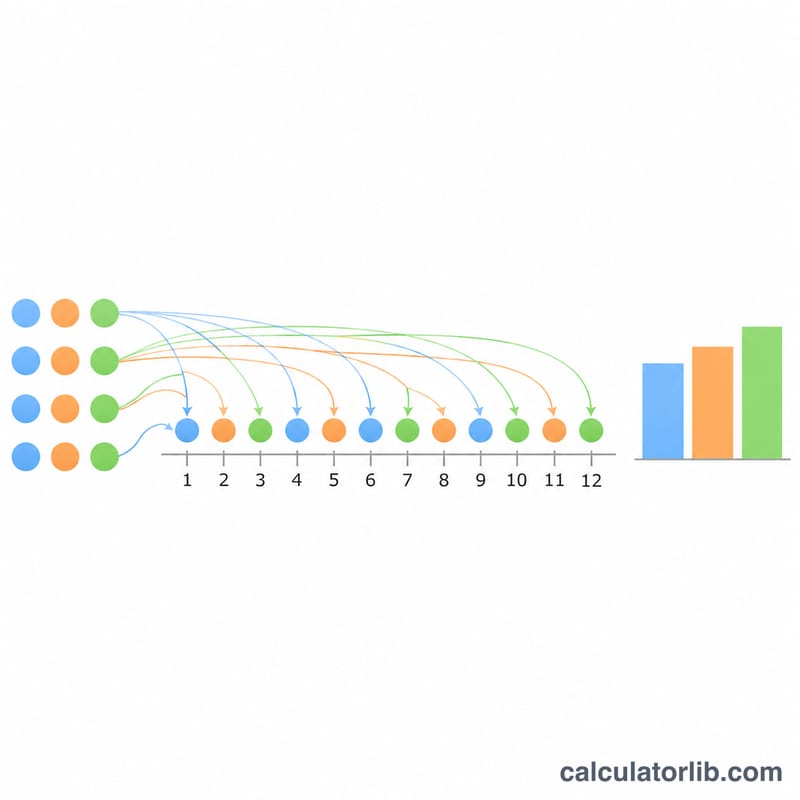
Kruskal–Wallis 檢定是一種以秩次為基礎的單因子檢定,用來判斷 k 個獨立樣本是否來自相同的母體。它是單因子變異數分析(one-way ANOVA)的無母數對應方法,適用於資料為順序尺度、偏態或含有離群值的情況。計算機會合併所有觀測值,指定秩次(秩次相同者取平均秩次),接著計算各組秩和、經校正的 H 統計量、卡方 p 值、臨界值,以及拒絕或保留的判定結果。
使用方法
請以逗號、分號或空格分隔,輸入第 1 組、第 2 組與第 3 組的觀測值。第 1 至第 3 組為必填;第 4、5、6 組為選填,若某組未使用,請在該組輸入 -。接著設定顯著水準 alpha(預設為 0.05)。各組樣本數可以不同,組別順序不影響 H,觀測值總數不得超過 5000 筆。
公式
若無秩次相同,統計量為
$$H_0=\frac{12}{n(n+1)}\sum_{i=1}^{k}\frac{R_i^2}{n_i}-3(n+1)$$其中 \(n_i\) 為第 i 組的觀測值數,\(R_i\) 為第 i 組的秩和,\(n\) 為觀測值總數,\(k\) 為組別數。若有秩次相同,則使用:
$$C=1-\frac{\sum_j (t_j^3-t_j)}{n^3-n},\qquad H=\frac{H_0}{C}$$其中 \(t_j\) 為第 j 組秩次相同值的個數。p 值為
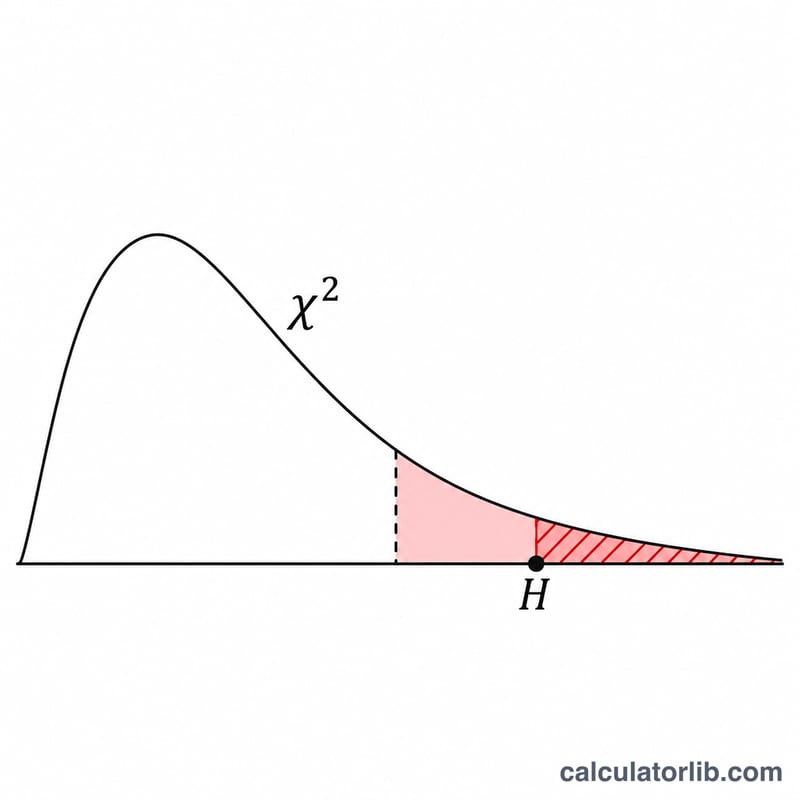
$$p=P(\chi^2_{k-1}\ge H)$$當 H 超過自由度為 k − 1、信賴水準為 1 − alpha 的卡方百分位數時,檢定會拒絕虛無假設。
慣例與假設
- 秩次相同的值會取其所佔秩次的平均值。回報的 H 為經秩次相同校正的值;若無秩次相同,則等於未校正的 H。此秩次相同校正採用標準的 Conover/Kruskal–Wallis 形式,因為 NIST 頁面未列出該公式,故作為設計上的選擇。
- H 會以自由度為 k − 1 的卡方分布進行比較,並採用右尾。
- 判定規則:若 H 大於臨界值,則拒絕 H0。預設 alpha 為 0.05。
- 若任何一組的觀測值少於 5 筆,會顯示小樣本警告,因為卡方近似可能不可靠。結果仍會照常計算。
- 若所有值皆相同,則 C = 0,H 無定義,計算機會回報錯誤。至少需要兩組。若 H = 0,則 p = 1。
- 內部使用原始數值。顯示時,H、p、臨界值與 C 取至小數點後 4 位,秩和取至小數點後 1 位。
範例演算
三組,每組六個值:第 1 組 = 27、2、4、18、7、9;第 2 組 = 20、8、14、36、21、22;第 3 組 = 34、31、3、23、30、6;alpha = 0.05。此處 \(n=18\),\(k=3\),且無秩次相同。
$$R_1=39.0,\quad R_2=65.0,\quad R_3=67.0$$$$H_0=\frac{12}{18\times 19}\left(\frac{39^2}{6}+\frac{65^2}{6}+\frac{67^2}{6}\right)-3\times 19=2.8538$$秩次相同校正因子為 \(C=1\),因此 \(H=2.8538\)(與校正前相同)。自由度為 2,p 值為 0.2401,臨界值為 5.9915。由於 2.8538 小於 5.9915,故不拒絕 H0。由於每組皆有 6 筆觀測值,因此不適用小樣本警告。
結果解讀與限制
p 值小於 alpha 時,表示至少有一組傾向於產生比其他組更大或更小的值。此檢定無法指出哪些組別之間有差異;若結果顯著,應接著進行兩兩比較。此檢定假設樣本彼此獨立;若要將結果解讀為中位數差異,則還需假設各組分布形狀相似。若某組樣本數少於 5,較適合使用精確表,而非卡方近似。
常見問題
何時應使用 Kruskal–Wallis 而非 ANOVA?
當常態性存疑、資料為順序尺度,或存在離群值時,應使用 Kruskal–Wallis。
如何處理秩次相同的情況?
秩次相同的值會共用其秩次的平均值,且 H 會除以校正因子 C。
小樣本警告代表什麼?
至少有一組的值少於 5 個,因此卡方 p 值僅為近似值。
可以使用樣本數不相等的組別嗎?
可以。公式會依各組自身的樣本數對各組秩和進行加權。
為什麼未使用的組別需要輸入 -?
空白欄位會被替換為預設值,因此輸入破折號可標示該組未使用。只有第 4 至第 6 組可以不使用。
資料來源
- Dataplot KRUSKAL WALLIS 指令參考手冊,美國國家標準與技術研究院(NIST)資訊技術實驗室,2023