Levene 檢定計算機的功能
Levene 檢定用來判斷兩組或以上的資料是否具有相同變異數,這種條件稱為變異數同質性。許多程序,包括變異數分析(ANOVA)與合併樣本 t 檢定,都假設此條件成立。本計算機接受每一組的原始資料,計算 W 統計量、自由度、F 分布的右尾 p 值、您所選顯著水準下的臨界值,並給出拒絕或不拒絕的判定。它適合需要在進一步檢定前確認此假設的學生、分析師與研究人員。
使用方法
請在第一個欄位輸入資料。組與組之間以分號分隔,組內數值以逗號分隔,例如兩組資料可輸入 6,8,4;12,15,7。每組至少需要兩個數值,且每個項目都必須是數字。接著選擇計算離差所用的中心:中位數(Brown-Forsythe 變體,建議選項)或平均數(原始 Levene 方法)。最後設定顯著水準 alpha,範圍介於 0.0001 至 0.5 之間,預設值為 0.05。
公式
每個觀測值都會轉換為其組中心的絕對離差,W 則比較各組之間與組內離差的分散程度。
$$Z_{ij} = |Y_{ij} - c_i|$$$$W = \frac{N-k}{k-1} \times \frac{\sum_{i=1}^{k} N_i\,(\bar{Z}_i - \bar{Z})^2}{\sum_{i=1}^{k}\sum_{j=1}^{N_i} (Z_{ij} - \bar{Z}_i)^2}$$其中 \(k\) 為組數,\(N_i\) 為第 \(i\) 組的樣本數,\(N\) 為觀測值總數,\(c_i\) 為組平均數或中位數,\(\bar{Z}_i\) 為第 \(i\) 組離差的平均數,\(\bar{Z}\) 為所有離差的平均數。當 \(W > F(\alpha, k-1, N-k)\) 時,拒絕變異數相等的虛無假設。
慣例與假設
- 預設中心為中位數,平均數為可選項。由於來源資料未定義修剪規則,本計算機不提供修剪平均數。
- 偶數個樣本組的中位數,為排序後兩個中間值的平均。
- 分子自由度為 \(k-1\),分母自由度為 \(N-k\)。
- p 值為右尾機率 \(P(F \ge W)\),以正則化不完全貝他函數計算。
- 判定採嚴格不等式:當 W 等於臨界值時,不拒絕虛無假設。
- 計算過程中不進行內部四捨五入。W 與 p 值顯示至小數點後 6 位,臨界值顯示至小數點後 4 位。
- 限制:2 至 50 組,每組至少 2 個值,總值數最多 5000 個。若各組內的離差皆不變,則 W 無定義。
計算範例
輸入三組資料:6,8,4,5,9;12,15,7,20,3;以及 5,6,5,7,6。中心選擇中位數,且 \(\alpha = 0.05\)。此時 \(k = 3\),\(N = 15\)。
$$df_1 = k-1 = 2,\quad df_2 = N-k = 12$$$$W = 5.284768$$$$p = 0.022592,\quad F_{0.05,\,2,\,12} = 3.8853$$由於 \(5.284768 > 3.8853\),等同於 \(p = 0.022592 < 0.05\),因此檢定拒絕變異數相等的假設。
如何解讀結果
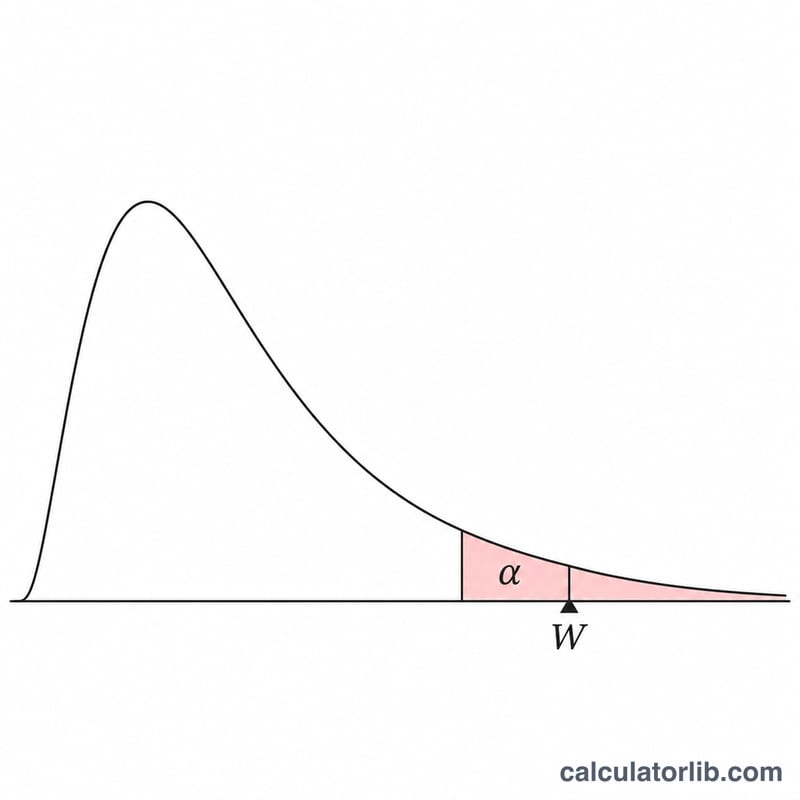
p 值很小,或 W 高於臨界值,代表至少有一組的變異數與其他組不同。p 值很大則表示資料沒有明確證據顯示變異數不相等;但這並不能證明它們相等,尤其在樣本數較少時。中位數變體對偏態資料較為穩健,而平均數變體的表現可能不同,並可能導致不同的判定。當只有兩組時,此檢定等同於對離差進行的雙樣本 t 檢定,且 \(W = t^2\)。檢定結果的可靠度取決於輸入的資料,因此請先檢查是否有輸入錯誤與離群值。
常見問題
我應該選擇哪一種中心?
預設為中位數,因其穩健性佳且檢定力良好,建議優先使用。平均數則可重現原始 Levene 檢定。
各組的樣本數可以不同嗎?
可以。允許各組樣本數不同,但每組至少需要兩個數值。
p 值代表什麼?
它是在所有變異數皆相等的情況下,得到不小於 W 的 F 值之機率。當 p 值小於 alpha 時拒絕虛無假設。
為什麼計算機會顯示統計量無定義?
若每組內的離差完全相同,W 的分母為零,因此無法計算此統計量。
不顯著的結果能證明變異數相等嗎?
不能。它只表示在所選顯著水準下,資料未顯示出顯著差異。
資料來源
- 1.3.5.10. Levene Test for Equality of Variances,NIST/SEMATECH 統計方法電子手冊