莱文检验计算器的功能
莱文检验用于检验两个或多个组是否具有相同的方差,这一条件称为方差齐性。包括方差分析和合并两样本 t 检验在内的许多方法都以此为前提。计算器接收每组的原始数据,计算 W 统计量、自由度、基于 F 分布的上尾 p 值、所选显著性水平下的临界值,并给出拒绝或不拒绝的判定结论。它适用于学生、分析人员和研究人员,可在进一步检验前核实这一假设。
使用方法
在第一个输入框中输入数据。组与组之间用分号分隔,组内数值之间用逗号分隔,例如两组数据输入 6,8,4;12,15,7。每组至少需要两个数值,且所有数据必须为数字。接着选择计算偏差所用的中心:中位数(布朗-福赛斯变体,推荐)或均值(莱文原始方法)。最后设置显著性水平 alpha,取值范围为 0.0001 至 0.5,默认值为 0.05。
公式
每个观测值都被转换为其所在组中心的绝对偏差,W 比较的是这些偏差在组间与组内的离散程度。
$$Z_{ij} = |Y_{ij} - c_i|$$$$W = \frac{N-k}{k-1} \times \frac{\sum_{i=1}^{k} N_i\,(\bar{Z}_i - \bar{Z})^2}{\sum_{i=1}^{k}\sum_{j=1}^{N_i} (Z_{ij} - \bar{Z}_i)^2}$$其中 \(k\) 为组数,\(N_i\) 为第 \(i\) 组的样本量,\(N\) 为观测值总数,\(c_i\) 为组均值或中位数,\(\bar{Z}_i\) 为第 \(i\) 组偏差的均值,\(\bar{Z}\) 为所有偏差的均值。当 \(W > F(\alpha, k-1, N-k)\) 时,拒绝方差相等的原假设。
约定与假设
- 默认中心为中位数,均值可作为选项。由于原始资料未定义修剪规则,因此不提供修剪均值。
- 偶数样本组的中位数为排序后中间两个值的平均值。
- 分子自由度为 \(k-1\),分母自由度为 \(N-k\)。
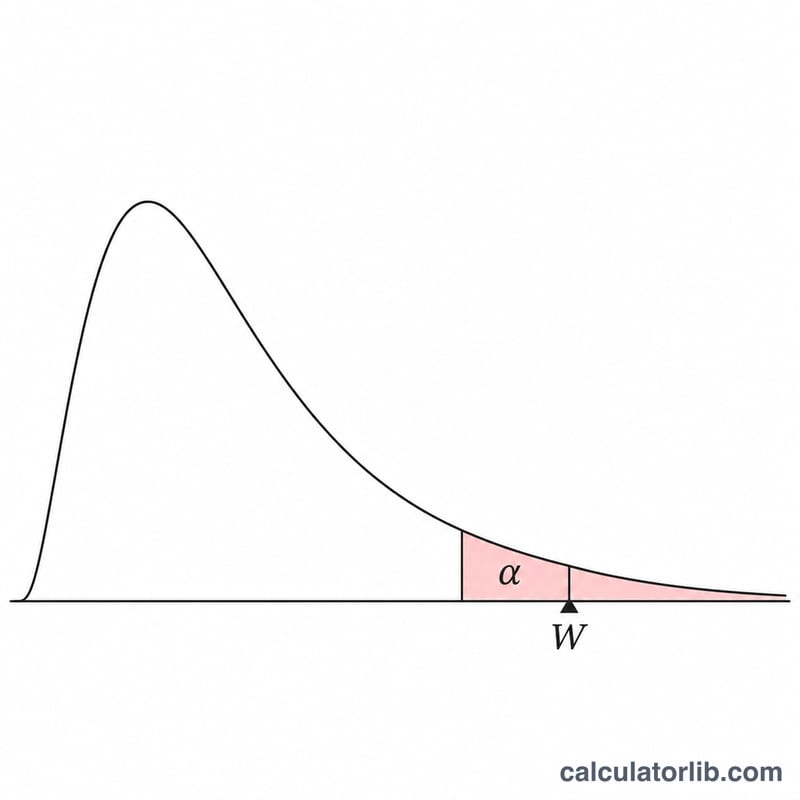
- p 值为上尾概率 \(P(F \ge W)\),通过正则化不完全贝塔函数计算。
- 判定采用严格不等式:W 等于临界值时不拒绝原假设。
- 计算过程中不进行内部取整。W 和 p 值显示到小数点后 6 位,临界值显示到小数点后 4 位。
- 限制条件:2 至 50 组,每组至少 2 个数值,数值总数最多 5000 个。若各组内偏差都不变化,则 W 无定义。
算例
输入三组数据:6,8,4,5,9;12,15,7,20,3;以及 5,6,5,7,6。中心选择中位数,\(\alpha = 0.05\)。于是 \(k = 3\),\(N = 15\)。
$$df_1 = k-1 = 2,\quad df_2 = N-k = 12$$$$W = 5.284768$$$$p = 0.022592,\quad F_{0.05,\,2,\,12} = 3.8853$$由于 \(5.284768 > 3.8853\),等价地 \(p = 0.022592 < 0.05\),因此检验拒绝方差相等的假设。
如何解读结果
p 值较小,或 W 高于临界值,表明至少有一组的方差存在差异。p 值较大则说明数据未提供明显的方差不等证据;但这并不能证明方差相等,尤其是在样本量较小时。中位数变体对偏态数据更稳健,而均值变体的表现可能不同,可能得出另一结论。对于两组数据,该检验等同于对偏差进行的两样本 t 检验,且 \(W = t^2\)。检验结果的可靠性取决于输入数据的质量,因此应先检查输入错误和异常值。
常见问题
应选择哪种中心?
中位数为默认选项,因其稳健性强且检验效能好,故推荐使用。均值则可复现莱文的原始检验。
各组样本量可以不同吗?
可以。允许各组样本量不相等,但每组至少需要两个数值。
p 值是什么意思?
若所有方差都相等,它表示出现不小于 W 的 F 值的概率。当 p 值小于 alpha 时拒绝原假设。
为什么计算器会报告统计量无定义?
如果每组内的偏差都完全相同,W 的分母为零,此时无法计算统计量。
不显著的结果能证明方差相等吗?
不能。它仅表示在所选水平下数据未显示出显著差异。
资料来源
- 1.3.5.10. Levene Test for Equality of Variances,NIST/SEMATECH 统计方法电子手册