レビン検定計算ツールの機能
レビン検定は、2つ以上のグループが同じ分散を持つかどうか、すなわち分散の等質性と呼ばれる条件を確認します。分散分析(ANOVA)やプール化した2標本t検定を含む多くの手法がこの条件を前提としています。この計算ツールは各グループの生データを入力として受け取り、W統計量、自由度、F分布の上側p値、選択した有意水準における臨界値、そして帰無仮説を棄却するかどうかの判定を計算します。さらなる検定の前にこの前提を確認する必要がある学生、アナリスト、研究者に適しています。
使い方
最初の入力欄にデータを入力します。グループはセミコロンで区切り、グループ内の値はカンマで区切ります。例えば2つのグループの場合は 6,8,4;12,15,7 と入力します。各グループには少なくとも2つの値が必要で、すべての項目は数値でなければなりません。次に、偏差の計算に用いる中心を選択します。中央値(ブラウン・フォーサイス法、推奨)または平均(オリジナルのレビン法)から選べます。最後に、0.0001から0.5の間で有意水準αを設定します。既定値は0.05です。
計算式
各観測値は、そのグループの中心からの絶対偏差に変換され、Wはグループ間およびグループ内におけるその偏差のばらつきを比較します。
$$Z_{ij} = |Y_{ij} - c_i|$$$$W = \frac{N-k}{k-1} \times \frac{\sum_{i=1}^{k} N_i\,(\bar{Z}_i - \bar{Z})^2}{\sum_{i=1}^{k}\sum_{j=1}^{N_i} (Z_{ij} - \bar{Z}_i)^2}$$ここで \(k\) はグループ数、\(N_i\) はグループ \(i\) の大きさ、\(N\) は観測値の総数、\(c_i\) はグループの平均または中央値、\(\bar{Z}_i\) はグループ \(i\) における偏差の平均、\(\bar{Z}\) はすべての偏差の平均です。分散が等しいという帰無仮説は、\(W > F(\alpha, k-1, N-k)\) のとき棄却されます。
規則と前提
- 中心は既定では中央値で、オプションとして平均を選べます。トリム平均は提供していません。元の資料でトリムの規則が定義されていないためです。
- 偶数個のグループの中央値は、並べ替えた後の中央の2つの値の平均です。
- 自由度は分子が \(k-1\)、分母が \(N-k\) です。
- p値は上側確率 \(P(F \ge W)\) で、正則化不完全ベータ関数を用いて計算します。
- 判定は厳密な不等式を用います。WがちょうどA臨界値に等しい場合は棄却しません。
- 内部では値を丸めません。Wとp値は小数点以下6桁、臨界値は小数点以下4桁で表示します。
- 制限: グループ数は2から50、各グループは少なくとも2つの値、総値数は最大5000です。グループ内で偏差がすべて同じ場合、Wは定義されません。
計算例
3つのグループを入力します: 6,8,4,5,9; 12,15,7,20,3; 5,6,5,7,6。中心は中央値、\(\alpha = 0.05\) とします。このとき \(k = 3\)、\(N = 15\) です。
$$df_1 = k-1 = 2,\quad df_2 = N-k = 12$$$$W = 5.284768$$$$p = 0.022592,\quad F_{0.05,\,2,\,12} = 3.8853$$\(5.284768 > 3.8853\) であり、同値として \(p = 0.022592 < 0.05\) であるため、この検定では分散が等しいという仮説を棄却します。
結果の読み方
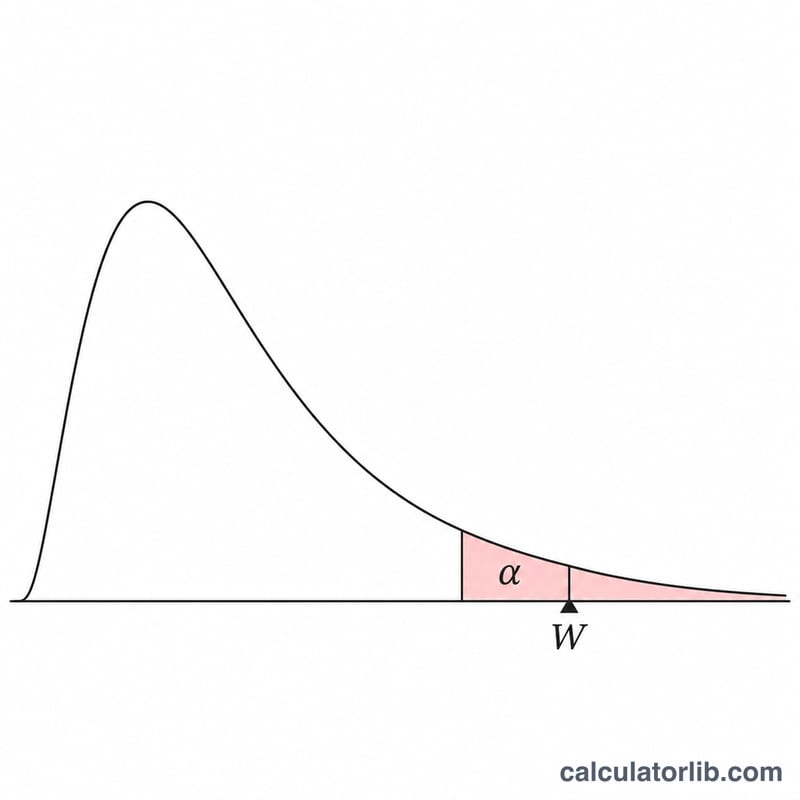
p値が小さい場合、またはWが臨界値を上回る場合は、少なくとも1つのグループで分散が異なることを示す証拠となります。p値が大きい場合は、分散が等しくないという明確な証拠がないことを意味しますが、特に標本が小さいときには分散が等しいことを証明するものではありません。中央値の方法は歪んだデータに対してより頑健ですが、平均の方法は異なる振る舞いをし、別の判定につながることがあります。グループが2つの場合、この検定は偏差に対する2標本t検定と一致し、\(W = t^2\) となります。検定の精度は入力データの質に依存するため、まず入力ミスや外れ値を確認してください。
よくある質問
どの中心を選ぶべきですか?
中央値が既定であり、頑健性と良好な検出力から推奨されます。平均を選ぶと、元のレビン検定を再現できます。
グループの大きさが異なってもよいですか?
はい。各グループに少なくとも2つの値があれば、グループの大きさが異なっても構いません。
p値は何を意味しますか?
すべての分散が等しいと仮定したとき、W以上の大きさのF値が得られる確率です。p値がαより小さい場合は棄却します。
計算ツールが統計量を定義できないと報告するのはなぜですか?
すべてのグループ内の偏差が同一である場合、Wの分母がゼロになり、統計量を計算できません。
有意でない結果は分散が等しいことを証明しますか?
いいえ。選択した水準で有意な差が見られなかったことを意味するにすぎません。
出典
- 1.3.5.10. Levene Test for Equality of Variances、NIST/SEMATECH 統計手法電子ハンドブック