

符号検定計算機の機能
この計算機は、一標本または対応のあるデータに対して正確な符号検定を実行します。各観測値を仮説値と比較し、正の差と負の差の個数を数えて、正確な二項p値を返します。小標本、順序データ、または正規性の仮定が疑わしい場合に適しており、値が仮説値より大きい傾向にあるか小さい傾向にあるかだけを問います。
使い方
検定の種類を選択します:一標本または対応のある二標本。対立仮説を選びます:両側、左側検定(正の値が少ない)、または右側検定(正の値が多い)。標本1の値を、カンマ、セミコロン、スペース、または改行で区切って入力します。対応のある検定では、標本2を同じ個数で同じ順序で入力します。一標本検定の場合は無視されます。仮説値d0(一標本では中央値または平均、対応のあるデータでは差)を入力します。最後に有意水準αを設定します(通常は0.05)。最大1000個の値に対応しています。
計算式
まず差を求めます。対応のある検定の場合:
$$d_i = x_i - y_i - d_0$$一標本の場合は、\(d_i = x_i - d_0\) です。\(R_+\) を \(d_i > 0\) の個数、\(R_-\) を \(d_i < 0\) の個数、\(N = R_+ + R_-\) とします。統計量は、\(p = 0.5\) とした二項累積確率です:
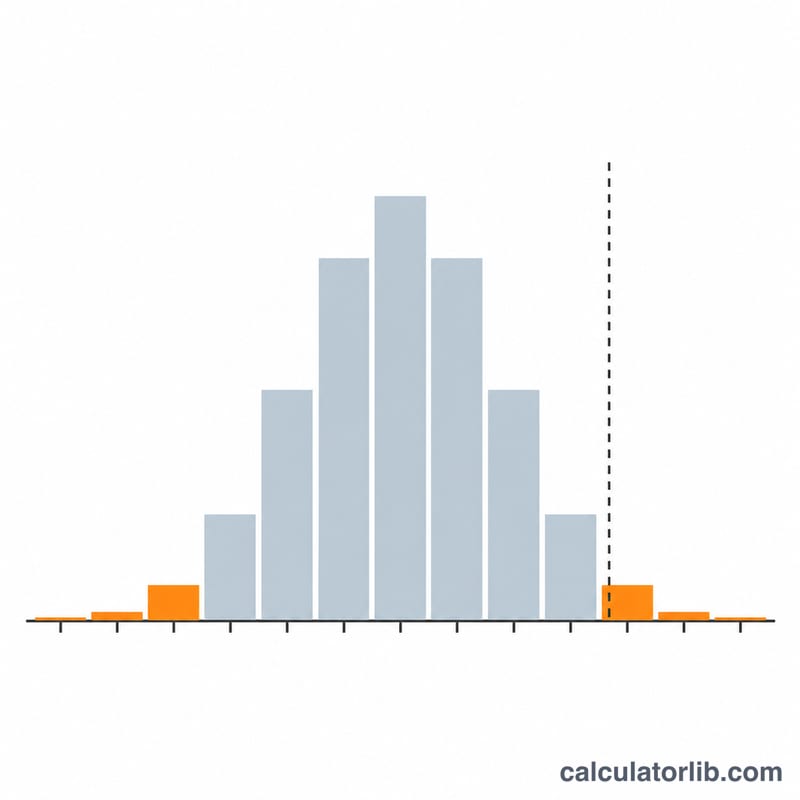
$$S_+ = \sum_{j=0}^{R_+} \binom{N}{j}2^{-N},\quad S_- = \sum_{j=0}^{R_-} \binom{N}{j}2^{-N}$$p値は、左側検定では \(S_+\)、右側検定では \(S_-\) です。両側検定の場合は次のとおりです:
$$p = \min(1,\ 2\min(S_+, S_-))$$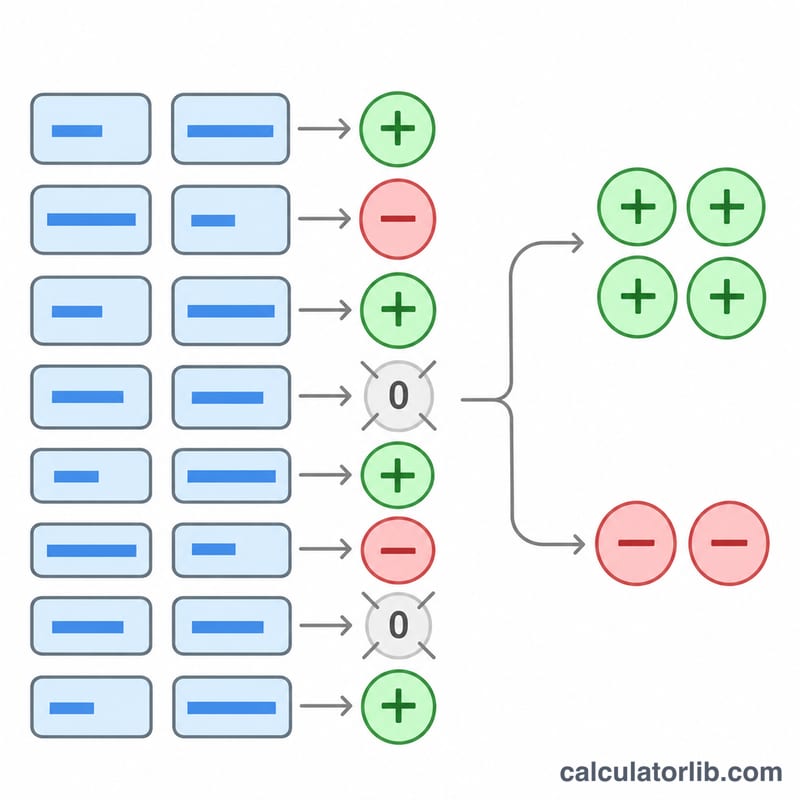
規約と仮定
差がゼロに等しい場合は同順位として除外されるため、\(N = R_+ + R_-\) となります。浮動小数点の減算では微小な誤差が生じることがあるため、絶対値が \(10^{-12}\) 未満の差はゼロとみなします。両側p値は小さい方の裾を2倍し、結果を1で上限とします。この2倍のルールは設計上の選択です。NISTのページには記載されていませんが、公開されている左側および右側の出力とは一致します。正規近似や連続性の補正は提供せず、正確な二項値のみを計算します。選択したp値が有意水準α以下の場合、H0を棄却します。二項分布は離散的であるため、実際の有意水準は一般にαと正確には一致しません。すべての差が同順位の場合、検定は計算できません。
計算例
一標本検定で、標本は141、138、144、139、145、137、142、146、140、143、仮説値 \(d_0 = 140\)、両側検定、\(\alpha = 0.05\) とします。差から \(R_+ = 6\)、\(R_- = 3\)、同順位が1個(値140)となるため、\(N = 9\) です。
$$S_+ = 0.91015625,\quad S_- = 0.25390625$$$$p = \min(1,\ 2 \times 0.25390625) = 0.5078125$$\(0.5078 > 0.05\) のため、H0は棄却されません。
結果の読み方
p値が小さい場合は、正の差と負の差の割合が等確率であった場合には起こりにくいことを意味します。上記のように p値が大きい場合は、データに一貫した方向性が見られないことを意味します。この検定は差の大きさを考慮しないため、大きさを用いる検定よりも検出力が低くなります。同順位を除外するとNが小さくなり、検出力も低下します。H0を棄却しないことは、H0が真であることの証明ではありません。
よくある質問
符号検定はどのような仮定を置いていますか?
観測値は互いに独立しており、各差は仮説値より大きいか小さいかのいずれかです。H0のもとで、正の符号の個数は二項分布Binomial(N, 0.5)に従います。
同順位を除外するのはなぜですか?
差がゼロの場合は方向性を持たないためです。NIST Dataplotの慣例に従い、同順位は除外され、有効標本サイズは小さくなります。
対応のあるオプションはいつ使うべきですか?
介入前後の測定値や対応のあるペアに使用します。計算機は標本2を標本1から引き、その後d0を引きます。
両側p値が1になることがあるのはなぜですか?
符号がほぼ均衡している場合、小さい方の裾を2倍すると1を超えることがあるため、1で上限とします。
大標本には正規近似が使われますか?
いいえ。Nが1000までの任意の値に対して、正確な二項和を計算します。
出典
- Dataplot SIGN TEST コマンド、NIST/SEMATECH Dataplot、2023年
















