

符號檢定計算機的功能
本計算機對單一樣本或成對資料執行精確符號檢定。它將每個觀測值與假設值比較,計算差值為正與為負的個數,並回傳精確的二項式 p 值。它適用於小樣本、順序資料,或常態假設存疑的情況,且只判斷數值傾向高於或低於假設值。
使用方法
選擇檢定類型:單一樣本或成對雙樣本。選擇對立假設:雙尾、左尾(正值較少)或右尾(正值較多)。輸入樣本 1 的數值,並以逗號、分號、空格或換行分隔。若為成對檢定,請輸入樣本 2,其數量須與樣本 1 相同且順序一致;單一樣本檢定則忽略此欄。輸入假設值 d0(單一樣本為中位數或平均數,成對資料為差值)。最後設定顯著水準 alpha,通常為 0.05。最多支援 1000 個數值。
公式
首先計算差值。成對檢定時:
$$d_i = x_i - y_i - d_0$$單一樣本時,\(d_i = x_i - d_0\)。令 \(R_+\) 為 \(d_i > 0\) 的個數,\(R_-\) 為 \(d_i < 0\) 的個數,且 \(N = R_+ + R_-\)。統計量為 \(p = 0.5\) 時的二項式累積機率:
$$S_+ = \sum_{j=0}^{R_+} \binom{N}{j}2^{-N},\quad S_- = \sum_{j=0}^{R_-} \binom{N}{j}2^{-N}$$左尾檢定的 p 值為 \(S_+\),右尾檢定為 \(S_-\);雙尾檢定則為:
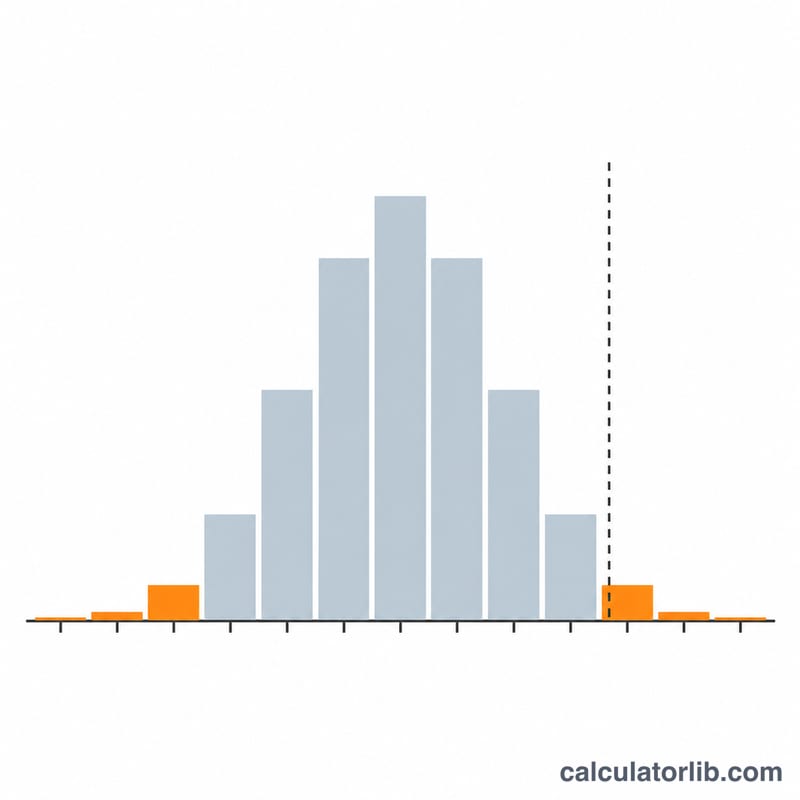
$$p = \min(1,\ 2\min(S_+, S_-))$$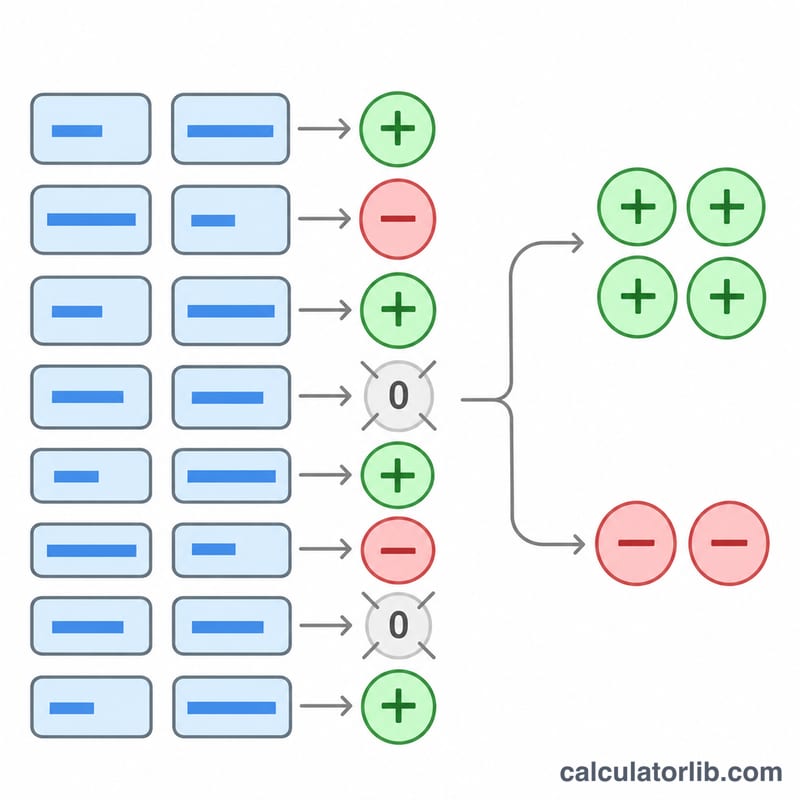
慣例與假設
差值等於零者為平手,予以排除,因此 \(N = R_+ + R_-\)。由於浮點數減法可能產生極小的殘差,當差值的絕對值小於 \(10^{-12}\) 時,視為零。雙尾 p 值將較小的尾端機率加倍,並將結果上限設為 1;此加倍規則屬於設計選擇,NIST 頁面並未列出,但與其公布的左尾與右尾輸出一致。本計算機不提供常態近似或連續性校正,僅計算精確的二項式值。當所選 p 值不大於 alpha 時,拒絕 H0。由於二項式分配為離散分配,所達到的顯著水準通常不會恰好等於 alpha。若所有差值皆為平手,則無法進行檢定。
範例說明
單一樣本檢定,樣本為 141、138、144、139、145、137、142、146、140、143,假設值 \(d_0 = 140\),雙尾,\(\alpha = 0.05\)。差值得出 \(R_+ = 6\)、\(R_- = 3\),以及一個平手(數值 140),因此 \(N = 9\)。
$$S_+ = 0.91015625,\quad S_- = 0.25390625$$$$p = \min(1,\ 2 \times 0.25390625) = 0.5078125$$由於 \(0.5078 > 0.05\),不拒絕 H0。
如何解讀結果
若正負差值的分配情況在正負機率相等的假設下極不可能出現,則 p 值會很小。如上例,較大的 p 值表示資料並未呈現一致的方向。本檢定忽略差值的大小,因此檢定力低於使用量值的檢定。捨棄平手值會減少 N,進而降低檢定力。不拒絕 H0 並不證明其為真。
常見問題
符號檢定的假設是什麼?
觀測值彼此獨立,且每個差值不是高於就是低於假設值。在 H0 成立下,正號個數服從 Binomial(N, 0.5) 分配。
為什麼要捨棄平手值?
零差值不具方向性。依循 NIST Dataplot 慣例,平手值予以排除,有效樣本數隨之減少。
何時應使用成對選項?
適用於前後測量或配對資料。計算機會先以樣本 1 減去樣本 2,再減去 d0。
為什麼雙尾 p 值有時為 1?
當正負號幾乎平衡時,將較小尾端加倍可能超過 1,因此上限設為 1。
大樣本是否使用常態近似?
否。對於不超過 1000 的任何 N,都會計算精確的二項式總和。
資料來源
- Dataplot SIGN TEST command,NIST/SEMATECH Dataplot,2023
















