本計算機的功能
本計算機會在您指定的落後期 k,計算有序資料序列的樣本自我相關係數。自我相關衡量每個觀測值與 k 步之後的數值有多密切相關。它常用於檢定隨機性、找出時間序列中的趨勢或週期,以及檢視配適模型後的殘差。計算結果也會顯示樣本數、平均值、約 95% 的範圍帶,以及結果是否超出該範圍的標記。
使用方法
請在資料序列欄位中依時間順序輸入數值,數值之間可用逗號、分號、空格或換行分隔,小數點請使用句點。接著輸入整數落後期 k,其值必須至少為 1 且至多為 N-1。最後選擇要計算的落後期:只計算落後期 k,或計算從 0 到 k 的每個落後期。在全部落後期模式下,落後期表會列出每個落後期及其係數。
公式
落後 k 期的自我相關係數依循 NIST/SEMATECH 的定義:
$$r_k = \frac{\sum_{i=1}^{N-k}(Y_i - \bar{Y})(Y_{i+k} - \bar{Y})}{\sum_{i=1}^{N}(Y_i - \bar{Y})^2}$$其中 \(Y_i\) 為第 i 個觀測值,\(N\) 為觀測值數量,\(k\) 為落後期,\(\bar{Y}\) 為全部 N 個數值的平均值。在隨機情況下,約 95% 的範圍帶為:
$$\pm\frac{1.96}{\sqrt{N}}$$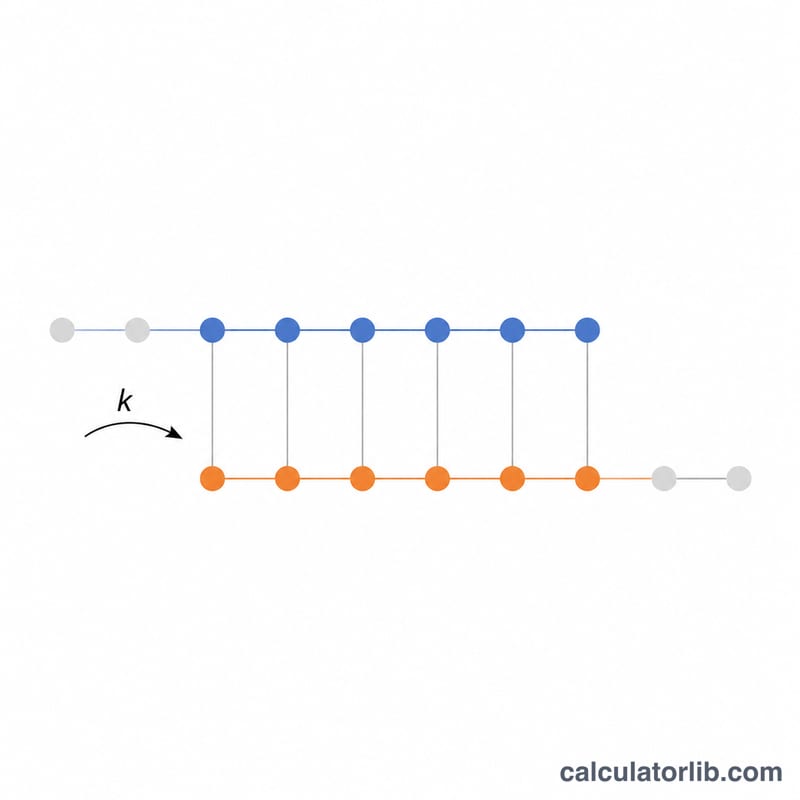
慣例與假設
- 分子為 i = 1 至 N-k 的乘積和。分母為 i = 1 至 N 的離均差平方和。平均值取自完整樣本,且不進行 N/(N-k) 的調整。
- 在落後期 0 時,只要變異數不為零,係數即為 1。
- 觀測值視為等間距,並依輸入順序使用。時間變數不是輸入項目。
- 落後期必須為 1 至 N-1 之間的整數。全部落後期模式會回傳落後期 0 至 k 的結果。
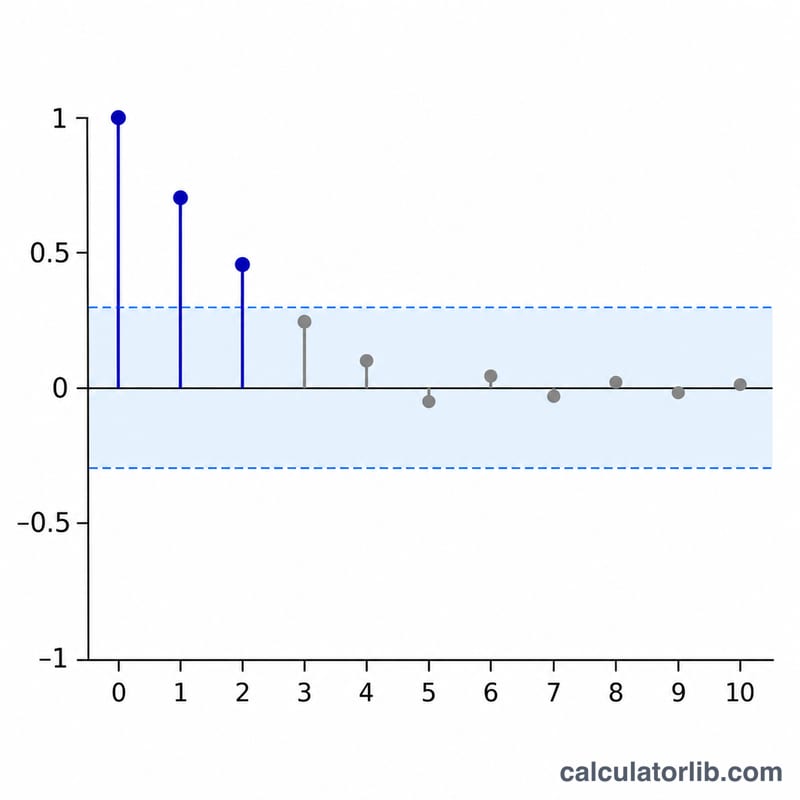
- 範圍帶 1.96/√N 採用標準常態分配的 97.5% 分位數。這是本計算機的設計選擇,並非 NIST 頁面上列出的數值。當 |r_k| 超過範圍帶時,該落後期會被標記。
- 計算使用完整精度,顯示結果則四捨五入至小數點後 4 位。
計算範例
序列為 3 5 4 6 8 7 9 12 10 11,在單一落後期模式下 k = 1。樣本數為 \(N = 10\),平均值為:
$$\bar{Y} = 7.5$$落後 1 期的自我相關係數為:
$$r_1 = 0.6091$$範圍帶為:
$$\frac{1.96}{\sqrt{10}} = 0.6198$$由於 \(0.6091 < 0.6198\),結果未超出範圍帶,因此標記為否。落後期表只顯示一行:1:0.6091。
結果解讀與限制
接近 +1 的數值表示高值傾向接續高值、低值接續低值。接近 -1 的數值表示數值交替出現。接近 0 的數值則顯示在該落後期的線性相依性很小。若係數超出範圍帶,在純粹隨機的情況下不太可能出現,但此範圍帶只是近似值,在 N 較大時效果最好。若序列很短,例如上述 10 個數值,估計結果會有較大雜訊。強烈趨勢會使許多落後期的自我相關係數被放大。同時檢定大量落後期也會因偶然因素產生一些誤判標記。常數序列會被拒絕,因為分母為零。
常見問題
r_k 可以大於 1 嗎?
不行。依照此定義,|r_k| 永遠不超過 1。
為什麼落後期 0 的值一定是 1?
在落後期 0 時,分子與分母相等,因此只要變異數不為零,比值就是 1。
允許的最大落後期是多少?
落後期最多為 N-1。在該落後期只會使用一個乘積項,因此估計值非常不可靠。
為什麼會拒絕常數序列?
所有與平均值的離差都為零,因此分母為零,自我相關係數無定義。
計算機會使用時間戳記嗎?
不會。系統假設數值為等間距,並依輸入順序使用。
95% 範圍帶是精確值嗎?
不是。它是在隨機假設下、以常態分配為基礎的近似值。