本计算器的功能
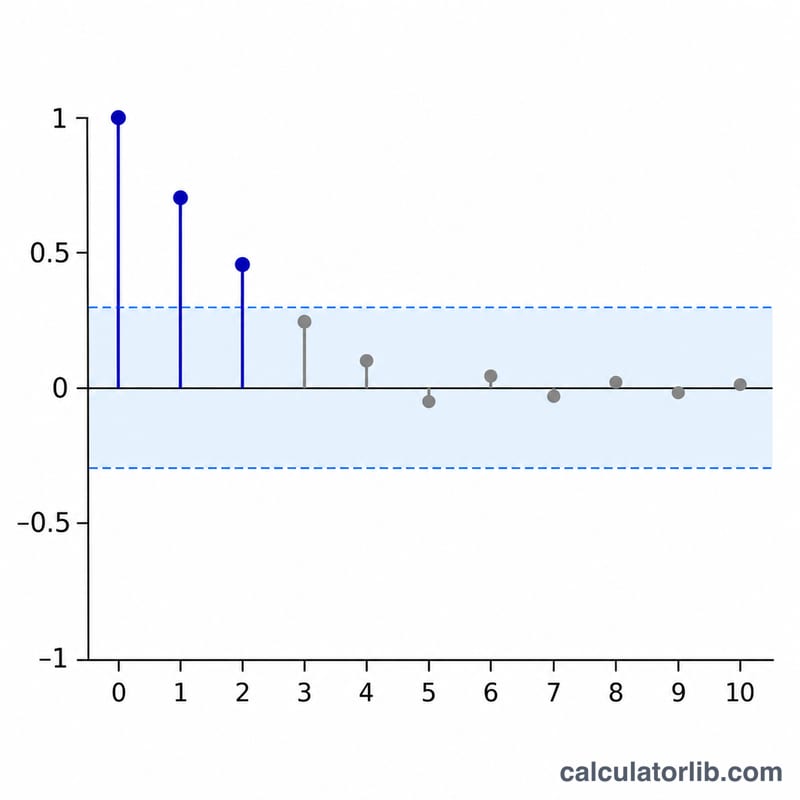
本计算器用于计算有序数据序列在所选滞后k处的样本自相关系数。自相关衡量每个观测值与其之后第k步的值之间的关联强度。它常用于检验随机性、识别时间序列中的趋势或周期,以及检查拟合模型的残差。结果还会给出样本量、均值、近似95%置信带,以及结果是否超出该置信带的标识。
使用方法
在数据序列字段中按时间顺序输入数值,数值之间可用逗号、分号、空格或换行分隔,小数点使用句点。然后输入整数滞后k,其必须至少为1且至多为N-1。最后选择要计算的滞后:仅计算滞后k,或计算从0到k的每个滞后。在全部滞后模式下,滞后表会列出每个滞后及其系数。
公式
滞后k自相关系数遵循 NIST/SEMATECH 的定义:
$$r_k = \frac{\sum_{i=1}^{N-k}(Y_i - \bar{Y})(Y_{i+k} - \bar{Y})}{\sum_{i=1}^{N}(Y_i - \bar{Y})^2}$$其中 \(Y_i\) 为第 i 个观测值,\(N\) 为观测值个数,\(k\) 为滞后阶数,\(\bar{Y}\) 为全部 N 个值的均值。随机条件下的近似95%置信带为:
$$\pm\frac{1.96}{\sqrt{N}}$$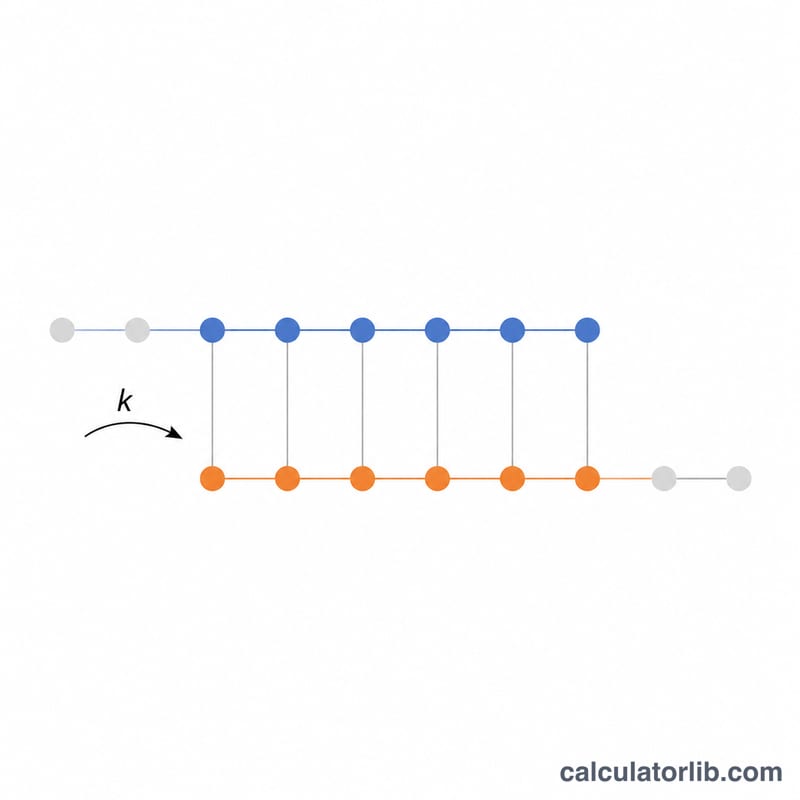
约定与假设
- 分子对 i = 1 至 N-k 的乘积求和。分母对 i = 1 至 N 的离差平方求和。均值取自完整样本,不进行 N/(N-k) 的修正。
- 当方差非零时,滞后0处的系数为1。
- 观测值视为等间隔,并按输入顺序使用。时间变量不作为输入项。
- 滞后必须为1至N-1之间的整数。全部滞后模式返回从0到k的所有滞后。
- 置信带1.96/√N采用标准正态分布的97.5%分位数。这是本计算器的设计选择,并非 NIST 页面中给出的数值。当|r_k|超过该置信带时,该滞后被标记。
- 计算使用完整精度,显示结果保留4位小数。
计算示例
序列为 3 5 4 6 8 7 9 12 10 11,单一滞后模式下 k = 1。样本量为 \(N = 10\),均值为:
$$\bar{Y} = 7.5$$滞后1自相关系数为:
$$r_1 = 0.6091$$置信带为:
$$\frac{1.96}{\sqrt{10}} = 0.6198$$由于 \(0.6091 < 0.6198\),结果未超出置信带,因此标识为否。滞后表仅显示一行:1:0.6091。
结果解读与局限性
数值接近+1表示高值往往后接高值,低值往往后接低值。数值接近-1表示交替出现的规律。数值接近0则表明该滞后处线性相关性很弱。在纯随机条件下,超出置信带的系数不太可能出现,但该置信带只是近似值,在样本量适中且较大时效果最好。对于短序列(例如上面的10个值),估计结果噪声较大。强趋势会使许多滞后处的自相关系数被放大。同时检验大量滞后也会因偶然性产生一些误报。常数序列会被拒绝,因为分母为零。
常见问题
r_k 可以大于1吗?
不可以。按照本定义,|r_k| 始终不超过1。
为什么滞后0总是等于1?
在滞后0处,分子与分母相等,因此当方差非零时比值为1。
允许的最大滞后是多少?
滞后最大为N-1。在该滞后处只使用一个乘积项,因此估计结果非常不可靠。
为什么拒绝常数序列?
所有值与均值的离差均为零,因此分母为零,自相关系数无定义。
计算器是否使用时间戳?
不使用。系统假定数值等间隔,并按输入顺序使用。
95%置信带是精确值吗?
不是。它是基于正态分布、在随机条件下的近似值。