本計算器的功能
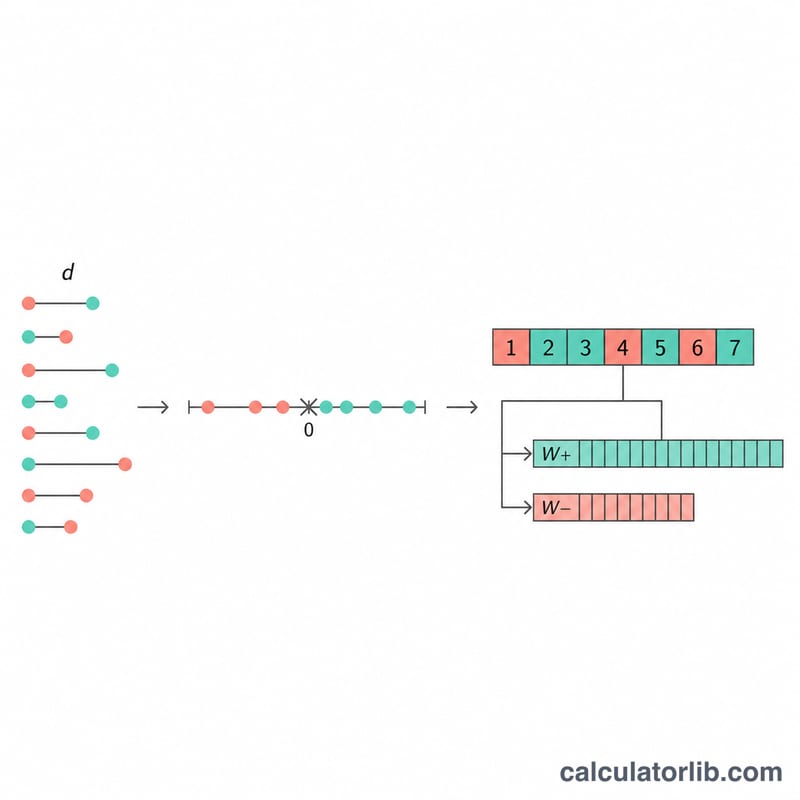
本計算器可對單一樣本或成對樣本執行 Wilcoxon 符號秩檢定。它會計算差值、排除零值、依絕對值排序差值(同分者取平均秩次),並輸出 W+、W-、檢定統計量 W、常態近似 Z、p 值及判定結果。當常態性存疑時,它適合作為單一樣本或成對 t 檢定的無母數替代方法,供學生與分析人員使用。
使用方式
以逗號、分號、空白或換行分隔,輸入樣本 X 的數值。若進行成對檢定,請以相同順序與數量輸入樣本 Y;若進行單一樣本檢定,則輸入一個 -。設定假設值或差值 d0(通常為 0)。選擇對立假設:雙尾、大於或小於。選取顯著水準 alpha。
公式
先計算每個差值,再依絕對值排序:
$$d_i = x_i - y_i - d_0 \qquad (\text{單一樣本:} d_i = x_i - d_0)$$
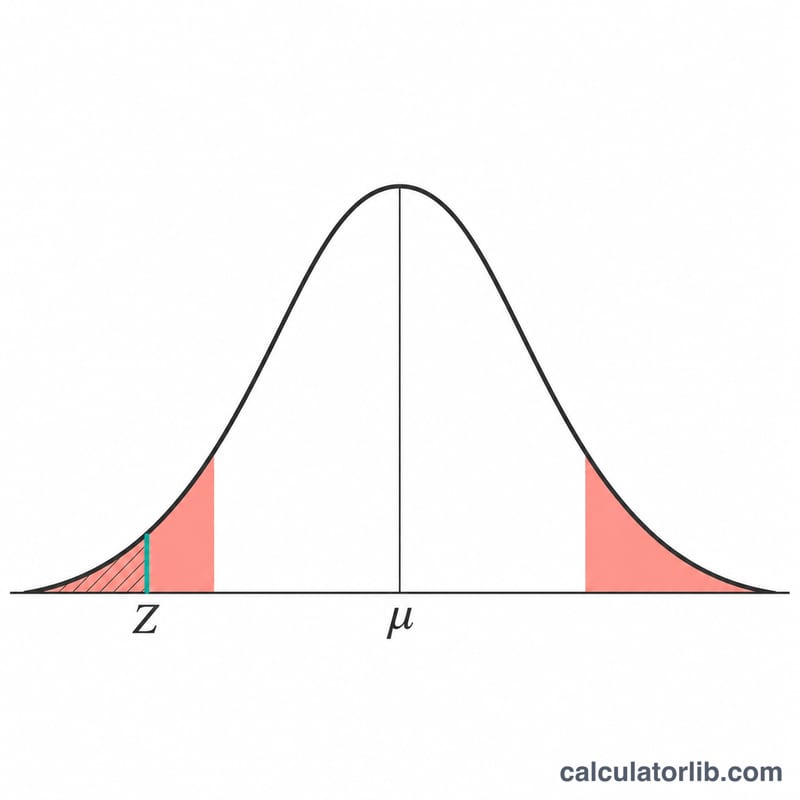
$$W = \min(W^+, W^-), \quad \mu_W = \frac{n(n+1)}{4}, \quad \sigma_W = \sqrt{\frac{n(n+1)(2n+1)}{24}}, \quad Z = \frac{W - \mu_W}{\sigma_W}$$
其中 \(W^+\) 與 \(W^-\) 分別為正差值與負差值的秩次總和,\(n\) 為非零差值的個數。雙尾 p 值為 \(p = \min(1, 2\Phi(Z))\)。對於大於的對立假設,\(Z\) 使用 \(W^+\),且 \(p = 1 - \Phi(Z)\);對於小於的對立假設,則 \(p = \Phi(Z)\)。
慣例與假設
- 等於零的差值在排序前會被省略,且會先將每個差值四捨五入至小數點後 10 位,使浮點數雜訊被視為零。
- 同分的絕對差值會取其所占秩次的平均值。
- 無論 n 為多少,皆使用常態近似,且不進行同分校正與連續性校正。當 n 為 30 或以下時會顯示警告。
- 當 p 小於 alpha 時,拒絕虛無假設。
- 假設各差值彼此獨立、以中位數對稱,且至少為等距尺度量測。
- 常態累積分布函數是以高精度互補誤差函數計算。
計算範例
單一樣本檢定,X = 1.2, -0.5, 2.3, 0.8, 1.9, -0.3, 1.1, 2.6,\(d_0 = 0\),雙尾,\(\alpha = 0.05\)。沒有零差值,因此 \(n = 8\),其中正差值 6 個、負差值 2 個。
$$W^+ = 33, \quad W^- = 3, \quad W = 3$$
$$\mu_W = \frac{8 \times 9}{4} = 18, \quad \sigma_W = \sqrt{\frac{8 \times 9 \times 17}{24}} = 7.1414$$
$$Z = \frac{3 - 18}{7.1414} = -2.1004, \quad p = 2\Phi(-2.1004) = 0.0357$$
由於 0.0357 小於 0.05,判定為拒絕。因為 n 為 8,小樣本警告成立。
結果解讀與限制
p 值較小表示,若虛無假設成立,這些差值不太可能以 d0 為中心。p 值較大則表示資料並未顯示足夠證據證明位置有偏移,但這並不能證明沒有偏移。當 n 為 30 或以下時,通常應以精確表格或精確 p 值為參考,因此此處的常態近似可能與其有所差異,尤其是在同分很多的情況下,因為標準差未進行同分校正。若所有差值皆為零,則無法計算此檢定。
常見問題
何時應使用此方法而非 t 檢定?
當差值不服從常態分布,但大致呈對稱,或資料僅屬順序型且差值的秩次具有意義時,請使用此方法。
如何處理零差值?
零差值會被移除,n 也會相應減少。系統會回報被省略的零差值數量。
如何處理同分?
同分的絕對差值會共用其秩次的平均值,因此秩次總和可能出現半整數。
為什麼雙尾 Z 永遠不會為正?
Z 是以 W 計算,而 W 為 W+ 與 W- 之中較小者,不會超過平均值。若 W+ 等於 W-,則雙尾 p 值為 1。
小樣本的 p 值是精確的嗎?
不是。這是常態近似值,當 n 為 30 或以下時會顯示警告。
資料來源
- Signed Rank Test (Dataplot reference manual),NIST/SEMATECH Dataplot,2023