

フリードマン検定計算機の機能
この計算機は、k 個の処理がそれぞれ b 個のブロック(例:被験者、ロット、日など)内で測定されたとき、処理の効果が同一かどうかを検定します。反復測定分散分析の順位ベースのノンパラメトリックな代替手法です。各ブロック内で値を順位付けし、処理ごとに順位の合計を求めて、フリードマン統計量 T1、Conover 統計量 T2、両方の p 値、臨界値、そして棄却または非棄却の判定を返します。
使い方
データ表は 1 行に 1 ブロック、1 列に 1 処理の形式で入力します。値はカンマ、セミコロン、スペース、タブで区切ってください。小数点にはピリオドを使います。各行の値の数は同じである必要があり、少なくとも 2 ブロックと 2 処理が必要です。次に有意水準 alpha(10%、5%、2.5%、1%)と、判定に用いる参照分布を選択します。参照分布は F 分布(Conover T2、デフォルトかつ推奨)またはカイ二乗分布(T1)です。
計算式
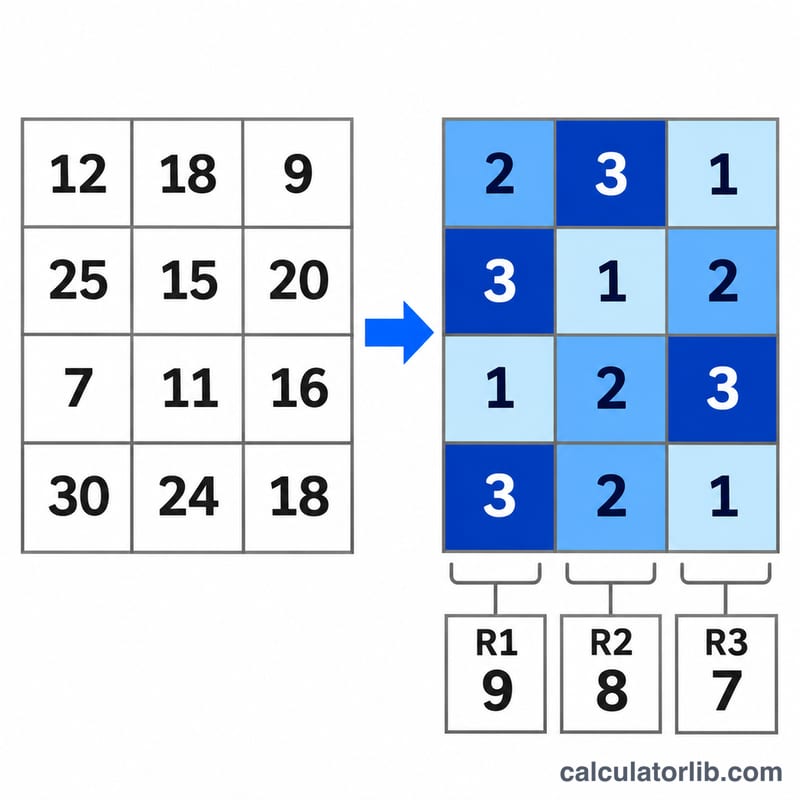
各ブロック内で値を順位付けし、\(R_j\) を処理 j の順位の合計とします。
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(同順位なし)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(同順位あり)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
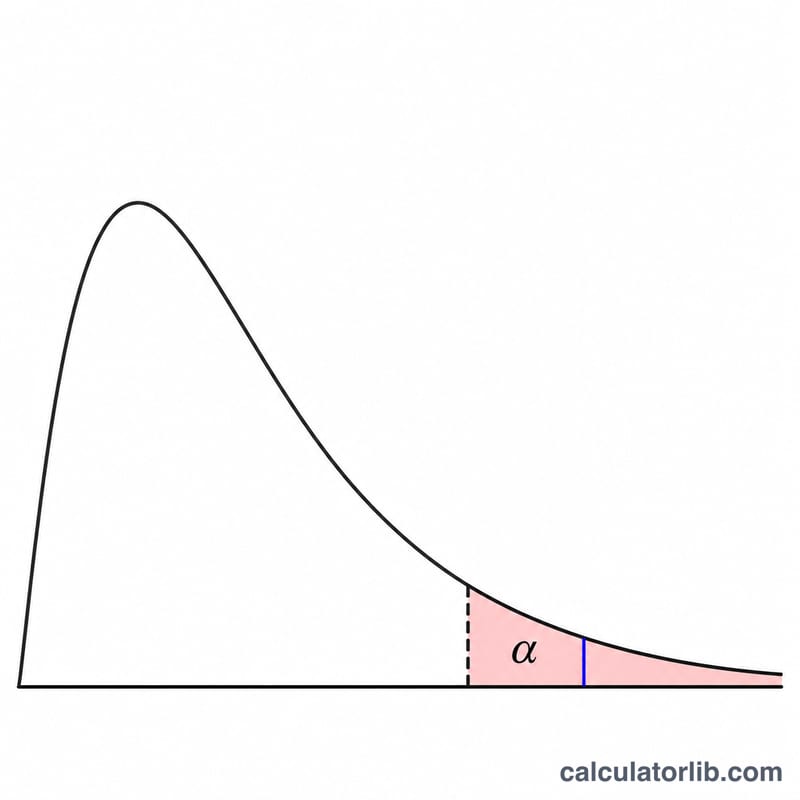
ここで \(b\) はブロック数、\(k\) は処理数、\(A_1\) は全順位の二乗和、\(C_1\) は補正係数です。T1 は自由度 \(k-1\) のカイ二乗分布と比較します。T2 は自由度 \(k-1\) および \((b-1)(k-1)\) の F 分布と比較します。
規約と前提
- 順位付けは各ブロック内で昇順に行い、最小値の順位は 1 です。同順位の値には、それらが占める順位の平均が与えられます。並べる方向は統計量を変えません。
- いずれかのブロックに同順位がある場合は、同順位補正を施した T1 を用います。同順位がない場合、両方の式は同一になります。
- T2 は、その F 近似が T1 のカイ二乗近似よりも通常は正確であるため、推奨される統計量です。
- p 値は上側確率です。統計量が臨界値を厳密に上回る場合(p 値が alpha 未満の場合)にのみ H0 を棄却します。等しい場合は非棄却です。
- 連続性の補正は適用しません。
- T1 が b(k-1) に等しい場合、すべてのブロックで処理の順序が同一であり、T2 は無限大となり、F の p 値は 0 となって H0 は棄却されます。
- すべてのブロックのすべての値が等しい場合、統計量は定義されず、エラーが返されます。
- 検定後の多重比較は含まれません。
計算例
データは b = 6 ブロック、k = 3 処理で、alpha = 0.05、参照分布は F です。各行は 4 5 3、6 7 5、8 6 9、5 7 4、7 9 6、3 6 5 です。各行内で順位付けすると、順位の合計は 11、16、9 になります。
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4.33333,\qquad T_2=\frac{(6-1)\times 4.33333}{6\times 2-4.33333}=2.82609$$
自由度 2 および 10 の F 検定の p 値は 0.10645、臨界値は 4.103 です。T1 のカイ二乗検定の p 値は 0.11456 です。2.82609 は 4.103 を下回るため(p = 0.10645 は 0.05 を上回る)、判定は H0 を棄却しない、です。
結果の読み方
p 値が小さい場合は、少なくとも 1 つの処理がブロック内で他より高く、または低く順位付けされやすいことを示唆します。p 値が大きい場合は、データに一貫した処理効果が見られないことを意味しますが、処理が等しいことを証明するものではありません。この検定は、どの処理間に差があるかについては何も述べません。ブロック数が少ない場合はカイ二乗近似の信頼性が下がります。これが T2 がデフォルトである理由の一つです。欠損値には対応していないため、すべてのブロックが完全である必要があります。
よくある質問
フリードマン検定はいつ使うべきですか?
同じ対象が複数の条件下で測定され、データが順序尺度であるか正規分布に従わず、反復測定分散分析が適さない場合に使用します。
p 値が 2 つあるのはなぜですか?
T1 は近似的なカイ二乗分布に従い、T2 は一般により正確な近似的 F 分布に従います。判定には選択した方の p 値が使われます。
同順位はどのように扱われますか?
同順位の値は、それらの順位の平均を共有し、T1 は同順位補正を施した形式に切り替わります。
順位付けの方向は重要ですか?
いいえ。降順で順位付けしても同じ統計量が得られます。
T2 が無限大になるとはどういう意味ですか?
すべてのブロックが処理を同じ順序で順位付けした場合に発生します。このとき F の p 値は 0 となり、H0 は棄却されます。
出典
- Dataplot FRIEDMAN TEST、NIST/ITL、2023
















