

弗里德曼检验计算器的功能
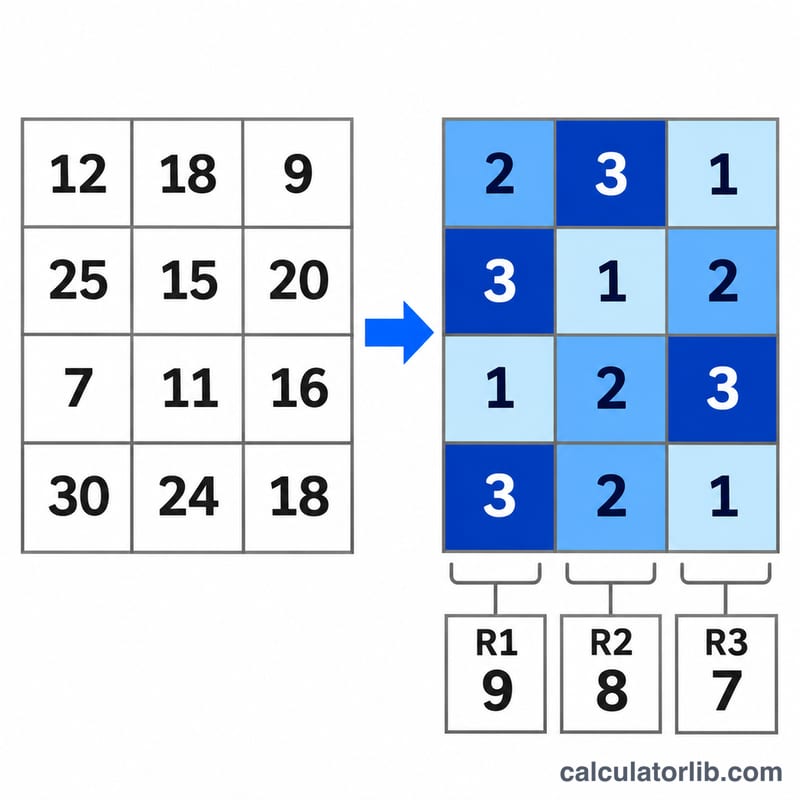
本计算器用于检验在 b 个区组(例如受试者、批次或天数)中每个区组内都测量了 k 个处理时,这些处理的效应是否相同。它是重复测量方差分析的一种基于秩的非参数替代方法。计算器会在每个区组内对数值排秩,汇总每个处理的秩和,并返回弗里德曼统计量 T1、Conover 统计量 T2、两个 p 值、临界值以及拒绝或不拒绝的判定结果。
使用方法
请以每行一个区组、每列一个处理的形式输入数据表。数值之间可用逗号、分号、空格或制表符分隔,小数点请使用句点。每行的数值个数必须相同,且至少有 2 个区组和 2 个处理。然后选择显著性水平 alpha(10%、5%、2.5% 或 1%),以及用于判定的参考分布:F 分布(Conover T2,默认且推荐的选项)或卡方分布(T1)。
公式
在每个区组内对数值排秩,\(R_j\) 为处理 j 的秩和。
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(无相同秩)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(有相同秩)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
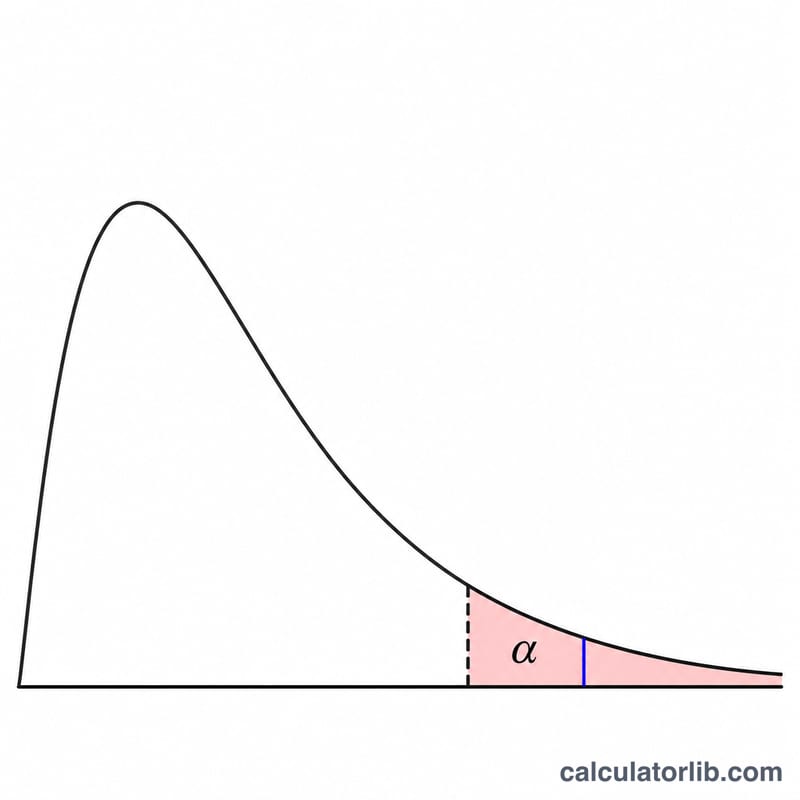
其中 \(b\) = 区组数,\(k\) = 处理数,\(A_1\) = 所有秩的平方和,\(C_1\) = 校正因子。T1 与自由度为 \(k-1\) 的卡方分布比较;T2 与自由度为 \(k-1\) 和 \((b-1)(k-1)\) 的 F 分布比较。
约定与假设
- 每个区组内按升序排秩,最小值的秩为 1。相同值取其所跨秩的平均值。排序方向不会改变统计量。
- 若任一区组存在相同值,则使用经相同秩校正的 T1。若无相同值,两种形式结果完全一致。
- T2 是首选统计量,因为其 F 近似通常比 T1 的卡方近似更准确。
- p 值为上尾概率。只有当统计量严格大于临界值(p 小于 alpha)时才拒绝 H0;相等则判定为不拒绝。
- 不应用连续性校正。
- 若 T1 等于 b(k-1),则所有区组对处理的排序完全相同,T2 为无穷大,F 检验 p 值为 0,拒绝 H0。
- 若每个区组中的所有值都相等,统计量无定义,将返回错误。
- 检验之后的多重比较不包含在内。
示例
数据包含 b = 6 个区组和 k = 3 个处理,alpha = 0.05,参考分布为 F。各行数据为 4 5 3、6 7 5、8 6 9、5 7 4、7 9 6 和 3 6 5。在每行内排秩后,秩和分别为 11、16 和 9。
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4.33333,\qquad T_2=\frac{(6-1)\times 4.33333}{6\times 2-4.33333}=2.82609$$
自由度为 2 和 10 的 F 检验 p 值为 0.10645,临界值为 4.103。T1 的卡方检验 p 值为 0.11456。由于 2.82609 小于 4.103(p = 0.10645 大于 0.05),判定结果为不拒绝 H0。
如何解读结果
较小的 p 值表明,至少有一个处理在区组内的秩往往高于或低于其他处理。较大的 p 值则说明数据未显示出一致的处理效应;这并不能证明各处理相等。该检验不能说明哪些处理之间存在差异。区组数较少时,卡方近似的可靠性较差,这也是 T2 作为默认选项的原因之一。不支持缺失值,因此每个区组必须数据完整。
常见问题
何时应使用弗里德曼检验?
当同一研究对象在多种条件下被测量,且数据为有序数据或不服从正态分布,因而不适合使用重复测量方差分析时,应使用该检验。
为什么有两个 p 值?
T1 近似服从卡方分布,而 T2 近似服从 F 分布,后者通常更为准确。判定结果使用您所选的那个统计量。
如何处理相同值?
相同值共享其秩的平均值,并且 T1 切换为经相同秩校正的形式。
排序方向是否重要?
不重要。按降序排秩得到的统计量相同。
T2 为无穷大意味着什么?
这发生在每个区组对处理的排序完全相同时。此时 F 检验 p 值为 0,拒绝 H0。
来源
- Dataplot FRIEDMAN TEST,NIST/ITL,2023
















