

Máy tính kiểm định Friedman làm gì
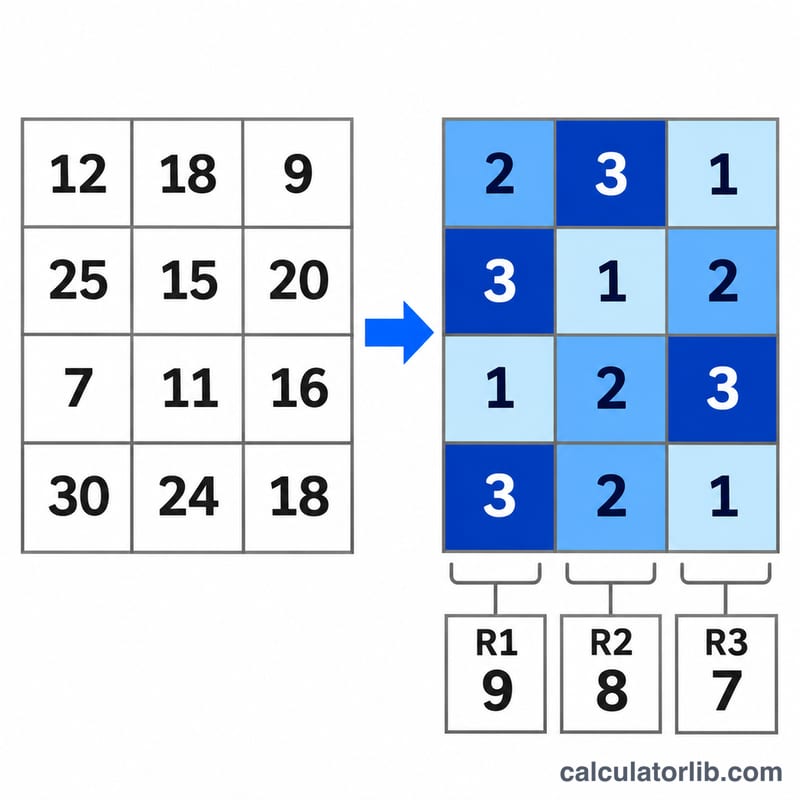
Máy tính này kiểm tra xem k phương pháp xử lý có tác động giống nhau hay không khi mỗi phương pháp được đo trong từng khối trong số b khối (ví dụ: đối tượng, mẻ hoặc ngày). Đây là phương pháp phi tham số dựa trên thứ hạng, là lựa chọn thay thế cho phân tích phương sai lặp lại (ANOVA lặp lại). Máy tính xếp hạng các giá trị trong mỗi khối, cộng các thứ hạng cho từng phương pháp, và trả về thống kê Friedman T1, thống kê Conover T2, cả hai giá trị p, giá trị tới hạn và quyết định bác bỏ hoặc không bác bỏ.
Cách sử dụng
Nhập bảng dữ liệu với mỗi dòng là một khối và mỗi cột là một phương pháp xử lý. Phân tách các giá trị bằng dấu phẩy, dấu chấm phẩy, khoảng trắng hoặc tab, và dùng dấu chấm làm dấu thập phân. Mỗi dòng phải có cùng số giá trị, với ít nhất 2 khối và 2 phương pháp xử lý. Sau đó chọn mức ý nghĩa alpha (10%, 5%, 2,5% hoặc 1%) và phân phối tham chiếu để ra quyết định: F (Conover T2, mặc định và là lựa chọn được ưu tiên) hoặc chi-bình phương (T1).
Công thức
Trong mỗi khối, các giá trị được xếp hạng và \(R_j\) là tổng thứ hạng của phương pháp xử lý j.
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(không có giá trị bằng nhau)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(có giá trị bằng nhau)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
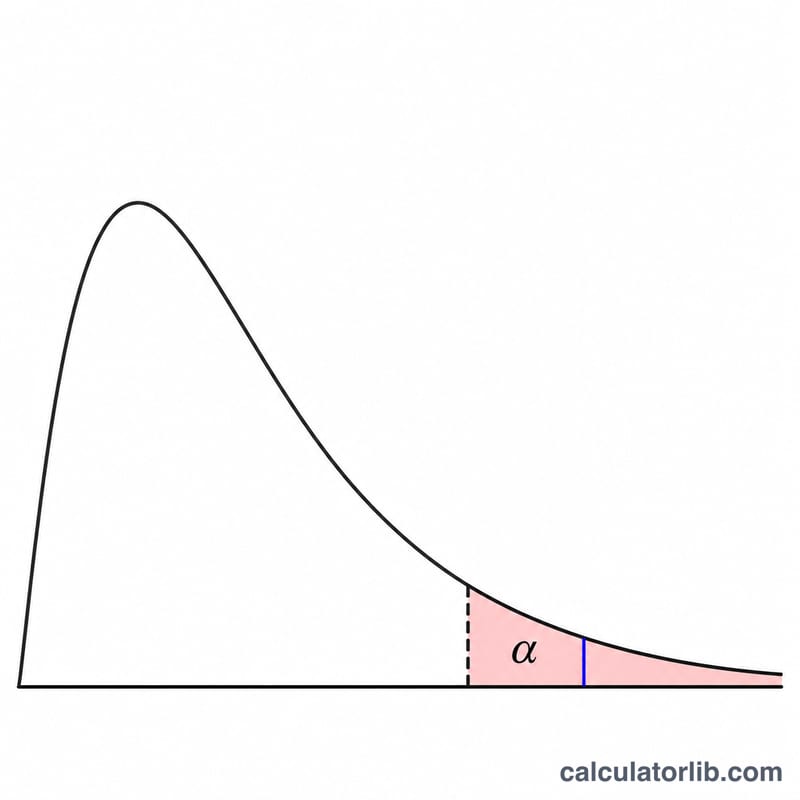
Trong đó \(b\) = số khối, \(k\) = số phương pháp xử lý, \(A_1\) = tổng bình phương của tất cả thứ hạng và \(C_1\) = hệ số hiệu chỉnh. T1 được so sánh với phân phối chi-bình phương có \(k-1\) bậc tự do; T2 được so sánh với phân phối F có \(k-1\) và \((b-1)(k-1)\) bậc tự do.
Quy ước và giả định
- Việc xếp hạng được thực hiện theo thứ tự tăng dần trong mỗi khối, thứ hạng 1 dành cho giá trị nhỏ nhất. Các giá trị bằng nhau nhận trung bình các thứ hạng mà chúng chiếm. Chiều xếp hạng không làm thay đổi thống kê.
- Nếu có bất kỳ khối nào chứa giá trị bằng nhau, T1 đã hiệu chỉnh được sử dụng. Khi không có giá trị bằng nhau, hai dạng này giống hệt nhau.
- T2 là thống kê được ưu tiên vì xấp xỉ F thường chính xác hơn xấp xỉ chi-bình phương của T1.
- Các giá trị p là xác suất đuôi trên. H0 chỉ bị bác bỏ khi thống kê lớn hơn giá trị tới hạn một cách nghiêm ngặt (p nhỏ hơn alpha); bằng nhau nghĩa là không bác bỏ.
- Không áp dụng hiệu chỉnh liên tục.
- Nếu T1 bằng b(k-1), mọi khối đều sắp xếp các phương pháp xử lý giống nhau, T2 là vô hạn, giá trị p theo F bằng 0 và H0 bị bác bỏ.
- Nếu mọi giá trị trong mọi khối đều bằng nhau, thống kê không xác định và một lỗi sẽ được trả về.
- Không bao gồm các so sánh bội sau kiểm định.
Ví dụ minh họa
Dữ liệu có b = 6 khối và k = 3 phương pháp xử lý, với alpha = 0,05 và tham chiếu F. Các hàng là 4 5 3, 6 7 5, 8 6 9, 5 7 4, 7 9 6 và 3 6 5. Sau khi xếp hạng trong từng hàng, tổng thứ hạng là 11, 16 và 9.
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4,33333,\qquad T_2=\frac{(6-1)\times 4,33333}{6\times 2-4,33333}=2,82609$$
Giá trị p theo F với 2 và 10 bậc tự do là 0,10645, và giá trị tới hạn là 4,103. Giá trị p theo chi-bình phương của T1 là 0,11456. Vì 2,82609 nhỏ hơn 4,103 (p = 0,10645 lớn hơn 0,05), quyết định là không bác bỏ H0.
Cách đọc kết quả
Giá trị p nhỏ cho thấy ít nhất một phương pháp xử lý có xu hướng xếp hạng cao hơn hoặc thấp hơn các phương pháp khác trong các khối. Giá trị p lớn nghĩa là dữ liệu không cho thấy tác động nhất quán của phương pháp xử lý; điều đó không chứng minh các phương pháp là bằng nhau. Kiểm định không cho biết phương pháp nào khác biệt. Số khối ít khiến xấp xỉ chi-bình phương kém tin cậy hơn, đó là một lý do T2 là mặc định. Không hỗ trợ giá trị thiếu, vì vậy mỗi khối phải đầy đủ.
Câu hỏi thường gặp
Khi nào nên dùng kiểm định Friedman?
Dùng khi cùng các đối tượng được đo dưới nhiều điều kiện và dữ liệu có tính thứ bậc hoặc không phân phối chuẩn, nên phân tích phương sai lặp lại không phù hợp.
Tại sao có hai giá trị p?
T1 tuân theo phân phối chi-bình phương xấp xỉ, còn T2 tuân theo phân phối F xấp xỉ thường chính xác hơn. Quyết định dựa trên thống kê bạn chọn.
Các giá trị bằng nhau được xử lý thế nào?
Các giá trị bằng nhau nhận trung bình các thứ hạng của chúng, và T1 chuyển sang dạng đã hiệu chỉnh cho giá trị bằng nhau.
Chiều xếp hạng có quan trọng không?
Không. Xếp hạng giảm dần cho cùng thống kê.
T2 vô hạn có nghĩa là gì?
Điều này xảy ra khi mọi khối xếp hạng các phương pháp xử lý theo cùng một thứ tự. Khi đó giá trị p theo F bằng 0 và H0 bị bác bỏ.
Nguồn tham khảo
- Dataplot FRIEDMAN TEST, NIST/ITL, 2023
















