

프리드먼 검정 계산기의 기능
이 계산기는 b개의 블록(예: 피험자, 배치 또는 날짜)마다 k개의 처리를 측정했을 때 처리들의 효과가 동일한지 검정합니다. 반복측정 분산분석(ANOVA)에 대한 순위 기반 비모수 대안입니다. 각 블록 안에서 값의 순위를 매기고, 처리별 순위합을 구한 뒤, 프리드먼 통계량 T1, 코노버 통계량 T2, 두 p-값, 임계값 및 기각 또는 기각하지 않음의 결정을 제공합니다.
사용 방법
데이터 표를 한 줄에 한 블록씩, 열마다 한 처리씩 입력하세요. 값은 쉼표, 세미콜론, 공백 또는 탭으로 구분하고, 소수점은 마침표를 사용합니다. 모든 줄의 값 개수가 같아야 하며, 최소 2개 블록과 2개 처리가 필요합니다. 그다음 유의수준 alpha(10%, 5%, 2.5% 또는 1%)와 결정에 사용할 기준 분포를 선택하세요. 기준 분포는 F(코노버 T2, 기본값이며 권장 옵션) 또는 카이제곱(T1)입니다.
공식
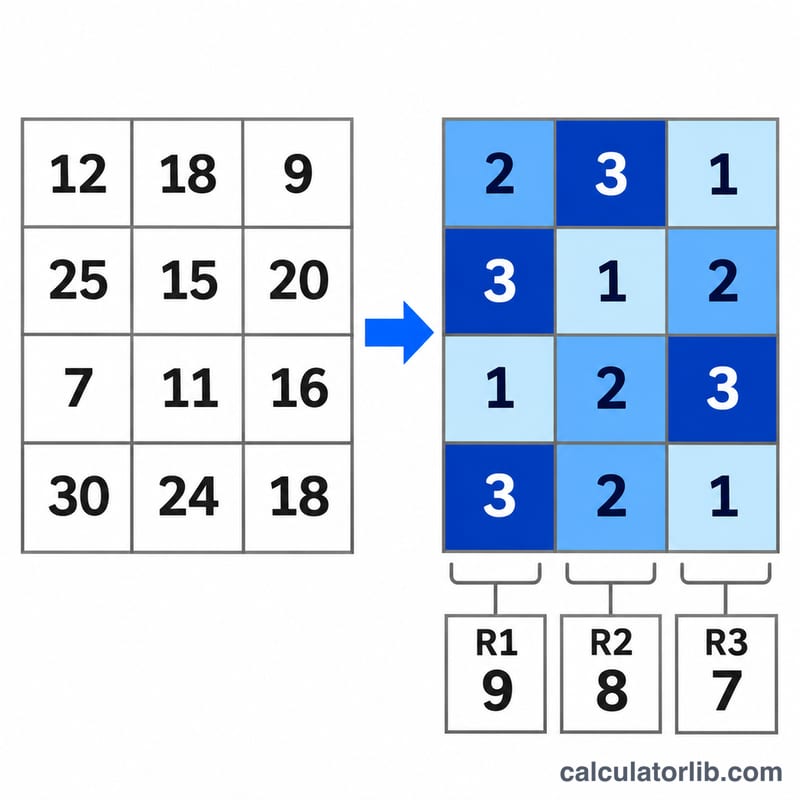
각 블록 내에서 값의 순위를 매기며, \(R_j\)는 처리 j의 순위합입니다.
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(동점 없음)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(동점 있음)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
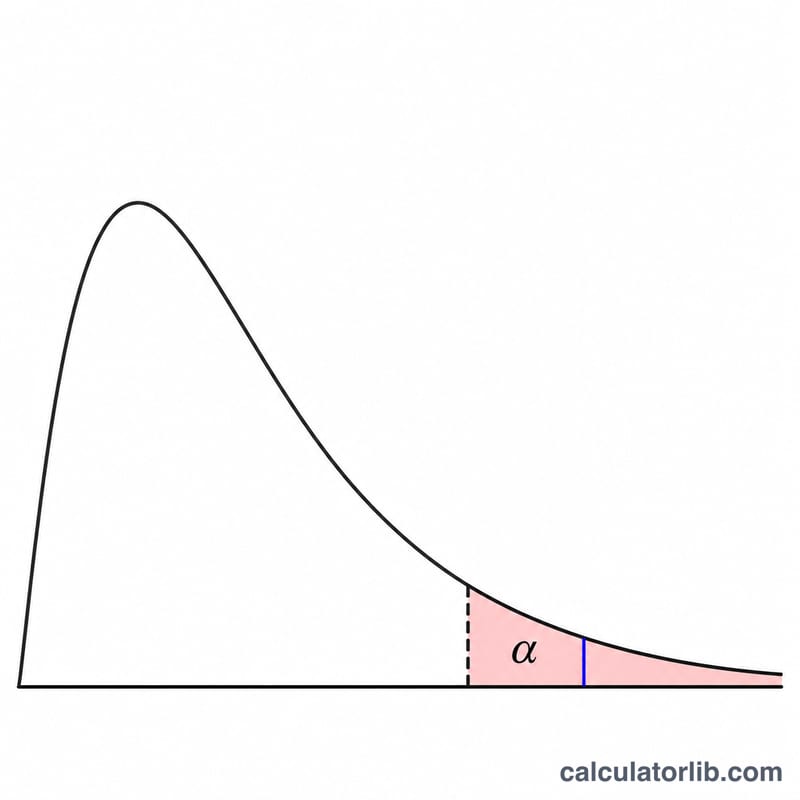
여기서 \(b\) = 블록 수, \(k\) = 처리 수, \(A_1\) = 모든 순위 제곱의 합, \(C_1\) = 보정 계수입니다. T1은 자유도 \(k-1\)인 카이제곱 분포와 비교하며, T2는 자유도 \(k-1\)과 \((b-1)(k-1)\)인 F 분포와 비교합니다.
규칙 및 가정
- 순위는 각 블록 내에서 오름차순으로 매기며, 가장 작은 값의 순위는 1입니다. 동점 값은 차지하는 순위의 평균을 받습니다. 정렬 방향은 통계량을 바꾸지 않습니다.
- 어떤 블록에 동점이 있으면 동점 보정된 T1을 사용합니다. 동점이 없으면 두 형태는 동일합니다.
- T2는 F 근사가 보통 T1의 카이제곱 근사보다 정확하므로 선호되는 통계량입니다.
- p-값은 상측 꼬리 확률입니다. 통계량이 임계값보다 严格히 클 때만 H0를 기각합니다(p가 alpha보다 작음). 같은 경우에는 기각하지 않습니다.
- 연속성 보정은 적용하지 않습니다.
- T1이 b(k-1)과 같으면 모든 블록이 처리를 동일한 순서로 정렬한 것이며, T2는 무한대이고 F p-값은 0이므로 H0를 기각합니다.
- 모든 블록의 모든 값이 같으면 통계량이 정의되지 않으며 오류가 반환됩니다.
- 검정 후의 다중 비교는 포함되지 않습니다.
계산 예시
데이터는 b = 6개 블록, k = 3개 처리이며, alpha = 0.05와 F 기준을 사용합니다. 행은 4 5 3, 6 7 5, 8 6 9, 5 7 4, 7 9 6, 3 6 5입니다. 각 행 안에서 순위를 매긴 후 순위합은 11, 16, 9입니다.
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4.33333,\qquad T_2=\frac{(6-1)\times 4.33333}{6\times 2-4.33333}=2.82609$$
자유도 2와 10인 F p-값은 0.10645이며, 임계값은 4.103입니다. T1의 카이제곱 p-값은 0.11456입니다. 2.82609는 4.103보다 작으므로(p = 0.10645는 0.05보다 큼) 결정은 H0를 기각하지 않음입니다.
결과 해석 방법
p-값이 작으면 적어도 하나의 처리가 블록 내에서 다른 처리들보다 일관되게 높거나 낮은 순위를 가지는 경향이 있음을 시사합니다. p-값이 크면 데이터에서 일관된 처리 효과가 나타나지 않는다는 뜻이지, 처리들이 동일하다는 것을 증명하지는 않습니다. 이 검정은 어떤 처리들이 서로 다른지는 알려주지 않습니다. 블록 수가 적으면 카이제곱 근사의 신뢰도가 떨어지며, 이것이 T2가 기본값인 이유 중 하나입니다. 결측값은 지원되지 않으므로 모든 블록이 완전해야 합니다.
자주 묻는 질문
프리드먼 검정은 언제 사용해야 하나요?
동일한 대상을 여러 조건에서 측정했고, 데이터가 순서형이거나 정규분포를 따르지 않아 반복측정 분산분석이 적절하지 않을 때 사용하세요.
p-값이 두 개인 이유는 무엇인가요?
T1은 근사 카이제곱 분포를 따르고, T2는 일반적으로 더 정확한 근사 F 분포를 따릅니다. 결정은 선택한 하나의 p-값을 사용합니다.
동점은 어떻게 처리되나요?
동점 값은 차지하는 순위의 평균을 공유하며, T1은 동점 보정 형태로 전환됩니다.
순위 방향이 중요한가요?
아니요. 내림차순으로 순위를 매겨도 동일한 통계량이 나옵니다.
T2가 무한대라는 것은 무엇을 의미하나요?
모든 블록이 처리를 같은 순서로 정렬할 때 발생합니다. 이때 F p-값은 0이며 H0를 기각합니다.
출처
- Dataplot FRIEDMAN TEST, NIST/ITL, 2023
















