

फ़्रीडमैन परीक्षण कैलकुलेटर क्या करता है
यह कैलकुलेटर जाँचता है कि क्या k उपचारों के प्रभाव समान हैं, जब हर उपचार को b ब्लॉकों (उदाहरण के लिए व्यक्ति, बैच या दिन) में से हर एक में मापा जाता है। यह दोहराए गए मापों वाले ANOVA का रैंक-आधारित, अप्राचलिक विकल्प है। यह हर ब्लॉक के भीतर मानों को रैंक देता है, हर उपचार के लिए रैंक जोड़ता है, और फ़्रीडमैन सांख्यिकी T1, कॉनओवर सांख्यिकी T2, दोनों p-मान, क्रांतिक मान और अस्वीकार करें या अस्वीकार न करें का निर्णय लौटाता है।
इसका उपयोग कैसे करें
डेटा तालिका में हर पंक्ति में एक ब्लॉक और हर कॉलम में एक उपचार दर्ज करें। मानों को अल्पविराम, सेमीकोलन, स्पेस या टैब से अलग करें, और दशमलव विभाजक के लिए बिंदु का प्रयोग करें। हर पंक्ति में मानों की संख्या बराबर होनी चाहिए, और कम से कम 2 ब्लॉक तथा 2 उपचार होने चाहिए। फिर सार्थकता स्तर अल्फ़ा (10%, 5%, 2.5% या 1%) चुनें और निर्णय के लिए संदर्भ बंटन चुनें: F (कॉनओवर T2, डिफ़ॉल्ट और पसंदीदा विकल्प) या काई-स्क्वायर (T1)।
सूत्र
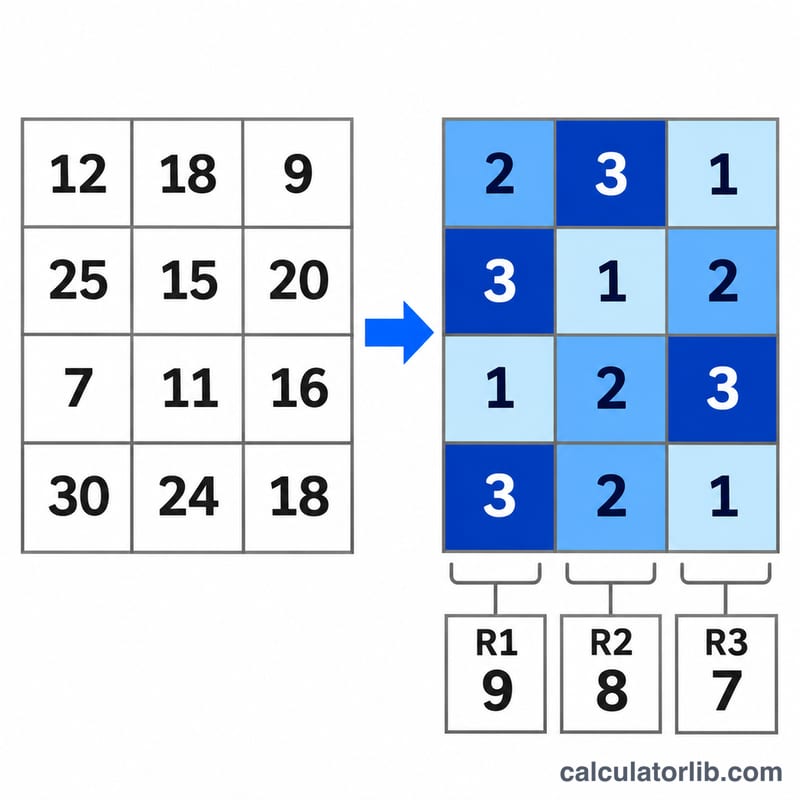
हर ब्लॉक के भीतर मानों को रैंक दिया जाता है और \(R_j\) उपचार j के लिए रैंकों का योग है।
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(कोई टाई नहीं)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(टाई सहित)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
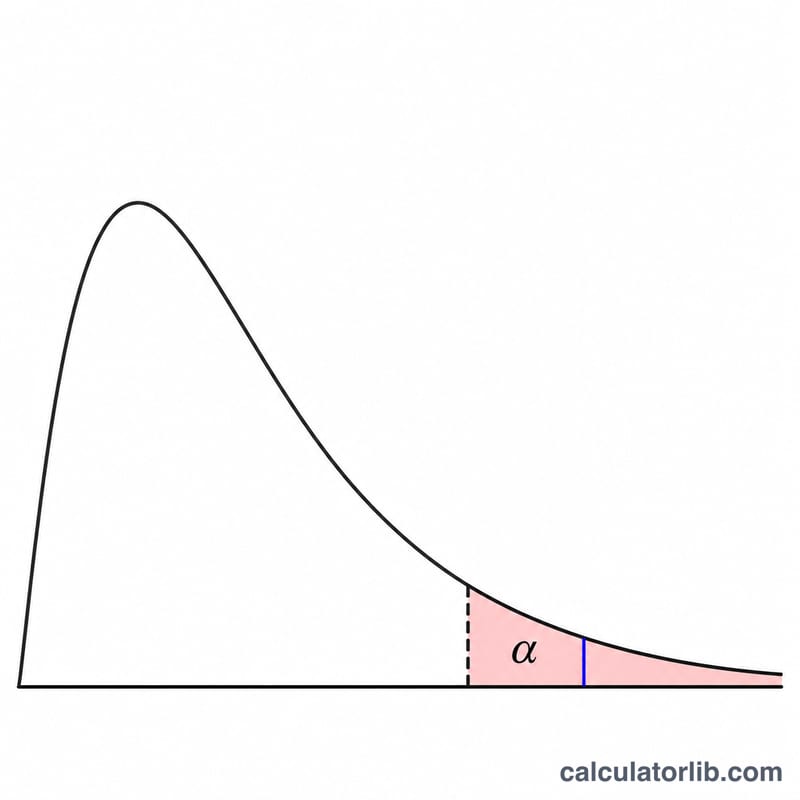
यहाँ \(b\) = ब्लॉकों की संख्या, \(k\) = उपचारों की संख्या, \(A_1\) = सभी वर्गित रैंकों का योग और \(C_1\) = सुधार कारक है। T1 की तुलना \(k-1\) स्वतंत्रता कोटि वाले काई-स्क्वायर बंटन से होती है; T2 की तुलना \(k-1\) और \((b-1)(k-1)\) स्वतंत्रता कोटि वाले F बंटन से होती है।
परंपराएँ और मान्यताएँ
- रैंकिंग हर ब्लॉक के भीतर आरोही क्रम में होती है, जिसमें सबसे छोटे मान को रैंक 1 मिलता है। बराबर मानों को उनके घेरे गए रैंकों का औसत मिलता है। दिशा से सांख्यिकी नहीं बदलती।
- यदि किसी ब्लॉक में टाई है, तो टाई-सुधारित T1 प्रयोग होता है। टाई न होने पर दोनों रूप समान होते हैं।
- T2 पसंदीदा सांख्यिकी है, क्योंकि इसका F सन्निकटन आमतौर पर T1 के काई-स्क्वायर सन्निकटन से अधिक सटीक होता है।
- p-मान ऊपरी-पूँछ की प्रायिकताएँ हैं। H0 तभी अस्वीकार होता है जब सांख्यिकी क्रांतिक मान से सख़्ती से अधिक हो (p, अल्फ़ा से कम हो); बराबर होने का अर्थ है अस्वीकार न करें।
- कोई सातत्य सुधार (continuity correction) लागू नहीं होता।
- यदि T1, b(k-1) के बराबर है, तो सभी ब्लॉक उपचारों को एक ही क्रम में रखते हैं, T2 अनंत होता है, F p-मान 0 होता है और H0 अस्वीकार होता है।
- यदि हर ब्लॉक के सभी मान बराबर हैं, तो सांख्यिकी अपरिभाषित होती है और त्रुटि लौटाई जाती है।
- परीक्षण के बाद की बहु-तुलनाएँ शामिल नहीं हैं।
कार्य किया हुआ उदाहरण
डेटा में b = 6 ब्लॉक और k = 3 उपचार हैं, जहाँ alpha = 0.05 और F संदर्भ है। पंक्तियाँ 4 5 3, 6 7 5, 8 6 9, 5 7 4, 7 9 6 और 3 6 5 हैं। हर पंक्ति के भीतर रैंक देने के बाद रैंक योग 11, 16 और 9 हैं।
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4.33333,\qquad T_2=\frac{(6-1)\times 4.33333}{6\times 2-4.33333}=2.82609$$
2 और 10 स्वतंत्रता कोटि वाला F p-मान 0.10645 है, और क्रांतिक मान 4.103 है। T1 के लिए काई-स्क्वायर p-मान 0.11456 है। चूँकि 2.82609, 4.103 से कम है (p = 0.10645, 0.05 से अधिक है), इसलिए निर्णय है H0 अस्वीकार न करें।
परिणाम कैसे पढ़ें
छोटा p-मान सुझाता है कि कम से कम एक उपचार ब्लॉकों के भीतर अन्य की तुलना में अधिक या कम रैंक पाने की प्रवृत्ति रखता है। बड़ा p-मान बताता है कि डेटा में कोई सुसंगत उपचार प्रभाव नहीं दिखता; इससे यह सिद्ध नहीं होता कि उपचार समान हैं। परीक्षण यह नहीं बताता कि कौन से उपचार भिन्न हैं। कम ब्लॉक संख्या होने पर काई-स्क्वायर सन्निकटन कम विश्वसनीय होता है, और यही एक कारण है कि T2 डिफ़ॉल्ट है। लापता मान समर्थित नहीं हैं, इसलिए हर ब्लॉक पूरा होना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
मुझे फ़्रीडमैन परीक्षण कब उपयोग करना चाहिए?
इसे तब उपयोग करें जब एक ही इकाइयों को कई स्थितियों में मापा गया हो और डेटा क्रमिक हो या सामान्य रूप से वितरित न हो, जिससे दोहराए गए मापों वाला ANOVA उचित न हो।
दो p-मान क्यों हैं?
T1 लगभग काई-स्क्वायर बंटन का अनुसरण करता है, जबकि T2 लगभग F बंटन का अनुसरण करता है जो आमतौर पर अधिक सटीक होता है। निर्णय उसी के आधार पर होता है जिसे आप चुनते हैं।
टाई को कैसे संभाला जाता है?
बराबर मान अपनी रैंकों का औसत साझा करते हैं, और T1 टाई-सुधारित रूप में बदल जाता है।
क्या रैंकिंग की दिशा मायने रखती है?
नहीं। अवरोही क्रम में रैंकिंग देने पर वही सांख्यिकी मिलती है।
अनंत T2 का क्या अर्थ है?
यह तब होता है जब हर ब्लॉक उपचारों को एक ही क्रम में रखता है। तब F p-मान 0 होता है और H0 अस्वीकार होता है।
स्रोत
- Dataplot FRIEDMAN TEST, NIST/ITL, 2023
















