

Что делает калькулятор теста Фридмана
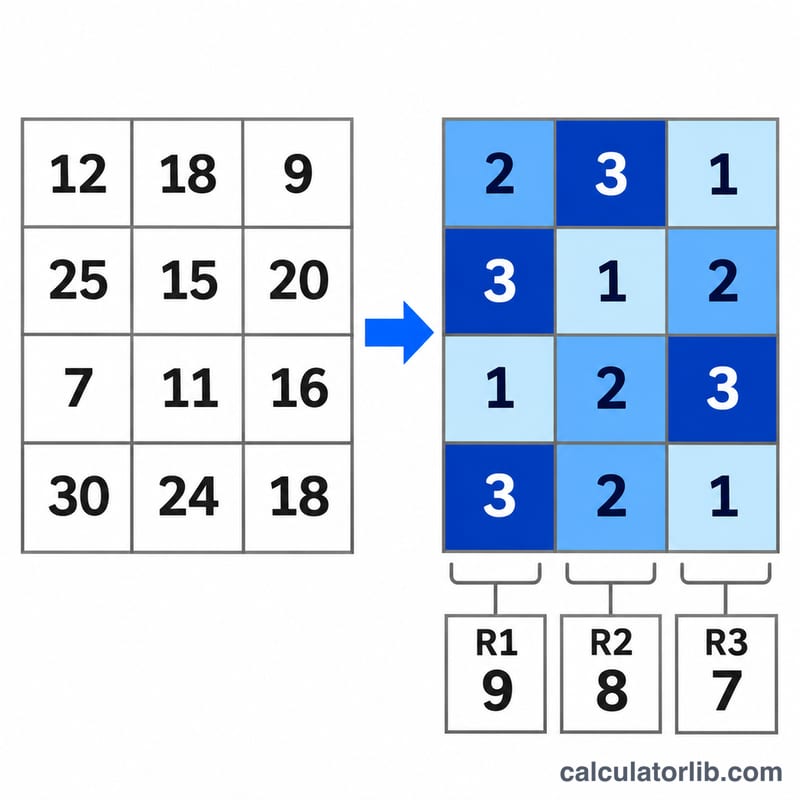
Этот калькулятор проверяет, одинаково ли действие k видов обработки, если каждый вид измерен внутри каждого из b блоков (например, испытуемые, партии или дни). Это непараметрическая альтернатива дисперсионному анализу с повторными измерениями, основанная на рангах. Калькулятор ранжирует значения внутри каждого блока, суммирует ранги для каждого вида обработки и выводит статистику Фридмана T1, статистику Конувера T2, оба p-значения, критическое значение и решение: отвергнуть или не отвергать H0.
Как пользоваться
Введите таблицу данных: один блок в строке, один вид обработки в столбце. Разделяйте значения запятыми, точками с запятой, пробелами или табуляцией, а в качестве десятичного разделителя используйте точку. В каждой строке должно быть одинаковое количество значений, при этом блоков должно быть не менее 2, видов обработки тоже не менее 2. Затем выберите уровень значимости альфа (10%, 5%, 2,5% или 1%) и эталонное распределение для решения: F (T2 Конувера, вариант по умолчанию и предпочтительный) или хи-квадрат (T1).
Формулы
Внутри каждого блока значения ранжируются, \(R_j\) — сумма рангов для вида обработки j.
$$S=\sum_{j=1}^{k}\left(R_j-\frac{b(k+1)}{2}\right)^2$$
$$T_1=\frac{12\,S}{bk(k+1)}\quad\text{(без связей)},\qquad T_1=\frac{(k-1)\,S}{A_1-C_1}\quad\text{(со связями)}$$
$$A_1=\sum_i\sum_j R(X_{ij})^2,\qquad C_1=\frac{bk(k+1)^2}{4}$$
$$T_2=\frac{(b-1)\,T_1}{b(k-1)-T_1}$$
Здесь \(b\) — число блоков, \(k\) — число видов обработки, \(A_1\) — сумма всех квадратов рангов, \(C_1\) — поправочный коэффициент. T1 сравнивается с распределением хи-квадрат с \(k-1\) степенями свободы; T2 сравнивается с F-распределением с \(k-1\) и \((b-1)(k-1)\) степенями свободы.
Соглашения и допущения
- Ранжирование выполняется по возрастанию внутри каждого блока: ранг 1 получает наименьшее значение. Совпадающим значениям присваивается среднее из рангов, которые они занимают. Направление ранжирования не меняет статистику.
- Если в каком-либо блоке есть совпадающие значения, используется T1 с поправкой на связи. Без связей обе формы совпадают.
- T2 — предпочтительная статистика, так как её F-аппроксимация обычно точнее хи-квадрат-аппроксимации T1.
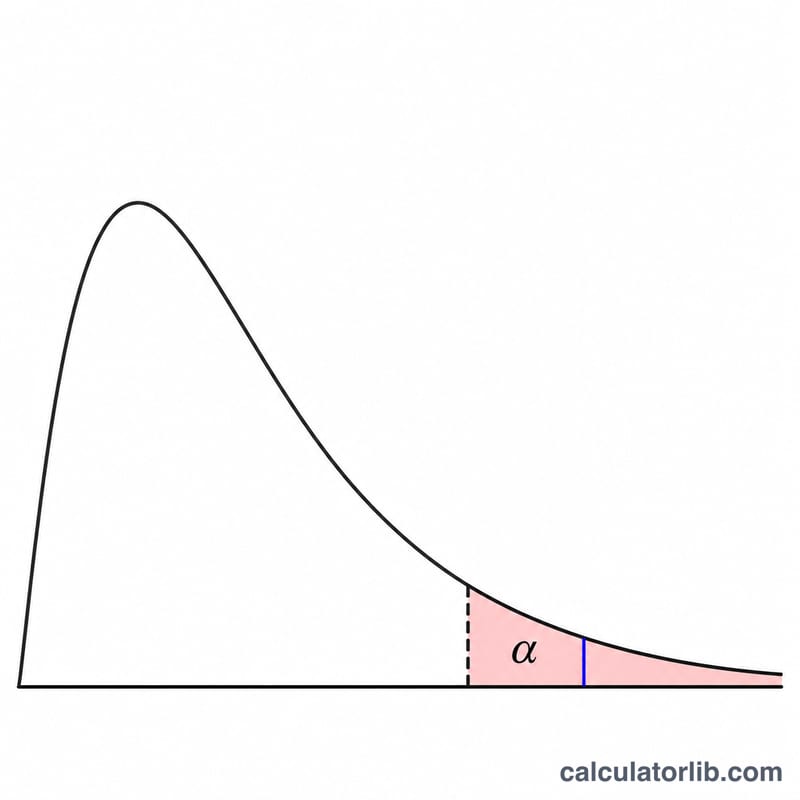
- p-значения — это вероятности правого хвоста. H0 отвергается только если статистика строго больше критического значения (p меньше альфа); равенство означает, что H0 не отвергается.
- Поправка на непрерывность не применяется.
- Если T1 равна b(k-1), все блоки упорядочивают виды обработки одинаково, T2 бесконечна, p-значение по F равно 0 и H0 отвергается.
- Если все значения во всех блоках равны, статистика не определена и возвращается ошибка.
- Множественные сравнения после теста не включены.
Пример расчёта
Данные содержат b = 6 блоков и k = 3 вида обработки, при alpha = 0,05 и эталоне F. Строки: 4 5 3, 6 7 5, 8 6 9, 5 7 4, 7 9 6 и 3 6 5. После ранжирования внутри каждой строки суммы рангов равны 11, 16 и 9.
$$A_1=84,\qquad C_1=\frac{6\times 3\times 4^2}{4}=72$$
$$T_1=4{,}33333,\qquad T_2=\frac{(6-1)\times 4{,}33333}{6\times 2-4{,}33333}=2{,}82609$$
p-значение по F при 2 и 10 степенях свободы равно 0,10645, критическое значение — 4,103. p-значение по хи-квадрат для T1 равно 0,11456. Поскольку 2,82609 меньше 4,103 (p = 0,10645 больше 0,05), решение: не отвергать H0.
Как читать результат
Малое p-значение говорит о том, что хотя бы один вид обработки внутри блоков стабильно получает более высокие или более низкие ранги, чем остальные. Большое p-значение означает, что данные не показывают устойчивого эффекта обработки; это не доказывает равенство видов обработки. Тест ничего не говорит о том, какие именно виды различаются. При малом числе блоков аппроксимация хи-квадрат менее надёжна, поэтому T2 выбрана по умолчанию. Пропущенные значения не поддерживаются, поэтому каждый блок должен быть полным.
Часто задаваемые вопросы
Когда использовать тест Фридмана?
Используйте его, когда одни и те же объекты измерены в нескольких условиях, а данные порядковые или не распределены нормально, так что дисперсионный анализ с повторными измерениями не подходит.
Почему есть два p-значения?
T1 следует приблизительному распределению хи-квадрат, а T2 — приблизительному F-распределению, которое обычно точнее. Решение использует то, которое вы выберете.
Как обрабатываются совпадающие значения?
Совпадающие значения получают среднее из своих рангов, а T1 переключается на вариант с поправкой на связи.
Важно ли направление ранжирования?
Нет. Ранжирование по убыванию даёт ту же статистику.
Что означает бесконечная T2?
Это происходит, когда каждый блок ранжирует виды обработки в одном и том же порядке. Тогда p-значение по F равно 0, и H0 отвергается.
Источники
- Dataplot FRIEDMAN TEST, NIST/ITL, 2023
















