레빈 검정 계산기의 기능
레빈 검정은 둘 이상의 집단이 같은 분산을 갖는지, 즉 분산의 동질성 조건을 만족하는지 확인합니다. 분산분석(ANOVA)과 합동 two-sample t 검정을 포함한 많은 절차가 이 가정을 전제로 합니다. 이 계산기는 각 집단의 원자료를 입력받아 W 통계량, 자유도, F 분포의 상측 p-값, 선택한 유의수준에서의 임계값, 그리고 기각 또는 기각하지 않음의 판정을 계산합니다. 추가 검정을 하기 전에 이 가정을 점검해야 하는 학생, 분석가, 연구자에게 적합합니다.
사용 방법
첫 번째 입력란에 데이터를 입력합니다. 집단은 세미콜론(;)으로, 집단 내 값은 쉼표(,)로 구분합니다. 예를 들어 두 집단은 6,8,4;12,15,7과 같이 입력합니다. 각 집단에는 최소 두 개의 값이 필요하며, 모든 값은 숫자여야 합니다. 다음으로 편차 계산에 사용할 중심을 선택합니다. 중앙값(브라운-포사이스 변형, 권장) 또는 평균(원래 레빈 방식) 중 하나를 고릅니다. 마지막으로 0.0001에서 0.5 사이의 유의수준 alpha를 설정합니다. 기본값은 0.05입니다.
공식
각 관측값은 해당 집단 중심으로부터의 절대편차로 변환되며, W는 집단 간과 집단 내에서 이 편차들의 퍼짐 정도를 비교합니다.
$$Z_{ij} = |Y_{ij} - c_i|$$$$W = \frac{N-k}{k-1} \times \frac{\sum_{i=1}^{k} N_i\,(\bar{Z}_i - \bar{Z})^2}{\sum_{i=1}^{k}\sum_{j=1}^{N_i} (Z_{ij} - \bar{Z}_i)^2}$$여기서 \(k\)는 집단 수, \(N_i\)는 집단 \(i\)의 크기, \(N\)은 전체 관측값 수, \(c_i\)는 집단 평균 또는 중앙값, \(\bar{Z}_i\)는 집단 \(i\)의 편차 평균, \(\bar{Z}\)는 모든 편차의 평균입니다. 분산이 같다는 귀무가설은 \(W > F(\alpha, k-1, N-k)\)일 때 기각됩니다.
규약과 가정
- 기본 중심은 중앙값이며, 평균을 선택할 수도 있습니다. 절사평균은 원자료에 절사 규칙이 정의되어 있지 않으므로 제공하지 않습니다.
- 짝수 개의 값을 가진 집단의 중앙값은 정렬된 두 가운데 값의 평균입니다.
- 자유도는 분자에 \(k-1\), 분모에 \(N-k\)를 사용합니다.
- p-값은 정규화된 불완전 베타 함수로 계산한 상측 꼬리 확률 \(P(F \ge W)\)입니다.
- 판정은 엄격한 부등호를 사용합니다. W가 임계값과 같으면 기각하지 않습니다.
- 값은 내부적으로 반올림하지 않습니다. W와 p-값은 소수점 6자리, 임계값은 소수점 4자리로 표시합니다.
- 제한: 2개에서 50개 집단, 집단당 최소 2개의 값, 최대 5000개의 값. 집단 내 편차가 모두 같으면 W는 정의되지 않습니다.
계산 예시
세 집단을 입력합니다: 6,8,4,5,9; 12,15,7,20,3; 5,6,5,7,6. 중심은 중앙값이며 \(\alpha = 0.05\)입니다. 따라서 \(k = 3\)이고 \(N = 15\)입니다.
$$df_1 = k-1 = 2,\quad df_2 = N-k = 12$$$$W = 5.284768$$$$p = 0.022592,\quad F_{0.05,\,2,\,12} = 3.8853$$\(5.284768 > 3.8853\)이므로, 또는 동일하게 \(p = 0.022592 < 0.05\)이므로 검정은 분산이 같다는 가설을 기각합니다.
결과 해석 방법
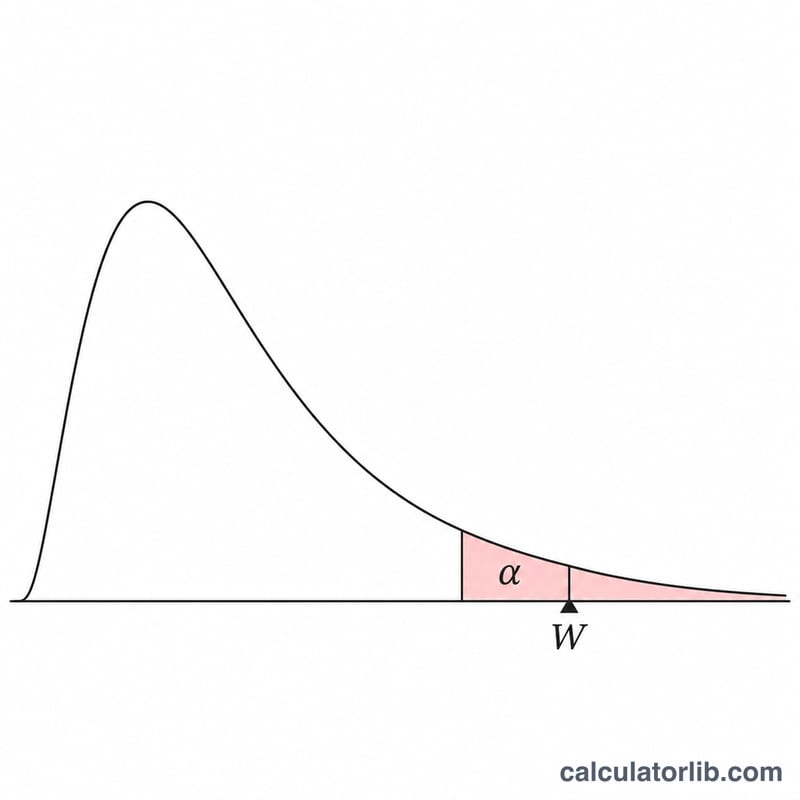
p-값이 작거나 W가 임계값보다 크면 적어도 한 집단의 분산이 다르다는 근거가 됩니다. p-값이 크면 분산이 다르다는 뚜렷한 근거가 없다는 뜻이지만, 분산이 같다는 것을 증명하지는 않습니다. 특히 표본이 작을 때는 더욱 그렇습니다. 중앙값 변형은 치우친 자료에 더 강건하며, 평균 변형은 다르게 작동하여 다른 판정으로 이어질 수 있습니다. 집단이 두 개인 경우 이 검정은 편차에 대한 two-sample t 검정과 같으며, \(W = t^2\)입니다. 검정의 신뢰도는 입력된 데이터의 품질에 달려 있으므로, 먼저 입력 오류와 이상치를 확인하세요.
자주 묻는 질문
어떤 중심을 선택해야 하나요?
중앙값이 기본값이며, 강건성과 우수한 검정력 때문에 권장됩니다. 평균은 원래의 레빈 검정을 재현합니다.
집단의 크기가 달라도 되나요?
네. 각 집단에 최소 두 개의 값만 있으면 집단 크기가 달라도 괜찮습니다.
p-값은 무엇을 의미하나요?
모든 분산이 같다고 가정할 때, W 이상의 F 값이 나올 확률입니다. p-값이 alpha보다 작으면 기각합니다.
계산기가 통계량이 정의되지 않는다고 표시하는 이유는 무엇인가요?
모든 집단 내 편차가 동일하면 W의 분모가 0이 되어 통계량을 계산할 수 없습니다.
유의하지 않은 결과가 분산이 같다는 것을 증명하나요?
아니요. 선택한 수준에서 데이터가 유의한 차이를 보이지 않는다는 뜻일 뿐입니다.
출처
- 1.3.5.10. Levene Test for Equality of Variances, NIST/SEMATECH e-Handbook of Statistical Methods