이 계산기의 기능
이 계산기는 두 모집단 분산의 동일성에 대한 F-검정을 수행합니다. 두 원자료 표본을 붙여 넣으면 각 표본의 분산, F 통계량, 두 자유도, 설정한 유의수준에서의 임계값, p-값, 그리고 기각 또는 기각 안 함의 결정을 계산합니다. 학생, 분석가, 엔지니어가 두 공정, 측정기기 또는 집단의 산포가 같은지 확인하고, 이후 합동 t-검정이나 Welch t-검정 같은 후속 방법을 고를 때 유용합니다.
사용 방법
다음 순서로 입력하세요:
- 표본 1 데이터: 쉼표, 세미콜론, 공백 또는 줄바꿈으로 구분된 두 개 이상의 숫자, 소수점은 마침표를 사용합니다.
- 표본 2 데이터: 같은 방식으로 입력합니다.
- 대립가설: 양측(분산이 같지 않음), 큼(분산 1이 더 큼) 또는 작음(분산 1이 더 작음).
- 유의수준 alpha: 0.05와 같은 값으로, 0보다 크고 0.5보다 작아야 합니다.
표본 1은 항상 비율의 분자이므로, 단측 검정에서는 표본의 순서가 중요합니다.
공식
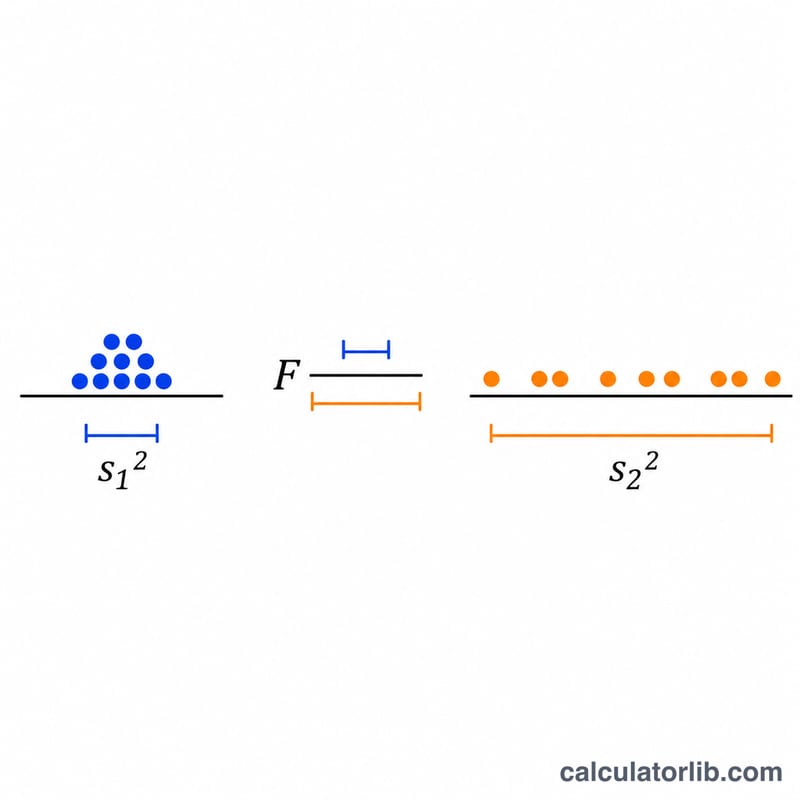
$$F = \frac{s_1^2}{s_2^2}, \qquad s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(x_i-\bar{x})^2$$
여기서 \(s_1^2\)와 \(s_2^2\)는 표본 분산이고, \(x_i\)는 관측값, \(\bar{x}\)는 표본 평균, \(N\)은 표본 크기입니다. 귀무가설이 참이고 자료가 정규분포를 따르면 이 통계량은 분子 자유도 \(N_1-1\)과 분모 자유도 \(N_2-1\)을 갖는 F 분포를 따릅니다.
관례와 가정
- 분산은 제수 \(n-1\)을 사용하며, 표본 1이 분자입니다.
- 자유도는 \(N_1-1\)과 \(N_2-1\)입니다.
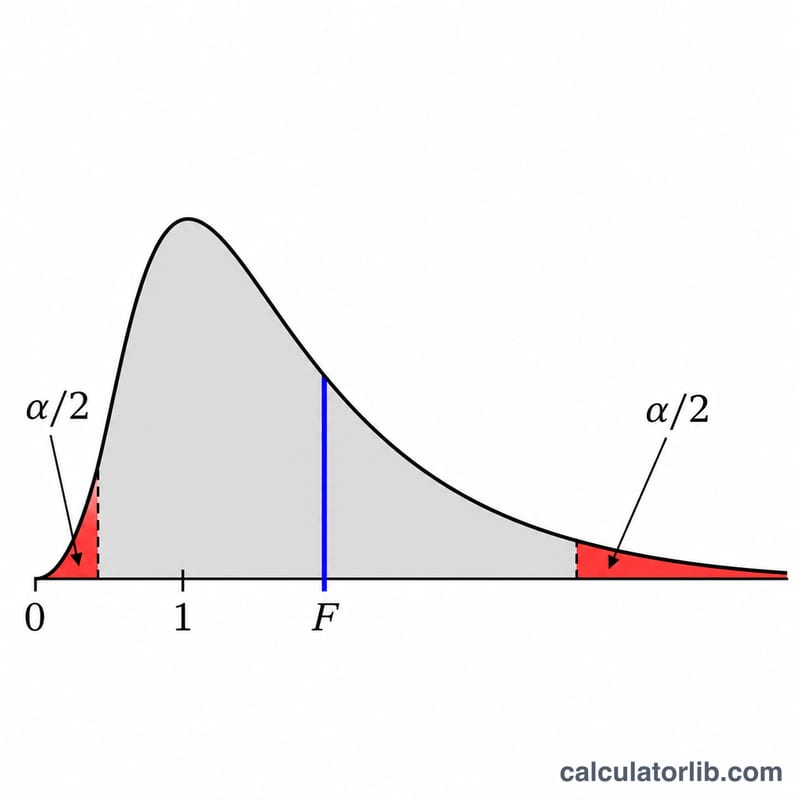
- 상측 대립가설: \(F\)가 \(1-\alpha\) 분위수를 넘으면 기각합니다. 하측 대립가설: \(F\)가 \(\alpha\) 분위수보다 작으면 기각합니다. 양측: \(F\)가 \(\alpha/2\) 분위수보다 작거나 \(1-\alpha/2\) 분위수보다 크면 기각합니다.
- 부등호는 엄격하므로, F가 임계값과 정확히 같으면 기각하지 않습니다.
- p-값은 큰 쪽 대립가설에서는 상측 꼬리, 작은 쪽 대립가설에서는 하측 꼬리입니다. 양측 검정에서는 \(\min(1, 2\min(p_{\text{lower}}, p_{\text{upper}}))\)입니다. 이 방법은 NIST 기각역을 따르지만, NIST 페이지에는 p-값 공식이 나와 있지 않으므로 이 두 배 꼬리 규칙은 해당 기각역과 일치하도록 한 설계 선택입니다. \(p<\alpha\)일 때만 기각합니다.
- 이 검정은 모수적 방법이므로 순위, 동점 처리 또는 연속성 보정이 적용되지 않습니다.
- 이 검정은 정규모집단에서 나온 독립 표본을 가정하며, 정규성에서 벗어나는 경우에 민감합니다.
- 결과는 전체 정밀도로 계산되며, 약 4~6개의 유효숫자로 표시됩니다.
예제 풀이
표본 1은 12.1, 13.4, 11.8, 14.2, 12.9, 13.7, 12.5, 14.8 (n = 8)입니다. 표본 2는 12.4, 12.8, 12.2, 13.0, 12.6, 12.9, 12.5 (n = 7)입니다. 검정은 \(\alpha = 0.05\)인 양측 검정입니다.
$$s_1^2 = 1.0850,\quad s_2^2 = 0.082381$$
$$F = \frac{1.0850}{0.082381} = 13.1705,\quad df_1 = 7,\ df_2 = 6$$
임계값은 0.1954(하측)와 5.6955(상측)입니다. \(13.1705 > 5.6955\)이므로 귀무가설을 기각합니다. p-값은 0.005860으로 0.05보다 작아 결정을 확인해 줍니다.
결과 해석과 한계
F가 1보다 훨씬 크면 표본 1이 표본 2보다 더 넓게 퍼져 있다는 뜻이고, F가 0에 가까우면 그 반대입니다. p-값이 작으면 분산이 같다는 가설에 대한 증거입니다. p-값이 크면 자료에서 차이가 보이지 않는다는 뜻이지만, 동일성을 증명하는 것은 아니며, 특히 표본이 작을 때는 더욱 그렇습니다. 자료가 비대칭이거나 꼬리가 두꺼울 때 F-검정은 Levene 검정이나 Brown-Forsythe 검정보다 훨씬 덜 강건하므로, 먼저 정규성을 확인하세요. 표본 2의 분산이 0이면 F가 정의되지 않습니다.
자주 묻는 질문
유의한 결과는 무엇을 의미합니까?
p-값이 alpha보다 작다는 것은, 두 모집단의 분산이 같다고 할 때 관측된 분산 비율이 나타날 가능성이 낮다는 뜻입니다.
표본의 순서가 중요합니까?
표본을 바꾸면 \(1/F\)가 되고 단측 대립가설도 서로 바뀝니다. 양측 결정은 같습니다.
양측 p-값은 왜 두 배가 됩니까?
양측 검정은 alpha를 두 꼬리에 똑같이 나누므로, 작은 쪽 꼬리 확률을 두 배로 하고 1을 넘지 않도록 제한합니다.
관측값은 몇 개나 필요합니까?
표본마다 최소 두 개가 필요하지만, 표본이 작으면 실제 차이를 찾아낼 검정력이 낮습니다.
자료가 정규분포가 아니면 어떻게 합니까?
F-검정은 오해의 소지가 있는 결과를 줄 수 있습니다. Levene 검정 같은 더 강건한 검정을 고려하세요.
출처
- 1.3.5.9. 두 분산의 동일성에 대한 F-검정, NIST/SEMATECH e-Handbook of Statistical Methods.