Что делает этот калькулятор
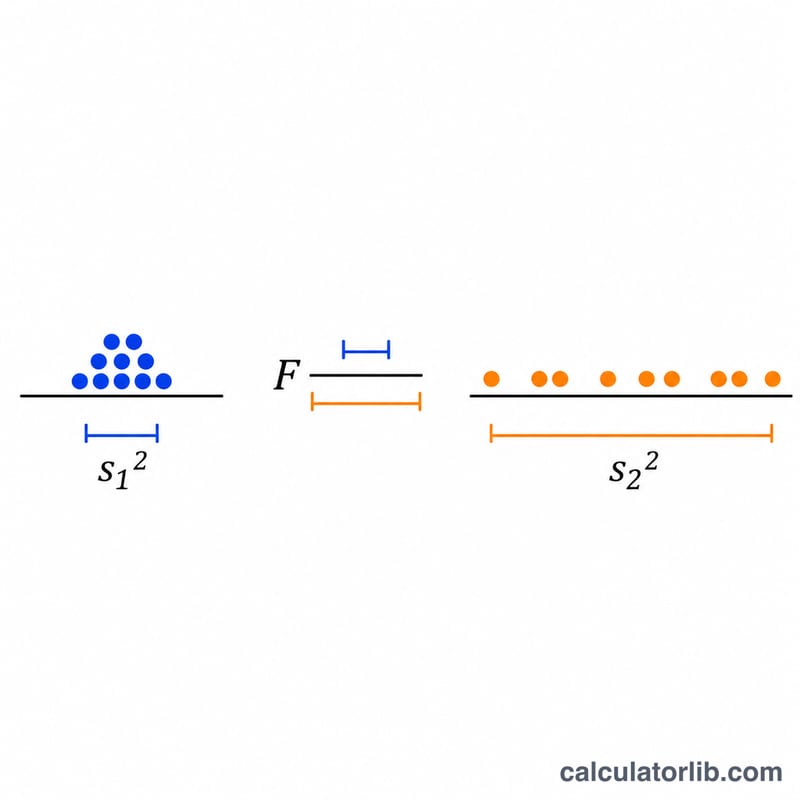
Этот калькулятор выполняет F-тест на равенство дисперсий двух генеральных совокупностей. Вставьте две исходные выборки, и он вычислит дисперсию каждой выборки, F-статистику, обе степени свободы, критическое значение или значения на заданном уровне значимости, p-значение и решение об отклонении или неотклонении гипотезы. Инструмент подходит студентам, аналитикам и инженерам, которым нужно проверить, имеют ли два процесса, прибора или группы одинаковый разброс, прежде чем выбрать дальнейший метод, например t-тест с объединённой дисперсией или тест Уэлча.
Как пользоваться
Вводите данные в таком порядке:
- Данные выборки 1: не менее двух чисел, разделённых запятыми, точками с запятой, пробелами или переносами строк, с точкой как десятичным разделителем.
- Данные выборки 2: вводятся так же.
- Альтернативная гипотеза: двусторонняя (дисперсии не равны), greater (дисперсия 1 больше) или less (дисперсия 1 меньше).
- Уровень значимости alpha: значение, например 0.05, которое должно быть больше 0 и меньше 0.5.
Выборка 1 всегда является числителем отношения, поэтому для односторонних тестов порядок выборок имеет значение.
Формула
$$F = \frac{s_1^2}{s_2^2}, \qquad s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(x_i-\bar{x})^2$$
Здесь \(s_1^2\) и \(s_2^2\) — выборочные дисперсии, \(x_i\) — наблюдения, \(\bar{x}\) — выборочное среднее, а \(N\) — объём выборки. Статистика следует F-распределению с \(N_1-1\) степенями свободы в числителе и \(N_2-1\) в знаменателе, если нулевая гипотеза верна и данные нормальны.
Соглашения и допущения
- Дисперсии вычисляются с делителем \(n-1\), а выборка 1 является числителем.
- Степени свободы равны \(N_1-1\) и \(N_2-1\).
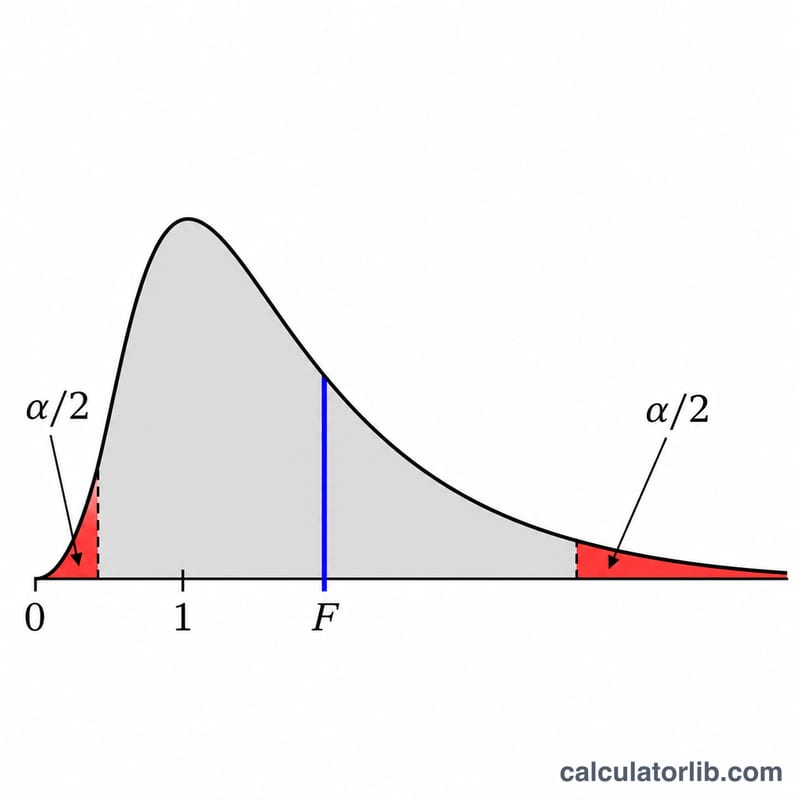
- Верхняя альтернатива: гипотеза отвергается, если \(F\) превышает квантиль \(1-\alpha\). Нижняя альтернатива: отвергается, если \(F\) ниже квантиля \(\alpha\). Двусторонний тест: отвергается, если \(F\) ниже квантиля \(\alpha/2\) или выше квантиля \(1-\alpha/2\).
- Неравенства строгие, поэтому F, в точности равное критическому значению, не приводит к отклонению.
- p-значение — это верхний хвост для верхней альтернативы и нижний хвост для нижней альтернативы. Для двустороннего теста оно равно \(\min(1, 2\min(p_{\text{нижний}}, p_{\text{верхний}}))\). Метод следует критическим областям NIST, но на странице NIST формула p-значения не приводится, поэтому правило удвоенного хвоста является проектным решением, согласованным с этими областями. Гипотеза отвергается тогда и только тогда, когда \(p<\alpha\).
- Ранги, совпадения и поправки на непрерывность не применяются, так как тест параметрический.
- Тест предполагает независимые выборки из нормальных генеральных совокупностей и чувствителен к отклонениям от нормальности.
- Результаты вычисляются с полной точностью и отображаются с точностью около 4–6 значащих цифр.
Пример расчёта
Выборка 1: 12.1, 13.4, 11.8, 14.2, 12.9, 13.7, 12.5, 14.8 (n = 8). Выборка 2: 12.4, 12.8, 12.2, 13.0, 12.6, 12.9, 12.5 (n = 7). Тест двусторонний, с \(\alpha = 0.05\).
$$s_1^2 = 1.0850,\quad s_2^2 = 0.082381$$
$$F = \frac{1.0850}{0.082381} = 13.1705,\quad df_1 = 7,\ df_2 = 6$$
Критические значения равны 0.1954 (нижнее) и 5.6955 (верхнее). Поскольку \(13.1705 > 5.6955\), нулевая гипотеза отвергается. p-значение равно 0.005860, что меньше 0.05 и подтверждает решение.
Как читать результат и ограничения
F значительно больше 1 означает, что выборка 1 более разбросана, чем выборка 2; F, близкое к 0, означает обратное. Небольшое p-значение является свидетельством против равенства дисперсий. Большое значение означает, что данные не показывают различий, но это не доказательство равенства, особенно при малых выборках. F-тест заметно менее устойчив, чем тесты Левене или Брауна–Форсайта, при асимметричных или тяжёлохвостых данных, поэтому сначала проверьте нормальность. Если в выборке 2 дисперсия равна нулю, F не определено.
Часто задаваемые вопросы
Что означает значимый результат?
p-значение меньше alpha, поэтому наблюдаемое отношение дисперсий было бы маловероятным, если бы обе генеральные совокупности имели одинаковую дисперсию.
Важен ли порядок выборок?
Перестановка выборок даёт \(1/F\) и меняет местами односторонние альтернативы. Двустороннее решение остаётся тем же.
Почему двустороннее p-значение удваивается?
Двусторонний тест делит alpha поровну между обоими хвостами, поэтому меньшая вероятность хвоста удваивается и ограничивается единицей.
Сколько наблюдений нужно?
Минимум два в каждой выборке, однако малые выборки дают низкую мощность для обнаружения реальных различий.
Что делать, если данные не нормальны?
F-тест может давать вводящие в заблуждение результаты. Рассмотрите более устойчивый тест, например тест Левене.
Источники
- 1.3.5.9. F-тест на равенство двух дисперсий, NIST/SEMATECH e-Handbook of Statistical Methods.