Что делает калькулятор теста серий
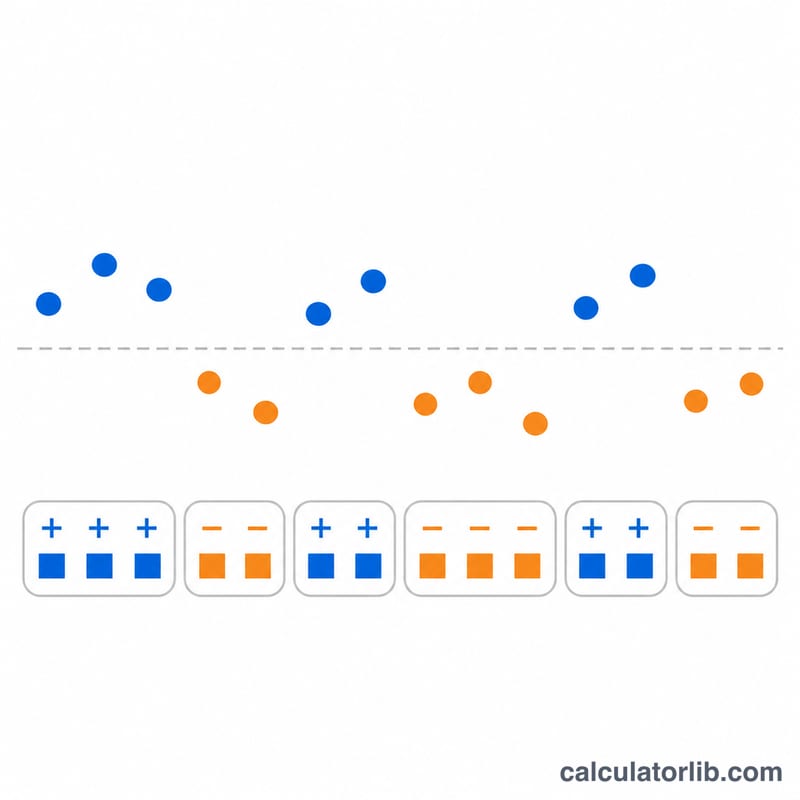
Этот калькулятор применяет тест серий для выявления неслучайности к упорядоченной последовательности чисел. Каждое значение кодируется как выше (+) или ниже (-) медианы, подсчитываются серии в этом шаблоне, и их количество сравнивается с тем, что дал бы случайный порядок. Калькулятор возвращает число серий, ожидаемое число, стандартное отклонение, Z-статистику, двусторонний p-интервал и решение об отклонении или неотклонении гипотезы. Он подходит аналитикам, которые проверяют остатки, результаты измерений процессов или любые временные ряды на наличие трендов, кластеризации или колебаний.
Как пользоваться
Введите значения в хронологическом порядке в поле данных, разделяя их запятыми, точкami с запятой, пробелами или новыми строками, с точкой в качестве десятичного разделителя. Затем выберите двусторонний уровень значимости alpha (0,10, 0,05, 0,025 или 0,01). Порядок важен, так как данные никогда не сортируются. Нужны как минимум два числовых значения, причём хотя бы одно значение должно быть выше медианы и хотя бы одно ниже.
Формула
Серия — это последовательность подряд идущих значений с одним и тем же знаком. При наблюдаемом числе серий \(R\) статистика критерия равна:
$$Z = \frac{R - \bar{R}}{s_R}$$Ожидаемое число серий и дисперсия при гипотезе случайности:
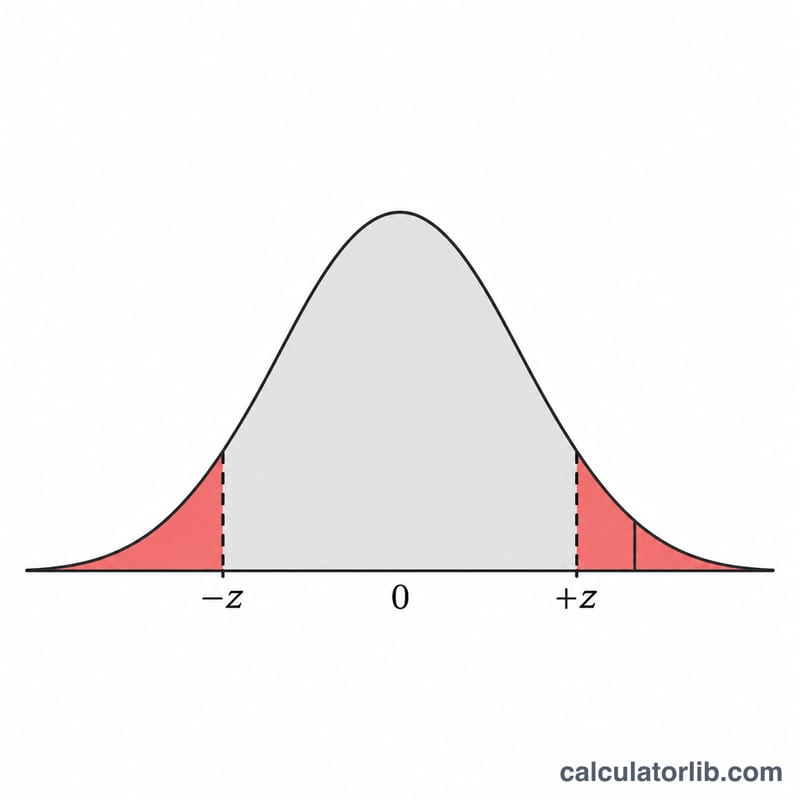
$$\bar{R} = \frac{2 n_1 n_2}{n_1 + n_2} + 1$$$$s_R^2 = \frac{2 n_1 n_2(2 n_1 n_2 - n_1 - n_2)}{(n_1+n_2)^2 (n_1+n_2-1)}$$Здесь \(n_1\) — количество значений выше медианы, \(n_2\) — количество значений ниже медианы, \(R\) — наблюдаемое число серий, \(\bar{R}\) — ожидаемое число серий, а \(s_R\) — стандартное отклонение числа серий. Двустороннее p-значение равно \(p = 2(1-\Phi(|Z|))\), где \(\Phi\) — функция распределения стандартного нормального закона. Случайность отвергается, когда \(|Z| > z_{1-\alpha/2}\).
Соглашения и допущения
- Значения выше медианы считаются положительными, а значения ниже — отрицательными; серия — это блок подряд идущих значений с одним и тем же знаком.
- Источник не указывает, как обрабатывать значения, равные медиане. По принятому в расчёте решению такие значения исключаются, порядок остальных сохраняется, а количество исключённых значений выводится. \(n_1\) и \(n_2\) учитывают только положительные и отрицательные значения.
- Медиана — стандартная выборочная медиана всех введённых значений: среднее значение при нечётном количестве и среднее двух средних значений при чётном.
- Поправка на непрерывность не применяется.
- Решение строгое: равенство \(|Z|\) и критического значения не приводит к отклонению. Критическое значение для 5% равно 1,96.
- Всегда используется нормальное приближение. Предупреждение о малой выборке появляется, когда \(n_1 \le 10\) или \(n_2 \le 10\), так как точные таблицы не реализованы.
- Статистики и p-значение отображаются с 4 знаками после запятой; внутренние значения не округляются.
Пример расчёта
Последовательность по умолчанию из 20 значений имеет медиану 3,95, и ни одно значение ей не равно. Десять значений выше и десять ниже, поэтому \(n_1 = 10\), \(n_2 = 10\), а число серий в последовательности \(R = 14\).
$$\bar{R} = \frac{2 \times 10 \times 10}{20} + 1 = 11$$Стандартное отклонение числа серий равно \(s_R = 2{,}1764\), поэтому:
$$Z = \frac{14 - 11}{2{,}1764} = 1{,}3784$$Двустороннее p-значение равно 0,1681, а критическое значение при \(\alpha = 0{,}05\) равно 1,9600. Так как \(1{,}3784 < 1{,}9600\), случайность не отвергается. Поскольку \(n_1 \le 10\), предупреждение о малой выборке включено.
Интерпретация результата и ограничения
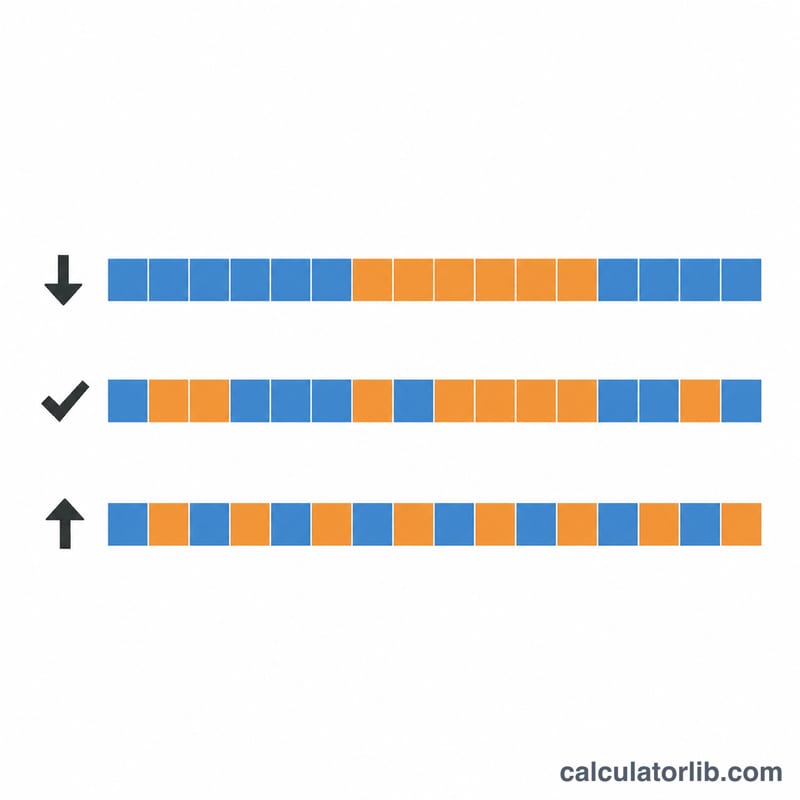
Слишком мало серий указывает на кластеризацию или тренд; слишком много — на чередование. Большое \(|Z|\) и p-значение ниже alpha указывают на неслучайность. Неотклонение гипотезы не доказывает случайность, а лишь означает, что этот тест не нашёл доказательств против неё. Разделение по медиане нечувствительно к некоторым закономерностям, например к медленным изменениям разброса. При малых группах нормальное приближение может быть неточным, поэтому пограничные результаты следует интерпретировать осторожно.
Часто задаваемые вопросы
Что проверяет тест серий?
Он проверяет, похож ли порядок значений на случайный, исходя из того, как часто последовательность переключается между значениями выше и ниже медианы.
Как обрабатываются значения, равные медиане?
Они исключаются из последовательности, а количество исключённых значений выводится. Оставшиеся значения сохраняют свой порядок.
Почему есть предупреждение о малой выборке?
Нормальное приближение работает лучше всего, когда и \(n_1\), и \(n_2\) превышают 10. При меньших значениях предпочтительнее точные таблицы, которые здесь не включены.
Важен ли порядок данных?
Да. Данные используются именно в том порядке, в котором введены, и изменение порядка меняет число серий.
Когда случайность отвергается?
Когда \(|Z|\) строго больше нормального критического значения для выбранного alpha, что эквивалентно p-значению меньше alpha.
Источники
- 1.3.5.13. Runs Test for Detecting Non-randomness, NIST/SEMATECH e-Handbook of Statistical Methods