ランズ検定計算ツールの機能
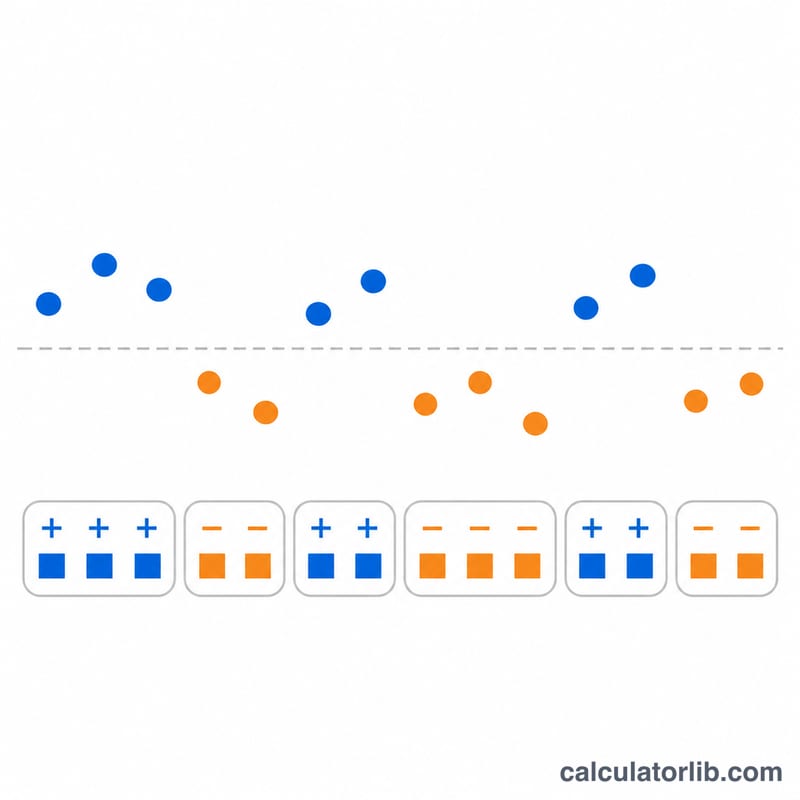
このツールは、順序付けられた数値列にランズ検定を適用し、ランダム性からの逸脱を検出します。各値は中央値より大きい(+)か小さい(-)かで符号化され、そのパターンにおけるランの数を数えたうえで、ランダムな並びで期待される数と比較します。ランの数、期待ランの数、標準偏差、Z 値、両側 p 値、および「棄却」または「棄却しない」の判定を返します。残差、工程測定値、その他の時系列データについて、トレンド、集中、振動の有無を確認したいアナリストに適しています。
使い方
データ欄に、時間順に値を入力してください。区切りにはカンマ、セミコロン、スペース、または改行を使用でき、小数点にはピリオドを使います。次に、両側検定の有意水準 α(0.10、0.05、0.025、0.01 のいずれか)を選択します。データは並べ替えられないため、入力順序が結果に影響します。数値は少なくとも 2 つ必要で、中央値より大きい値と小さい値がそれぞれ 1 つ以上含まれている必要があります。
計算式
ランとは、同じ符号を持つ連続した値の並びのことです。観測されたランの数を \(R\) とすると、検定統計量は次のとおりです。
$$Z = \frac{R - \bar{R}}{s_R}$$ランダム性の仮定の下での期待ランの数と分散は次のとおりです。
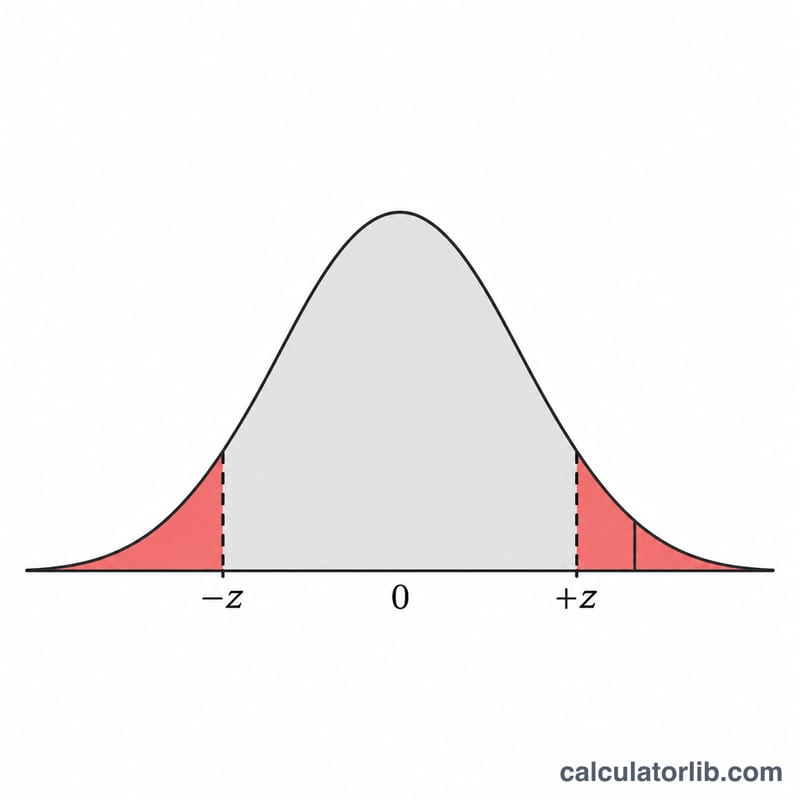
$$\bar{R} = \frac{2 n_1 n_2}{n_1 + n_2} + 1$$$$s_R^2 = \frac{2 n_1 n_2(2 n_1 n_2 - n_1 - n_2)}{(n_1+n_2)^2 (n_1+n_2-1)}$$ここで \(n_1\) は中央値より大きい値の個数、\(n_2\) は中央値より小さい値の個数、\(R\) は観測されたラン数、\(\bar{R}\) は期待ラン数、\(s_R\) はランの標準偏差です。両側 p 値は \(p = 2(1-\Phi(|Z|))\) で求められ、\(\Phi\) は標準正規分布の累積分布関数です。\(|Z| > z_{1-\alpha/2}\) のとき、ランダム性は棄却されます。
前提条件と仮定
- 中央値より大きい値は正、小さい値は負として扱い、ランは同じ符号を持つ連続した値のまとまりとします。
- 中央値と等しい値の扱いについて、元の仕様では定められていません。設計上の選択として、これらの値は除外し、残りの値の順序は保持し、除外された個数を報告します。\(n_1\) と \(n_2\) は正の値と負の値のみを数えます。
- 中央値は、入力されたすべての値に対する標準的な標本中央値です。個数が奇数の場合は中央の値、偶数の場合は中央の 2 つの値の平均とします。
- 連続性の補正は適用しません。
- 判定は厳密に行います。\(|Z|\) と臨界値が等しい場合は棄却されません。5% の臨界値は 1.96 です。
- 常に正規近似を用います。正確な表は実装されていないため、\(n_1 \le 10\) または \(n_2 \le 10\) の場合に少標本の警告を表示します。
- 統計量と p 値は小数点以下 4 桁で表示しますが、内部計算では丸めを行いません。
計算例
初期設定の 20 個の値からなる数列は、中央値が 3.95 で、それと等しい値はありません。中央値より大きい値が 10 個、小さい値が 10 個あるため、\(n_1 = 10\)、\(n_2 = 10\) となり、この数列のラン数は \(R = 14\) です。
$$\bar{R} = \frac{2 \times 10 \times 10}{20} + 1 = 11$$ランの標準偏差は \(s_R = 2.1764\) なので、次のようになります。
$$Z = \frac{14 - 11}{2.1764} = 1.3784$$両側 p 値は 0.1681 で、\(\alpha = 0.05\) における臨界値は 1.9600 です。\(1.3784 < 1.9600\) のため、ランダム性は棄却されません。\(n_1 \le 10\) であるため、少標本の警告が表示されます。
結果の読み方と制限事項
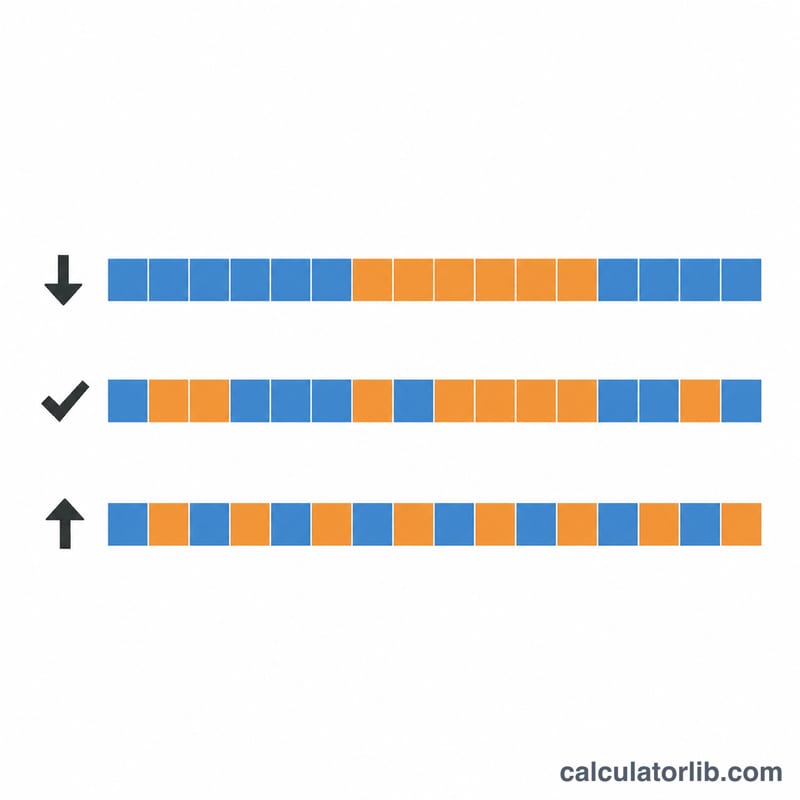
ラン数が少なすぎる場合は集中やトレンドを、多すぎる場合は交互の並びを示唆します。\(|Z|\) が大きく、p 値が α を下回る場合は、ランダム性がないことを示します。棄却されないことはランダムであることを証明するものではなく、この検定では反証となる根拠が見つからなかったことを意味するにすぎません。中央値による分割は、散らばりのゆるやかな変化など、一部のパターンを検出できません。小標本では正規近似の精度が低下する場合があるため、境界付近の結果は慎重に解釈してください。
よくある質問
ランズ検定は何を調べるのですか?
中央値より大きい値と小さい値の間で数列がどれくらいの頻度で入れ替わるかに基づき、値の順序がランダムに見えるかどうかを調べます。
中央値と等しい値はどのように扱われますか?
数列から除外され、除外された個数が報告されます。残りの値は元の順序を保ちます。
少標本の警告が表示されるのはなぜですか?
正規近似は、\(n_1\) と \(n_2\) の両方が 10 を超える場合に最も精度が高くなります。それ未満の場合は正確な表を使う方が望ましいものの、本ツールには含まれていません。
データの順序は重要ですか?
はい。データは入力どおりに使用され、順序を変えるとラン数が変わります。
ランダム性はいつ棄却されますか?
選択した α に対応する正規分布の臨界値より \(|Z|\) が厳密に大きい場合に棄却されます。これは p 値が α を下回る場合と同じです。
参考資料
- 1.3.5.13. Runs Test for Detecting Non-randomness、NIST/SEMATECH e-Handbook of Statistical Methods