रन टेस्ट कैलकुलेटर क्या करता है
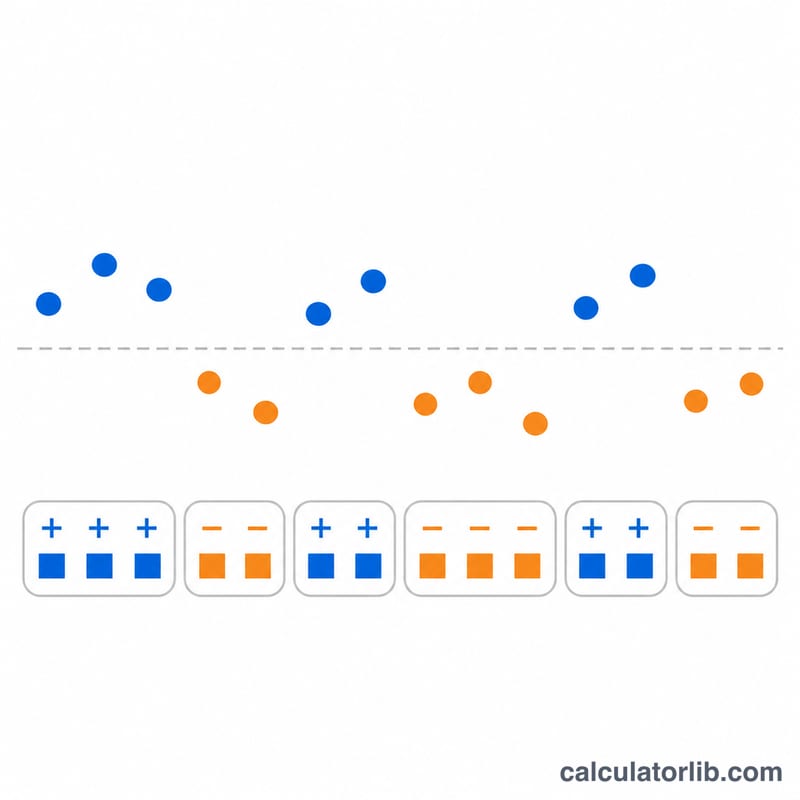
यह कैलकुलेटर संख्याओं के क्रमबद्ध अनुक्रम पर गैर-यादृच्छिकता का पता लगाने के लिए रन टेस्ट लागू करता है। प्रत्येक मान को माध्यिका से ऊपर (+) या नीचे (-) के रूप में कोड किया जाता है, उस पैटर्न में रनों की गिनती की जाती है, और इस गिनती की तुलना उस परिणाम से की जाती है जो एक यादृच्छिक क्रम देता। यह रनों की संख्या, अपेक्षित संख्या, मानक विचलन, Z सांख्यिकी, दो-पक्षीय p-मान और अस्वीकार या अस्वीकार न करने का निर्णय लौटाता है। यह अवशेषों, प्रक्रिया मापों या किसी भी समय-क्रमित श्रृंखला में प्रवृत्ति, समूहन या दोलन जाँचने वाले विश्लेषकों के लिए उपयुक्त है।
इसका उपयोग कैसे करें
मानों को समय क्रम में डेटा फ़ील्ड में दर्ज करें, अल्पविराम, सेमीकोलन, स्पेस या नई लाइन से अलग करके, और दशमलव विभाजक के रूप में बिंदु का उपयोग करें। फिर दो-पक्षीय सार्थकता स्तर अल्फा (0.10, 0.05, 0.025 या 0.01) चुनें। क्रम मायने रखता है, क्योंकि डेटा को कभी क्रमबद्ध नहीं किया जाता। कम से कम दो संख्यात्मक मान आवश्यक हैं, और कम से कम एक मान माध्यिका से ऊपर और एक नीचे होना चाहिए।
सूत्र
रन लगातार उन मानों की श्रृंखला है जिनका चिह्न समान है। \(R\) प्रेक्षित रनों के साथ, परीक्षण सांख्यिकी है:
$$Z = \frac{R - \bar{R}}{s_R}$$यादृच्छिकता की परिकल्पना के तहत अपेक्षित रन और प्रसरण हैं:
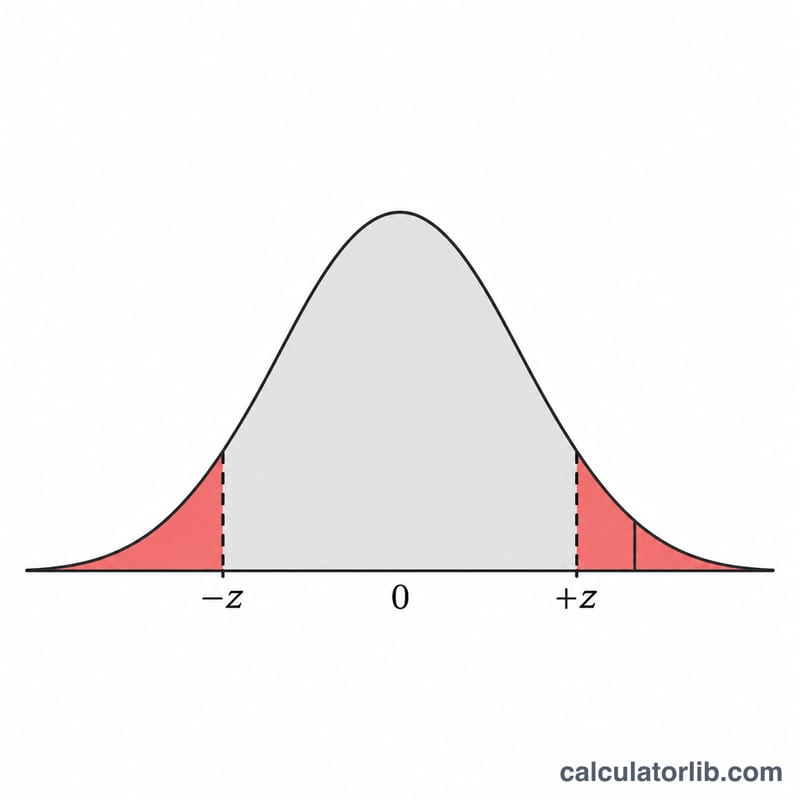
$$\bar{R} = \frac{2 n_1 n_2}{n_1 + n_2} + 1$$$$s_R^2 = \frac{2 n_1 n_2(2 n_1 n_2 - n_1 - n_2)}{(n_1+n_2)^2 (n_1+n_2-1)}$$यहाँ \(n_1\) माध्यिका से ऊपर के मानों की संख्या है, \(n_2\) नीचे के मानों की संख्या, \(R\) प्रेक्षित रन, \(\bar{R}\) अपेक्षित रन और \(s_R\) रनों का मानक विचलन। दो-पक्षीय p-मान \(p = 2(1-\Phi(|Z|))\) है, जहाँ \(\Phi\) मानक सामान्य संचयी वितरण फ़लन है। यादृच्छिकता तब अस्वीकार की जाती है जब \(|Z| > z_{1-\alpha/2}\) हो।
परंपराएँ और मान्यताएँ
- माध्यिका से ऊपर के मान धनात्मक और नीचे के ऋणात्मक माने जाते हैं; रन समान चिह्न वाले लगातार मानों का खंड है।
- स्रोत यह नहीं बताता कि माध्यिका के बराबर मानों से कैसे निपटा जाए। एक डिज़ाइन विकल्प के रूप में, उन्हें छोड़ दिया जाता है, शेष का क्रम बनाए रखा जाता है, और छोड़े गए मानों की संख्या दर्ज की जाती है। \(n_1\) और \(n_2\) केवल धनात्मक और ऋणात्मक मानों की गिनती करते हैं।
- माध्यिका सभी दर्ज मानों की मानक नमूना माध्यिका है: विषम संख्या में बीच का मान, सम संख्या में बीच के दो मानों का औसत।
- कोई निरंतरता सुधार लागू नहीं किया जाता।
- निर्णय सख्त है: \(|Z|\) और क्रांतिक मान की समानता पर अस्वीकार नहीं किया जाता। 5% क्रांतिक मान 1.96 है।
- सामान्य सन्निकटन हमेशा उपयोग होता है। जब \(n_1 \le 10\) या \(n_2 \le 10\) होता है तो छोटे नमूने की चेतावनी दिखती है, क्योंकि सटीक तालिकाएँ लागू नहीं की गई हैं।
- सांख्यिकी और p-मान 4 दशमलव स्थानों तक दिखाए जाते हैं; आंतरिक मान अपरिवर्तित रहते हैं।
कार्य किया हुआ उदाहरण
डिफ़ॉल्ट 20-मानों के अनुक्रम की माध्यिका 3.95 है, और कोई मान इसके बराबर नहीं है। दस मान ऊपर और दस नीचे हैं, इसलिए \(n_1 = 10\), \(n_2 = 10\), और अनुक्रम में \(R = 14\) रन हैं।
$$\bar{R} = \frac{2 \times 10 \times 10}{20} + 1 = 11$$रनों का मानक विचलन \(s_R = 2.1764\) है, इसलिए:
$$Z = \frac{14 - 11}{2.1764} = 1.3784$$दो-पक्षीय p-मान 0.1681 है और \(\alpha = 0.05\) पर क्रांतिक मान 1.9600 है। चूँकि \(1.3784 < 1.9600\), यादृच्छिकता अस्वीकार नहीं की गई। क्योंकि \(n_1 \le 10\), छोटे नमूने की चेतावनी चालू है।
परिणाम पढ़ना और सीमाएँ
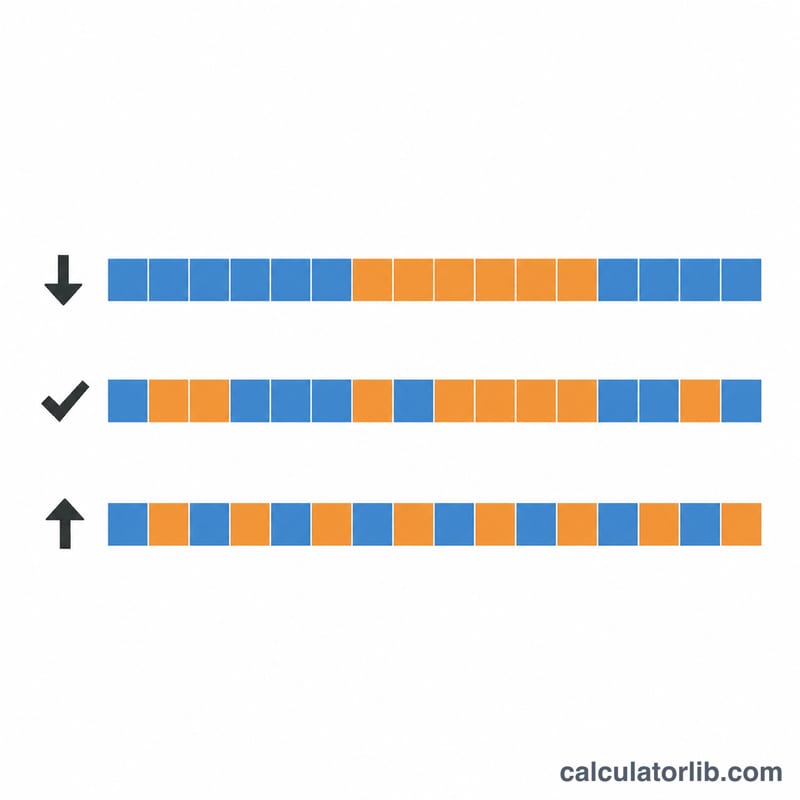
बहुत कम रन समूहन या प्रवृत्ति का संकेत देते हैं; बहुत अधिक रन एकांतरण का संकेत देते हैं। बड़ा \(|Z|\) और अल्फा से कम p-मान गैर-यादृच्छिकता दर्शाते हैं। अस्वीकार न होना यादृच्छिकता सिद्ध नहीं करता, केवल यह बताता है कि इस परीक्षण को इसके विरुद्ध कोई प्रमाण नहीं मिला। माध्यिका विभाजन कुछ पैटर्न के प्रति असंवेदनशील है, जैसे प्रसार में धीमे बदलाव। छोटे समूहों में सामान्य सन्निकटन अशुद्ध हो सकता है, इसलिए सीमारेखा परिणामों को सावधानी से लें।
अक्सर पूछे जाने वाले प्रश्न
रन टेस्ट क्या जाँचता है?
यह जाँचता है कि मानों का क्रम यादृच्छिक लगता है या नहीं, इस आधार पर कि अनुक्रम माध्यिका से ऊपर और नीचे के मानों के बीच कितनी बार बदलता है।
माध्यिका के बराबर मानों को कैसे संभाला जाता है?
उन्हें अनुक्रम से हटा दिया जाता है, और हटाई गई संख्या दर्ज की जाती है। शेष मान अपना क्रम बनाए रखते हैं।
छोटे नमूने की चेतावनी क्यों है?
सामान्य सन्निकटन तब सबसे अच्छा काम करता है जब \(n_1\) और \(n_2\) दोनों 10 से अधिक हों। उससे कम होने पर सटीक तालिकाएँ बेहतर होतीं, जो शामिल नहीं हैं।
क्या डेटा का क्रम मायने रखता है?
हाँ। डेटा को जैसा दर्ज किया गया है वैसा ही उपयोग किया जाता है, और क्रम बदलने से रनों की संख्या बदल जाती है।
यादृच्छिकता कब अस्वीकार की जाती है?
जब \(|Z|\) चुने गए अल्फा के लिए सामान्य क्रांतिक मान से सख्ती से अधिक हो, जो p-मान के अल्फा से कम होने के बराबर है।
स्रोत
- 1.3.5.13. Runs Test for Detecting Non-randomness, NIST/SEMATECH e-Handbook of Statistical Methods