游程檢定計算機的功能
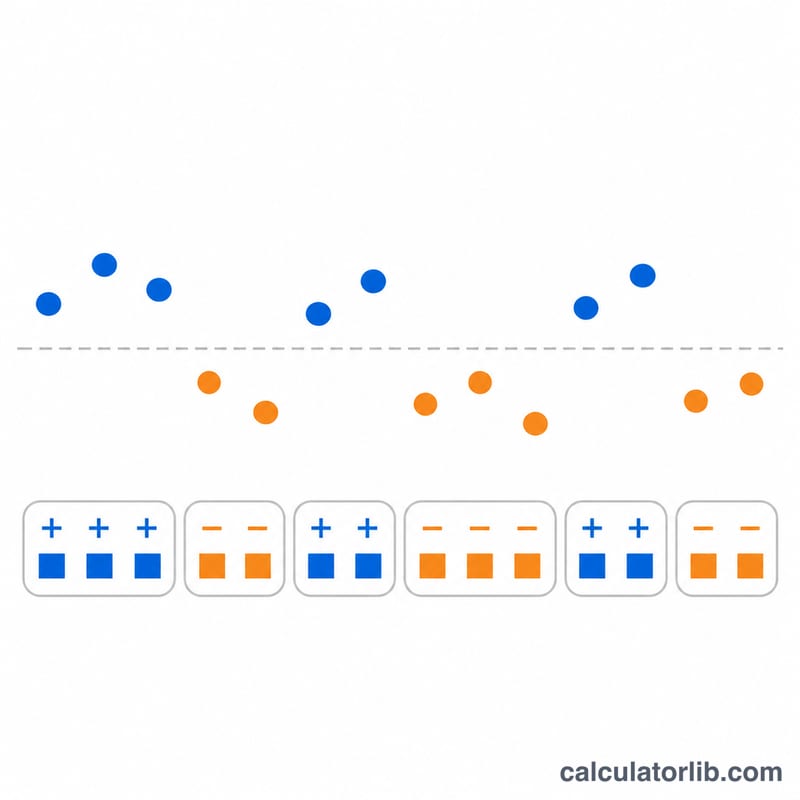
本計算機將游程檢定應用於有序的數值序列,以偵測非隨機性。每個數值會依其高於(+)或低於(-)中位數進行編碼,計算該模式中的游程數,再將此數量與隨機排列所產生的結果比較。計算結果包括游程數、期望游程數、標準差、Z 統計量、雙尾 p 值,以及拒絕或不拒絕的判定。本工具適合分析師用來檢查殘差、製程測量或任何時間序列,以判斷是否存在趨勢、群聚或振盪。
使用方法
請依時間順序將數值輸入資料欄位,數值之間可用逗號、分號、空格或換行分隔,並以小數點作為小數符號。接著選擇雙尾顯著水準 α(0.10、0.05、0.025 或 0.01)。順序很重要,因為資料不會被排序。至少需要兩個數值,且至少必須有一個數值高於中位數、一個數值低於中位數。
公式
游程是指連續且正負號相同的一組數值。若觀察到 \(R\) 個游程,檢定統計量為:
$$Z = \frac{R - \bar{R}}{s_R}$$在隨機性假設下,期望游程數與變異數為:
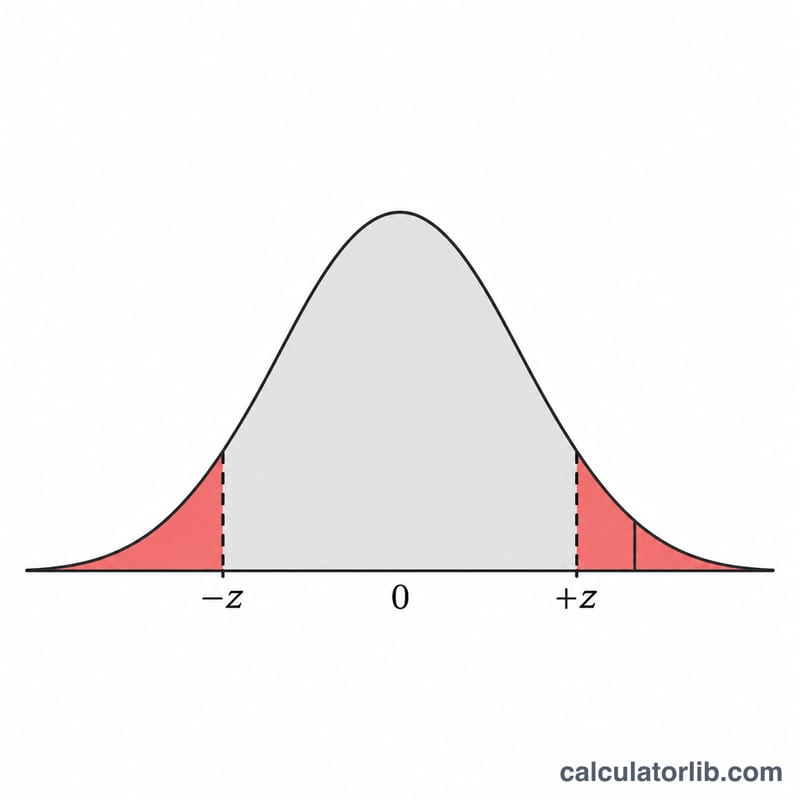
$$\bar{R} = \frac{2 n_1 n_2}{n_1 + n_2} + 1$$$$s_R^2 = \frac{2 n_1 n_2(2 n_1 n_2 - n_1 - n_2)}{(n_1+n_2)^2 (n_1+n_2-1)}$$其中 \(n_1\) 為高於中位數的數值個數,\(n_2\) 為低於中位數的數值個數,\(R\) 為觀察到的游程數,\(\bar{R}\) 為期望游程數,\(s_R\) 為游程的標準差。雙尾 p 值為 \(p = 2(1-\Phi(|Z|))\),其中 \(\Phi\) 為標準常態累積分配函數。當 \(|Z| > z_{1-\alpha/2}\) 時,拒絕隨機性假設。
慣例與假設
- 高於中位數的數值為正,低於中位數的數值為負;游程是指連續且正負號相同的數值區塊。
- 來源並未說明如何處理等於中位數的數值。作為設計選擇,這些數值會被省略,其餘數值保持原有順序,並回報被省略的數量。\(n_1\) 與 \(n_2\) 僅計算正值與負值。
- 中位數為所有輸入數值的標準樣本中位數:奇數個數時為中間值,偶數個數時為中間兩個值的平均。
- 不套用連續性校正。
- 判定採嚴格標準:\(|Z|\) 與臨界值相等時不拒絕。5% 臨界值為 1.96。
- 一律採用常態近似。當 \(n_1 \le 10\) 或 \(n_2 \le 10\) 時會顯示小樣本警告,因為本工具未實作精確表。
- 統計量與 p 值以四位小數顯示;內部數值未經捨入。
計算範例
預設的 20 個數值序列,中位數為 3.95,且沒有數值等於中位數。高於中位數的有 10 個,低於中位數的有 10 個,因此 \(n_1 = 10\)、\(n_2 = 10\),該序列共有 \(R = 14\) 個游程。
$$\bar{R} = \frac{2 \times 10 \times 10}{20} + 1 = 11$$游程的標準差為 \(s_R = 2.1764\),因此:
$$Z = \frac{14 - 11}{2.1764} = 1.3784$$雙尾 p 值為 0.1681,在 \(\alpha = 0.05\) 時的臨界值為 1.9600。由於 \(1.3784 < 1.9600\),不拒絕隨機性假設。因為 \(n_1 \le 10\),小樣本警告會顯示。
結果解讀與限制
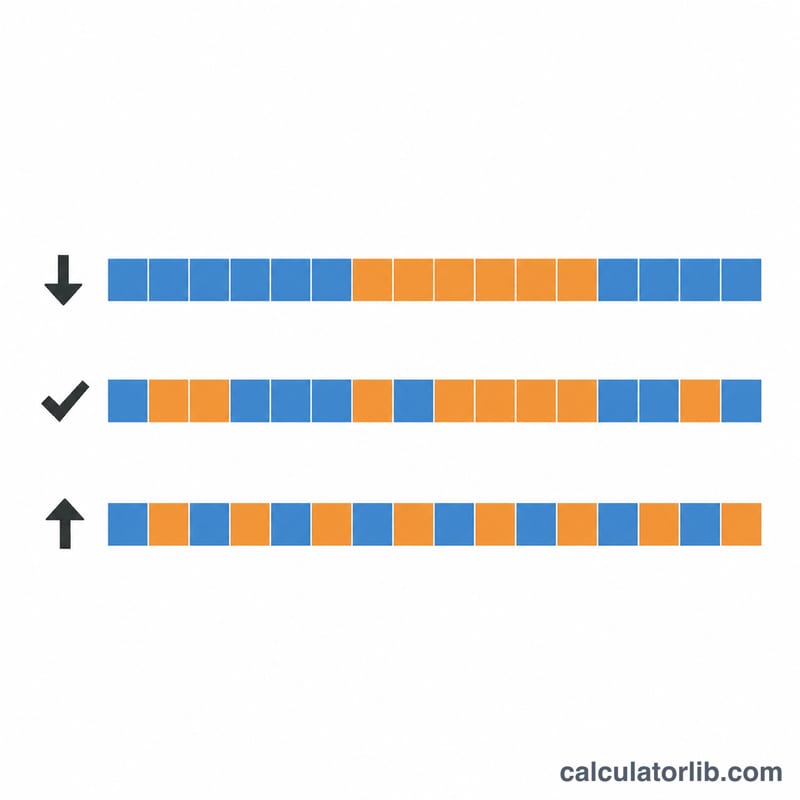
游程過少表示可能存在群聚或趨勢;游程過多則表示可能呈交替變化。當 \(|Z|\) 很大且 p 值低於 α 時,表示存在非隨機性。未能拒絕並不代表資料具有隨機性,僅表示此檢定未發現反對隨機性的證據。中位數分割對某些模式並不敏感,例如離散程度的緩慢變化。在小樣本情況下,常態近似可能不準確,因此對於臨界結果應謹慎看待。
常見問題
游程檢定檢查什麼?
它依據序列在高於中位數與低於中位數的數值之間切換的頻率,檢查數值的順序看起來是否隨機。
等於中位數的數值如何處理?
這些數值會從序列中移除,並回報被移除的數量。其餘數值保持原有順序。
為何會有小樣本警告?
當 \(n_1\) 與 \(n_2\) 都超過 10 時,常態近似效果最佳。低於此標準時,精確表會更適合,但本工具並未納入。
資料順序重要嗎?
重要。資料會完全依照輸入的順序使用,重新排序會改變游程數。
何時會拒絕隨機性?
當 \(|Z|\) 嚴格大於所選 α 對應的常態臨界值時拒絕,這等同於 p 值低於 α。
資料來源
- 1.3.5.13. Runs Test for Detecting Non-randomness,NIST/SEMATECH 統計方法電子手冊