Ce que fait le calculateur du test des séries
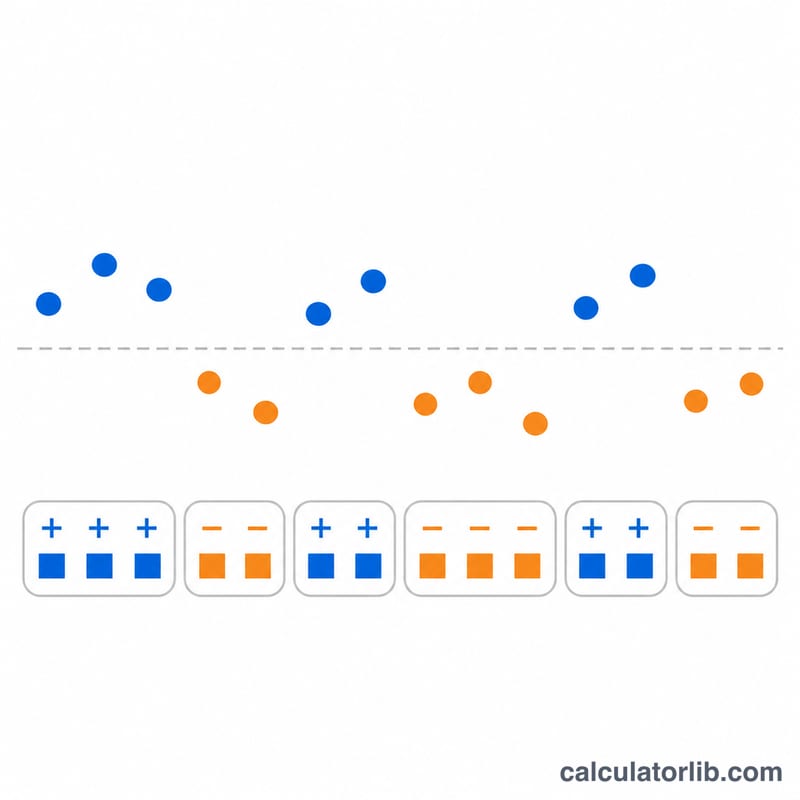
Ce calculateur applique le test des séries pour détecter la non-aléatoire à une suite ordonnée de nombres. Chaque valeur est codée comme supérieure (+) ou inférieure (-) à la médiane, les séries de ce motif sont comptées, puis ce nombre est comparé à celui qu'un ordre aléatoire produirait. Il renvoie le nombre de séries, le nombre attendu, l'écart type, la statistique Z, une p-valeur bilatérale et une décision de rejet ou de non-rejet. Il convient aux analystes qui vérifient des résidus, des mesures de processus ou toute série chronologique, à la recherche de tendances, de regroupements ou d'oscillations.
Mode d'emploi
Saisissez les valeurs dans l'ordre chronologique dans le champ des données, séparées par des virgules, des points-virgules, des espaces ou des retours à la ligne, avec un point comme séparateur décimal. Choisissez ensuite le niveau de signification bilatéral alpha (0,10, 0,05, 0,025 ou 0,01). L'ordre est essentiel, car les données ne sont jamais triées. Au moins deux valeurs numériques sont nécessaires, et au moins une valeur doit se situer au-dessus et une en dessous de la médiane.
La formule
Une série est une suite de valeurs consécutives de même signe. Avec \(R\) séries observées, la statistique du test est :
$$Z = \frac{R - \bar{R}}{s_R}$$Le nombre de séries attendu et la variance sous l'hypothèse de caractère aléatoire sont :
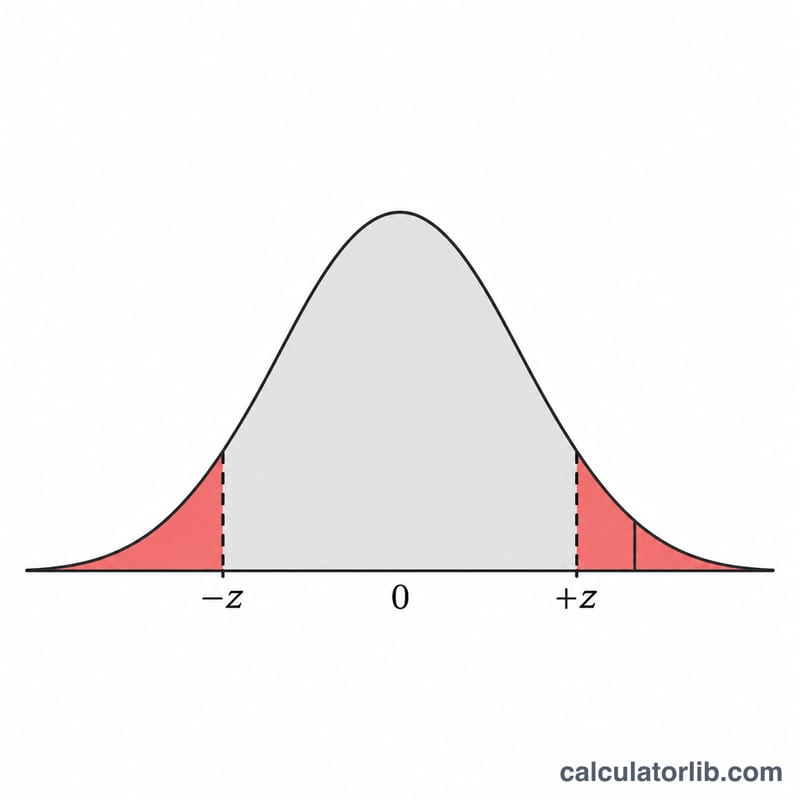
$$\bar{R} = \frac{2 n_1 n_2}{n_1 + n_2} + 1$$$$s_R^2 = \frac{2 n_1 n_2(2 n_1 n_2 - n_1 - n_2)}{(n_1+n_2)^2 (n_1+n_2-1)}$$Ici \(n_1\) est le nombre de valeurs au-dessus de la médiane, \(n_2\) le nombre de valeurs en dessous, \(R\) le nombre de séries observées, \(\bar{R}\) le nombre de séries attendu et \(s_R\) l'écart type des séries. La p-valeur bilatérale est \(p = 2(1-\Phi(|Z|))\), où \(\Phi\) est la fonction de répartition de la loi normale centrée réduite. Le caractère aléatoire est rejeté lorsque \(|Z| > z_{1-\alpha/2}\).
Conventions et hypothèses
- Les valeurs au-dessus de la médiane sont positives et celles en dessous sont négatives ; une série est un bloc de valeurs consécutives de même signe.
- La source ne précise pas comment traiter les valeurs égales à la médiane. Par choix de conception, elles sont omises, l'ordre des autres est conservé, et le nombre de valeurs omises est indiqué. \(n_1\) et \(n_2\) ne comptent que les valeurs positives et négatives.
- La médiane est la médiane échantillonnale standard de toutes les valeurs saisies : la valeur centrale pour un effectif impair, la moyenne des deux valeurs centrales pour un effectif pair.
- Aucune correction de continuité n'est appliquée.
- La décision est stricte : l'égalité entre \(|Z|\) et la valeur critique ne conduit pas au rejet. La valeur critique à 5 % est 1,96.
- L'approximation normale est toujours utilisée. Un avertissement de petit échantillon apparaît lorsque \(n_1 \le 10\) ou \(n_2 \le 10\), car les tables exactes ne sont pas implémentées.
- Les statistiques et la p-valeur sont affichées avec 4 décimales ; les valeurs internes ne sont pas arrondies.
Exemple commenté
La séquence par défaut de 20 valeurs a une médiane de 3,95, sans valeur égale à celle-ci. Dix valeurs sont au-dessus et dix en dessous, donc \(n_1 = 10\), \(n_2 = 10\), et la séquence compte \(R = 14\) séries.
$$\bar{R} = \frac{2 \times 10 \times 10}{20} + 1 = 11$$L'écart type des séries est \(s_R = 2{,}1764\), donc :
$$Z = \frac{14 - 11}{2{,}1764} = 1{,}3784$$La p-valeur bilatérale est 0,1681 et la valeur critique pour \(\alpha = 0{,}05\) est 1,9600. Comme \(1{,}3784 < 1{,}9600\), le caractère aléatoire n'est pas rejeté. Comme \(n_1 \le 10\), l'avertissement de petit échantillon est activé.
Lecture des résultats et limites
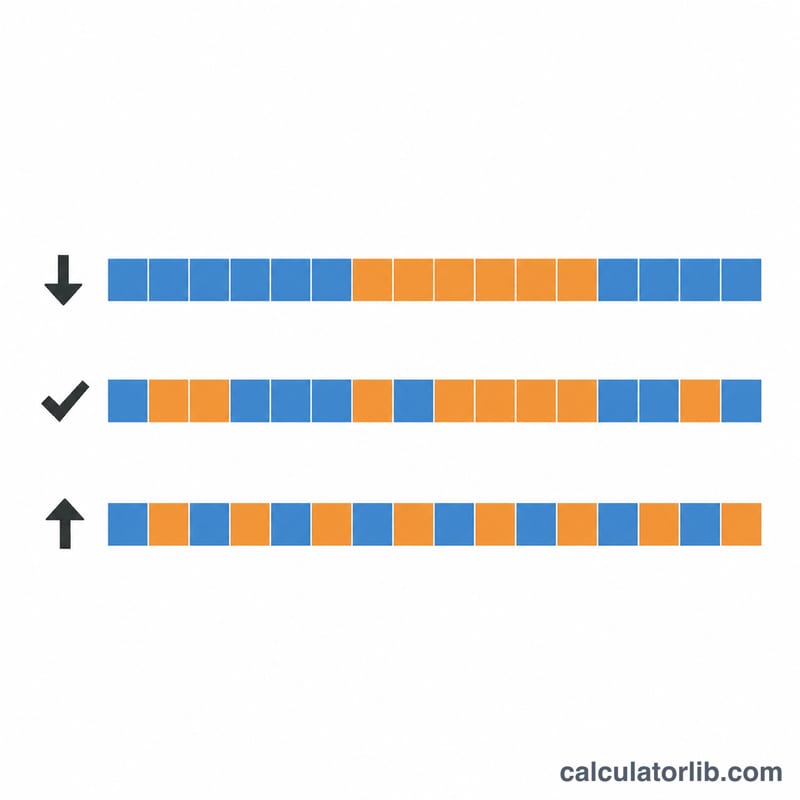
Trop peu de séries suggèrent un regroupement ou une tendance ; trop de séries suggèrent une alternance. Une valeur élevée de \(|Z|\) et une p-valeur inférieure à alpha indiquent une non-aléatoire. Ne pas rejeter ne prouve pas le caractère aléatoire, cela signifie seulement que ce test n'a trouvé aucun élément contraire. Le découpage par la médiane est insensible à certains motifs, comme les lentes variations de dispersion. Avec de petits groupes, l'approximation normale peut être imprécise ; interprétez donc les résultats limites avec prudence.
FAQ
Que vérifie le test des séries ?
Il vérifie si l'ordre des valeurs semble aléatoire, en se fondant sur la fréquence à laquelle la séquence passe de valeurs au-dessus de la médiane à des valeurs en dessous.
Comment traite-t-on les valeurs égales à la médiane ?
Elles sont retirées de la séquence, et leur nombre est indiqué. Les valeurs restantes conservent leur ordre.
Pourquoi un avertissement de petit échantillon apparaît-il ?
L'approximation normale fonctionne au mieux lorsque \(n_1\) et \(n_2\) dépassent tous deux 10. En dessous, des tables exactes seraient préférables et ne sont pas incluses.
L'ordre des données a-t-il de l'importance ?
Oui. Les données sont utilisées exactement telles que saisies, et réordonner modifie le nombre de séries.
Quand le caractère aléatoire est-il rejeté ?
Lorsque \(|Z|\) est strictement supérieur à la valeur critique normale pour le niveau alpha choisi, ce qui équivaut à une p-valeur inférieure à alpha.
Sources
- 1.3.5.13. Runs Test for Detecting Non-randomness, NIST/SEMATECH e-Handbook of Statistical Methods