本計算機的功能
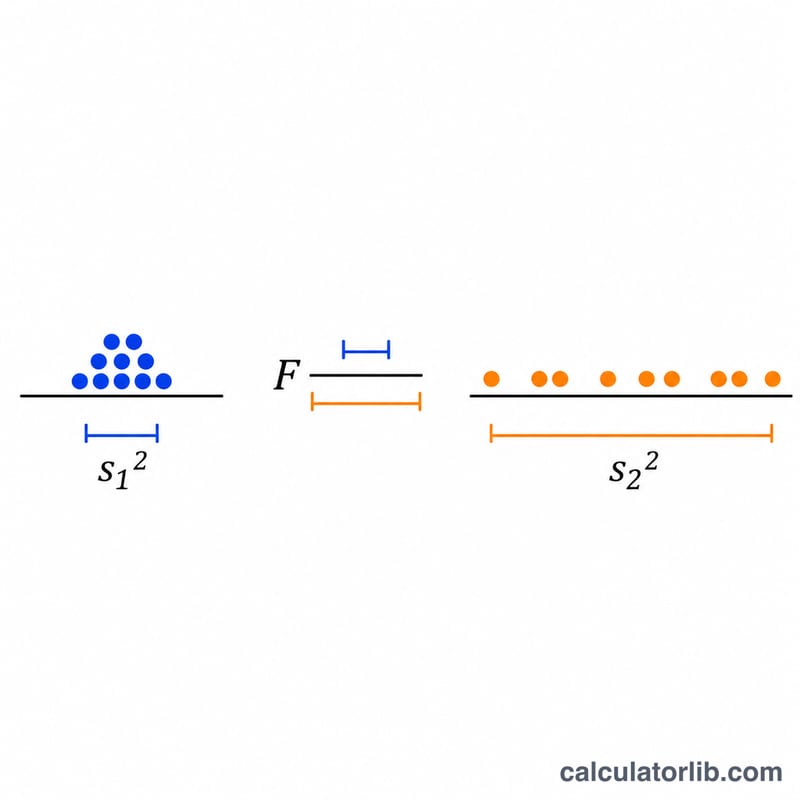
本計算機執行兩個母體變異數相等性的 F 檢定。輸入兩組原始樣本後,系統會計算各樣本變異數、F 統計量、兩個自由度、在您設定的顯著水準下的臨界值、p 值,以及拒絕或不拒絕的決策。適用對象包括學生、分析師與工程師,可在選擇後續方法(例如合併變異數 t 檢定或 Welch t 檢定)之前,先確認兩個製程、儀器或群組的離散程度是否相同。
使用方式
請依下列順序輸入資料:
- 樣本 1 資料:至少兩個數字,以逗號、分號、空格或換行分隔,小數點使用句點。
- 樣本 2 資料:輸入方式相同。
- 對立假設:雙尾(變異數不相等)、greater(變異數 1 較大)或 less(變異數 1 較小)。
- 顯著水準 alpha:例如 0.05,必須大於 0 且小於 0.5。
樣本 1 一律為比值的分子,因此對於單尾檢定,樣本的順序很重要。
公式
$$F = \frac{s_1^2}{s_2^2}, \qquad s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(x_i-\bar{x})^2$$
其中 \(s_1^2\) 與 \(s_2^2\) 為樣本變異數,\(x_i\) 為觀測值,\(\bar{x}\) 為樣本平均數,\(N\) 為樣本大小。當虛無假設成立且資料為常態分布時,此統計量服從分子自由度為 \(N_1-1\)、分母自由度為 \(N_2-1\) 的 F 分布。
慣例與假設
- 變異數以 \(n-1\) 作為除數,且樣本 1 為分子。
- 自由度為 \(N_1-1\) 與 \(N_2-1\)。
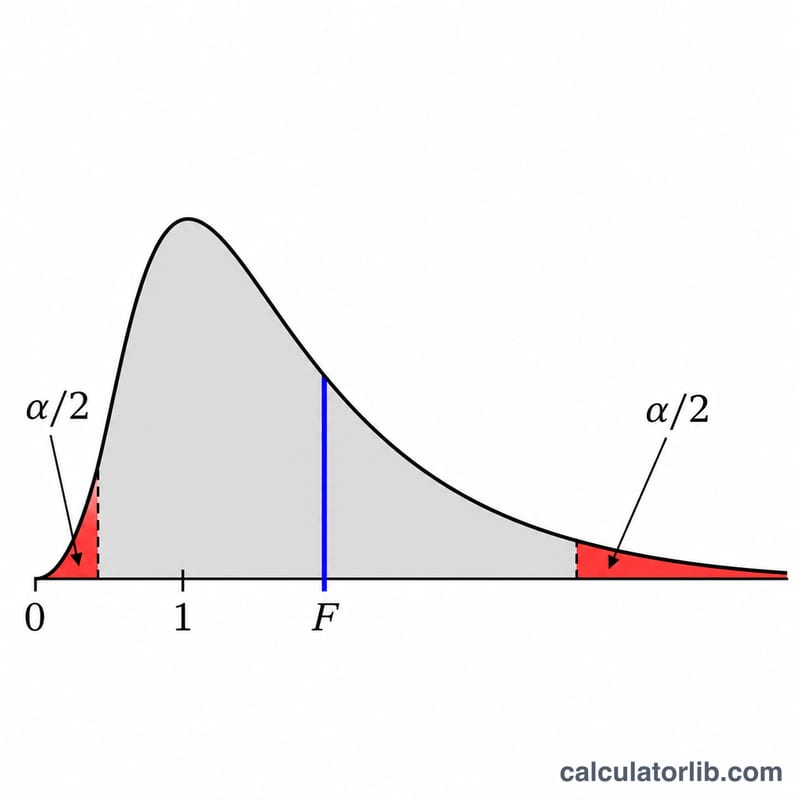
- 上尾對立假設:若 \(F\) 超過 \(1-\alpha\) 分位數則拒絕。下尾對立假設:若 \(F\) 低於 \(\alpha\) 分位數則拒絕。雙尾:若 \(F\) 低於 \(\alpha/2\) 分位數或高於 \(1-\alpha/2\) 分位數則拒絕。
- 不等式為嚴格不等式,因此恰好等於臨界值的 F 不會導致拒絕。
- greater 對立假設的 p 值為上尾機率,less 對立假設的 p 值為下尾機率。雙尾檢定的 p 值為 \(\min(1, 2\min(p_{\text{lower}}, p_{\text{upper}}))\)。此方法依循 NIST 的臨界區域,但 NIST 頁面未提供 p 值公式,因此這種雙尾加倍的規則是與those臨界區域一致的設計選擇。當且僅當 \(p<\alpha\) 時拒絕。
- 由於本檢定屬於參數檢定,不適用順位、並列值或連續性校正。
- 本檢定假設樣本彼此獨立且來自常態母體,並且對偏離常態性相當敏感。
- 結果以完整精度計算,並以約 4 至 6 位有效數字顯示。
範例
樣本 1 為 12.1、13.4、11.8、14.2、12.9、13.7、12.5、14.8(n = 8)。樣本 2 為 12.4、12.8、12.2、13.0、12.6、12.9、12.5(n = 7)。本檢定為雙尾檢定,\(\alpha = 0.05\)。
$$s_1^2 = 1.0850,\quad s_2^2 = 0.082381$$
$$F = \frac{1.0850}{0.082381} = 13.1705,\quad df_1 = 7,\ df_2 = 6$$
臨界值為 0.1954(下)與 5.6955(上)。由於 \(13.1705 > 5.6955\),故拒絕虛無假設。p 值為 0.005860,低於 0.05,證實了此決策。
結果解讀與限制
F 遠大於 1 表示樣本 1 的離散程度大於樣本 2;F 接近 0 則表示相反情況。較小的 p 值是反對變異數相等的證據。較大的 p 值則表示資料未顯示差異,但這並非相等的證明,特別是在樣本較小時。當資料有偏態或厚尾時,F 檢定的穩健性遠低於 Levene 或 Brown-Forsythe 檢定,因此請先檢查常態性。若樣本 2 的變異數為零,F 將無定義。
常見問題
顯著結果代表什麼?
p 值低於 alpha,表示若兩個母體的變異數相同,觀察到的變異數比值將不太可能出現。
樣本的順序重要嗎?
交換樣本會得到 \(1/F\),並使單尾對立假設互換。雙尾決策保持不變。
為何雙尾 p 值要加倍?
雙尾檢定將 alpha 平均分配於兩個尾部,因此將較小的尾部機率加倍,並以 1 為上限。
需要多少觀測值?
每個樣本至少需要兩個值,但小樣本偵測真實差異的檢定力很低。
如果我的資料不是常態分布怎麼辦?
F 檢定可能產生誤導性結果。建議考慮較穩健的檢定,例如 Levene 檢定。
資料來源
- 1.3.5.9. F-Test for Equality of Two Variances,NIST/SEMATECH e-Handbook of Statistical Methods。