この計算機の機能
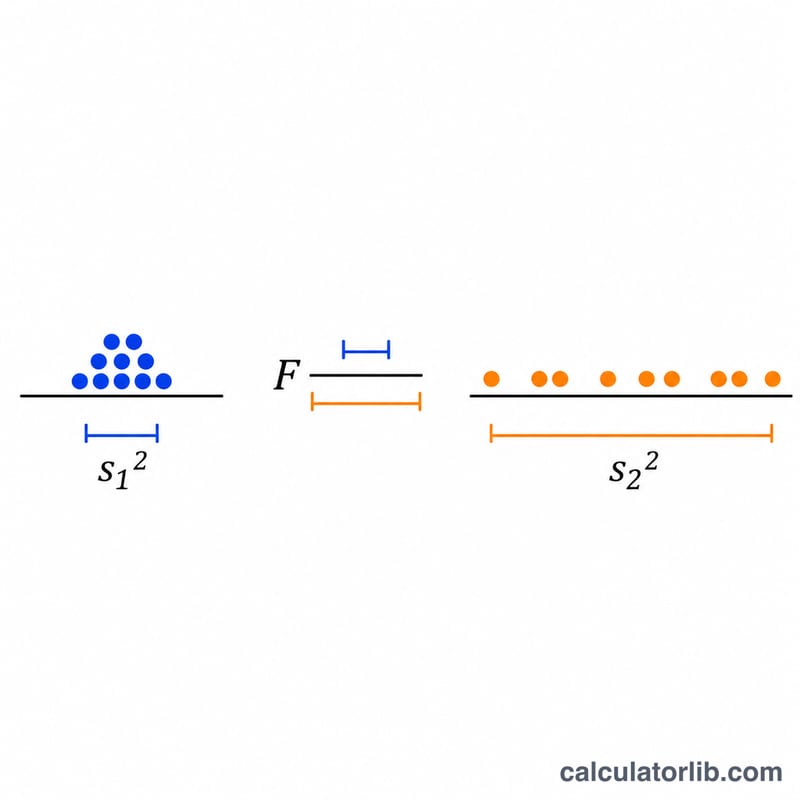
この計算機は、2つの母集団分散が等しいかどうかを調べるF検定を実行します。2組の生データを貼り付けると、各標本の分散、F統計量、両方の自由度、指定した有意水準での臨界値、p値、そして棄却または棄却しないの判定を計算します。学生、アナリスト、技術者が、2つの工程、測定器、または群のばらつきが同じかどうかを確認し、その後にプールしたt検定やWelchのt検定などの後続手法を選ぶ際に役立ちます。
使い方
次の順序で入力してください:
- 標本1のデータ: カンマ、セミコロン、スペース、改行で区切った2つ以上の数値。小数点はピリオドを使います。
- 標本2のデータ: 同じ形式で入力します。
- 対立仮説: 両側(分散は等しくない)、greater(分散1が大きい)、less(分散1が小さい)から選択します。
- 有意水準 alpha: 0.05 などの値。0より大きく0.5未満である必要があります。
標本1は常に比の分子になるため、片側検定では標本の順序が結果に影響します。
公式
$$F = \frac{s_1^2}{s_2^2}, \qquad s^2 = \frac{1}{N-1}\sum_{i=1}^{N}(x_i-\bar{x})^2$$
ここで \(s_1^2\) と \(s_2^2\) は標本分散、\(x_i\) は観測値、\(\bar{x}\) は標本平均、\(N\) は標本サイズです。帰無仮説が成り立ち、データが正規分布に従う場合、この統計量は分子の自由度 \(N_1-1\)、分母の自由度 \(N_2-1\) のF分布に従います。
前提条件と仮定
- 分散には除数 \(n-1\) を用い、標本1を分子とします。
- 自由度は \(N_1-1\) と \(N_2-1\) です。
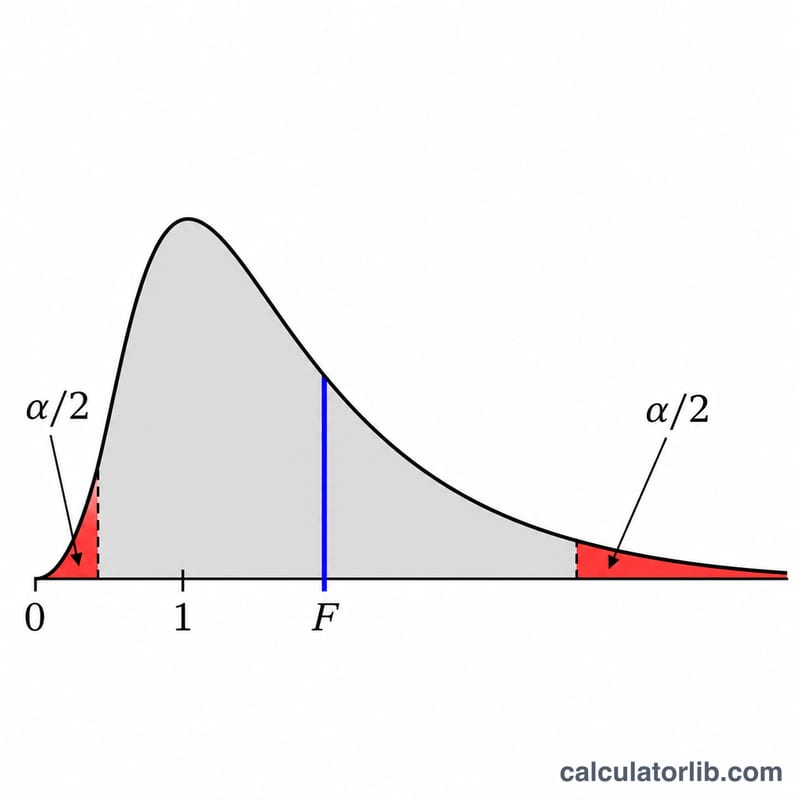
- 上側の対立仮説では、\(F\) が \(1-\alpha\) 分位点を超える場合に棄却します。下側の対立仮説では、\(F\) が \(\alpha\) 分位点を下回る場合に棄却します。両側検定では、\(F\) が \(\alpha/2\) 分位点を下回るか、\(1-\alpha/2\) 分位点を上回る場合に棄却します。
- 不等号は厳密なので、F が臨界値とちょうど等しい場合は棄却しません。
- p値は、greater の対立仮説では上側裾、less の対立仮説では下側裾の確率です。両側検定では \(\min(1, 2\min(p_{\text{lower}}, p_{\text{upper}}))\) となります。この方法はNISTの棄却域に従いますが、NISTのページにはp値の公式が示されていないため、この両裾の倍化規則は棄却域と整合する設計上の選択です。\(p<\alpha\) のときに限り棄却します。
- 本検定はパラメトリック検定であるため、順位、同順位、連続性の補正は適用されません。
- 本検定は独立な標本が正規母集団から得られていることを仮定しており、正規性からの逸脱に敏感です。
- 結果は完全な精度で計算され、およそ4〜6桁の有効数字で表示されます。
計算例
標本1は 12.1, 13.4, 11.8, 14.2, 12.9, 13.7, 12.5, 14.8 です(n = 8)。標本2は 12.4, 12.8, 12.2, 13.0, 12.6, 12.9, 12.5 です(n = 7)。検定は有意水準 \(\alpha = 0.05\) の両側検定です。
$$s_1^2 = 1.0850,\quad s_2^2 = 0.082381$$
$$F = \frac{1.0850}{0.082381} = 13.1705,\quad df_1 = 7,\ df_2 = 6$$
臨界値は 0.1954(下側)と 5.6955(上側)です。\(13.1705 > 5.6955\) なので、帰無仮説は棄却されます。p値は 0.005860 で、0.05 より小さく、この判定を裏付けています。
結果の解釈と限界
F が1よりはるかに大きい場合は標本1のほうがばらつきが大きいことを、0に近い場合はその逆を意味します。p値が小さいことは、分散が等しいという仮説に対する証拠となります。p値が大きい場合は、データに差が見られないことを意味しますが、等しいことの証明にはなりません。特に標本が小さい場合はそうです。データが歪んでいる場合や裾が重い場合、F検定はLevene検定やBrown-Forsythe検定よりも頑健性がはるかに低いため、まず正規性を確認してください。標本2の分散がゼロの場合、Fは定義されません。
よくある質問
有意な結果とはどういう意味ですか?
p値が alpha を下回っているため、両方の母集団の分散が等しいと仮定すると、観測された分散比は起こりにくいことを意味します。
標本の順序は重要ですか?
標本を入れ替えると \(1/F\) になり、片側の対立仮説も入れ替わります。両側検定の判定は変わりません。
両側検定のp値を2倍するのはなぜですか?
両側検定では alpha を両裾に等しく分配するため、小さい方の裾の確率を2倍し、上限を1とします。
必要な観測数はどのくらいですか?
各標本で少なくとも2つ必要ですが、標本が小さいと実際の差を検出する検出力は低くなります。
データが正規分布でない場合はどうすればよいですか?
F検定は誤解を招く結果を出すことがあります。Leveneの検定など、より頑健な検定を検討してください。
出典
- 1.3.5.9. F-Test for Equality of Two Variances、NIST/SEMATECH 統計手法のe-Handbook。