この計算機の機能
この計算機は、正規分布に従うと仮定したデータについて、k係数と許容限界 \(\bar{Y} \pm k s\) を求めます。許容区間とは、標本ではなく母集団全体の少なくとも指定した割合を、指定した信頼度で含むと予想される範囲のことです。個々の測定値がどの範囲に入るかを説明する必要がある技術者、品質分析担当者、研究者に適しています。

使い方
区間の種類として、両側か片側(下限と上限をそれぞれ独立に設定)を選びます。標本平均、標本標準偏差(n-1で割る、0以上)、標本サイズN(2以上の整数)を入力します。被覆率pと信頼水準は、0と1の間の値(例:0.90や0.99)で入力します。平均と標準偏差は有効な数値である必要があり、数値として読めない入力は計算前に修正してください。
計算式
両側係数(Howeの近似):
$$k_2 = z_{(1+p)/2}\sqrt{\frac{\nu\,(1+1/N)}{\chi^2_{1-\gamma,\nu}}}$$片側係数(Natrella):
$$k_1=\frac{z_p+\sqrt{z_p^2-ab}}{a},\quad a=1-\frac{z_\gamma^2}{2(N-1)},\quad b=z_p^2-\frac{z_\gamma^2}{N}$$限界値:
$$\bar{Y}-ks \quad\text{および}\quad \bar{Y}+ks$$ここで \(p\) は被覆率、\(\gamma\) は信頼度、\(N\) は標本サイズ、\(\nu = N-1\) は自由度、\(z_q\) は累積確率qにおける標準正規分布の分位点、\(\chi^2_{1-\gamma,\nu}\) は累積確率 \(1-\gamma\) におけるカイ二乗分布の分位点、\(\bar{Y}\) は標本平均、\(s\) は標本標準偏差です。
前提と規約
- 両側のkは、NIST/SEMATECHハンドブックに示されたHowe(1969)の近似を用います。カイ二乗項は確率 1 から信頼度を引いた値における下側分位点で、ハンドブックの例(列0.01、自由度42、23.650)と一致します。
- ハンドブックでは信頼水準をαと呼びますが、本計算機では信頼度と呼び、割合として入力します。
- Guentherの補正は適用せず、素のHowe係数を返します。
- 片側のkはNatrellaの式を用い、正規分位点のみを必要とします。非心t法は提供していません。
- 自由度はN-1です。平均と標準偏差の両方を1つの標本から推定するためです。
- 片側モードでは、下限と上限はそれぞれ独立した片側限界であり、両側の組ではありません。被覆率は0.5以上である必要があります。
- 分位点は丸めた表ではなく、倍精度の逆分布関数から求めます。k係数と限界値は小数点以下4桁で表示します。
計算例
両側、\(N=43\)、\(p=0.90\)、\(\gamma=0.99\)、平均100、\(s=5\)。このとき \(\nu=42\) であり、
$$k_2 = 2.2173$$限界値は次のとおりです:
$$100 - 2.2173\times 5 = 88.9134$$$$100 + 2.2173\times 5 = 111.0866$$信頼度99%で、母集団の少なくとも90%が88.9134から111.0866の間に入ります。自由度は42です。
結果の読み方と制約
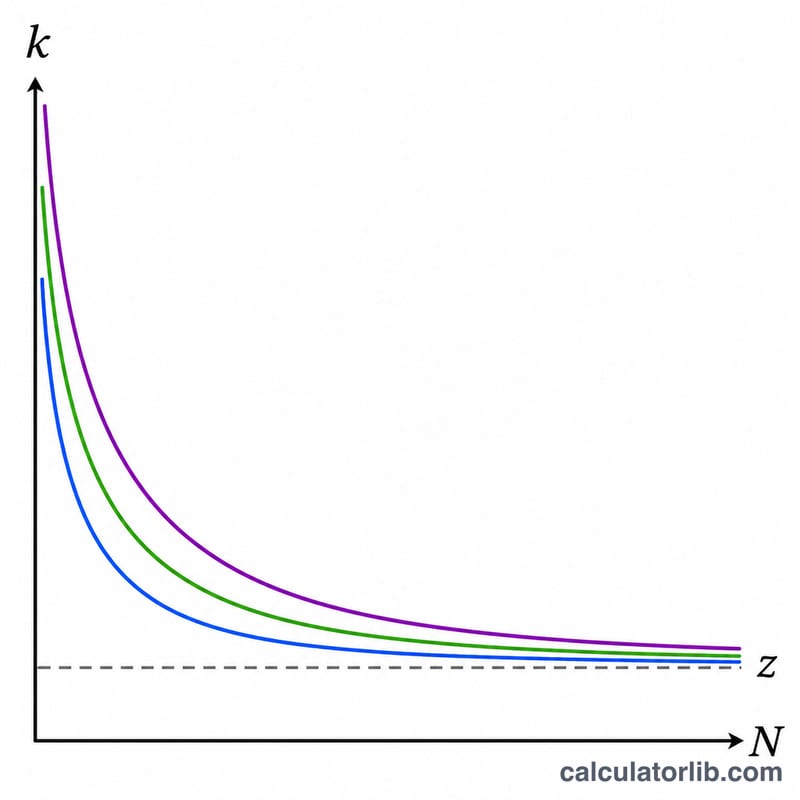
kが大きいほど区間は広くなります。kはNが大きくなるにつれ正規分位点に近づき、被覆率や信頼度が高いほど大きくなります。結果は正規性とランダム抽出を仮定しています。裾の重い分布や外れ値があると結果は無効になります。小標本(Nが10以下)の場合、片側Natrella近似は非心t法より明らかに精度が低くなります。出典では、N = 6 のとき5.2808に対し4.4111となっています。Nが非常に小さく、pや信頼度が高い場合は実数のkが存在しないことがあり、その場合は標本サイズを増やす必要があります。標準偏差が0の場合、限界値は平均に等しくなります。
よくある質問
許容区間と信頼区間はどう違いますか?
信頼区間は平均などのパラメータを推定します。許容区間は、母集団の個々の値のうち指定した割合を囲む範囲を定めます。
被覆率と信頼度とは何ですか?
被覆率は、区間が含むべき母集団の最小割合です。信頼度は、この方法で作成した区間が長期的に被覆率を達成する確率です。
片側モードでエラーが表示されるのはなぜですか?
非常に小さな標本で被覆率や信頼度が高い場合、近似に実数解が存在しないことがあります。Nを増やすか、水準を下げてください。
正規分布でないデータにも使えますか?
確実ではありません。先に正規性を確認するか、データを変換してください。
印刷された表と結果がわずかに異なるのはなぜですか?
表は丸められており、正確な係数を使っている場合もあります。本ツールは倍精度で近似を直接計算します。
出典
- 7.2.6.3. 正規分布の許容区間、NIST/SEMATECH e-Handbook of Statistical Methods