本計算機的功能
本計算機針對假設來自常態分布的資料,求出 k 係數與容許界限 \(\bar{Y} \pm k s\)。容許區間是指在既定信賴水準下,預期至少包含整體母體中既定比例的範圍,而非僅指樣本。它適合需要描述大多數個別數值落點的工程師、品質分析人員與研究人員。

使用方法
請選擇區間類型:雙側,或單側(下界與上界各自獨立)。輸入樣本平均數、樣本標準差(除數為 n-1,可為零或正數),以及樣本數 N(整數,至少為 2)。涵蓋比例 p 與信賴水準請以嚴格介於 0 與 1 之間的比例輸入,例如 0.90 與 0.99。平均數與標準差必須為有效數值;無法解讀為數字的輸入,應在計算前更正。
公式
雙側係數(Howe 近似):
$$k_2 = z_{(1+p)/2}\sqrt{\frac{\nu\,(1+1/N)}{\chi^2_{1-\gamma,\nu}}}$$單側係數(Natrella):
$$k_1=\frac{z_p+\sqrt{z_p^2-ab}}{a},\quad a=1-\frac{z_\gamma^2}{2(N-1)},\quad b=z_p^2-\frac{z_\gamma^2}{N}$$界限:
$$\bar{Y}-ks \quad\text{和}\quad \bar{Y}+ks$$其中 \(p\) 為涵蓋比例,\(\gamma\) 為信賴水準,\(N\) 為樣本數,\(\nu = N-1\) 為自由度,\(z_q\) 為累積機率 q 下的標準常態分位數,\(\chi^2_{1-\gamma,\nu}\) 為累積機率 \(1-\gamma\) 下的卡方分位數,\(\bar{Y}\) 為樣本平均數,\(s\) 為樣本標準差。
慣例與假設
- 雙側 k 採用 NIST/SEMATECH 手冊所載的 Howe 1969 年近似法。卡方項為機率 1 減信賴水準下的下分位數,與手冊範例相符(欄位 0.01、自由度 42、數值 23.650)。
- 手冊將信賴水準稱為 alpha;本計算機稱之為信賴水準,並以比例輸入。
- 未套用 Guenther 修正;本計算機回傳原始的 Howe 係數。
- 單側 k 採用 Natrella 公式,僅需常態分位數。本計算機未提供非中心 t 方法。
- 自由度為 N-1,因為一個樣本同時估計平均數與標準差。
- 在單側模式下,下界與上界為各自獨立的單側界限,而非雙側一組。涵蓋比例至少須為 0.5。
- 分位數來自雙精度的反分布函數,而非四捨五入的表格。k 係數與界限以小數點後 4 位顯示。
計算範例
雙側,\(N=43\),\(p=0.90\),\(\gamma=0.99\),平均數 100,\(s=5\)。則 \(\nu=42\),且
$$k_2 = 2.2173$$界限為:
$$100 - 2.2173\times 5 = 88.9134$$$$100 + 2.2173\times 5 = 111.0866$$在 99% 信賴水準下,至少 90% 的母體落在 88.9134 與 111.0866 之間。自由度為 42。
結果解讀與限制
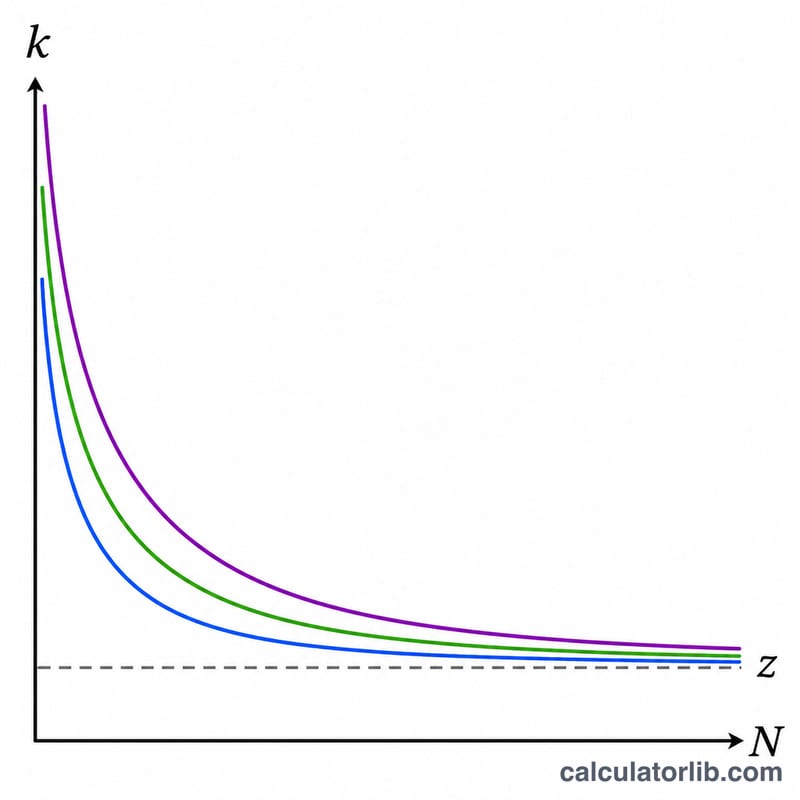
k 越大,區間越寬。隨著 N 增加,k 係數會趨近於常態分位數;涵蓋比例或信賴水準越高,k 係數越大。結果假設資料為常態且為隨機抽樣;厚尾或離群值會使結果失效。小樣本(N 為 10 或以下)時,單側 Natrella 近似的精確度明顯低於非中心 t 方法;來源資料顯示 N = 6 時分別為 5.2808 與 4.4111。若 N 很小而 p 或信賴水準很高,可能不存在實數 k,此時須增加樣本數。標準差為零時,界限等於平均數。
常見問題
容許區間與信賴區間有何不同?
信賴區間估計的是母數,例如平均數。容許區間則界定母體中既定比例之個別數值的範圍。
涵蓋比例與信賴水準代表什麼?
涵蓋比例是區間應包含的母體最低比例。信賴水準則是以此方式建立的區間,長期而言能達到該涵蓋比例的機率。
為什麼單側模式會出現錯誤?
在樣本很小且涵蓋比例或信賴水準很高時,近似式可能沒有實數解。請增加 N 或降低水準。
可以用於非常態資料嗎?
結果不可靠。請先檢定常態性,或先對資料進行轉換。
為什麼我的結果與印刷表格略有不同?
表格經過四捨五入,且可能使用精確係數;本工具則以雙精度直接計算近似值。
資料來源
- 7.2.6.3. Tolerance intervals for a normal distribution,NIST/SEMATECH e-Handbook of Statistical Methods