Этот счётчик токенов OpenAI работает на библиотеке JTokkit v1.1.0 — открытой Java-реализации токенизатора tiktoken от OpenAI.
Зависимость Maven: com.knuddels:jtokkit:1.1.0
JTokkit разрабатывает и поддерживает компания Knuddels GmbH; библиотека распространяется по лицензии MIT.
Как это устроено внутри
Подсчёт токенов реализован так:
// Зависимость Maven
implementation 'com.knuddels:jtokkit:1.1.0'

// Реализация подсчёта токенов
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Пример использования
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit разбивает текст на токены точно так же, как официальная библиотека tiktoken от OpenAI, поэтому результаты подсчёта совпадают с реальным биллингом API.
Руководство по подсчёту токенов OpenAI
Что такое токенизация?
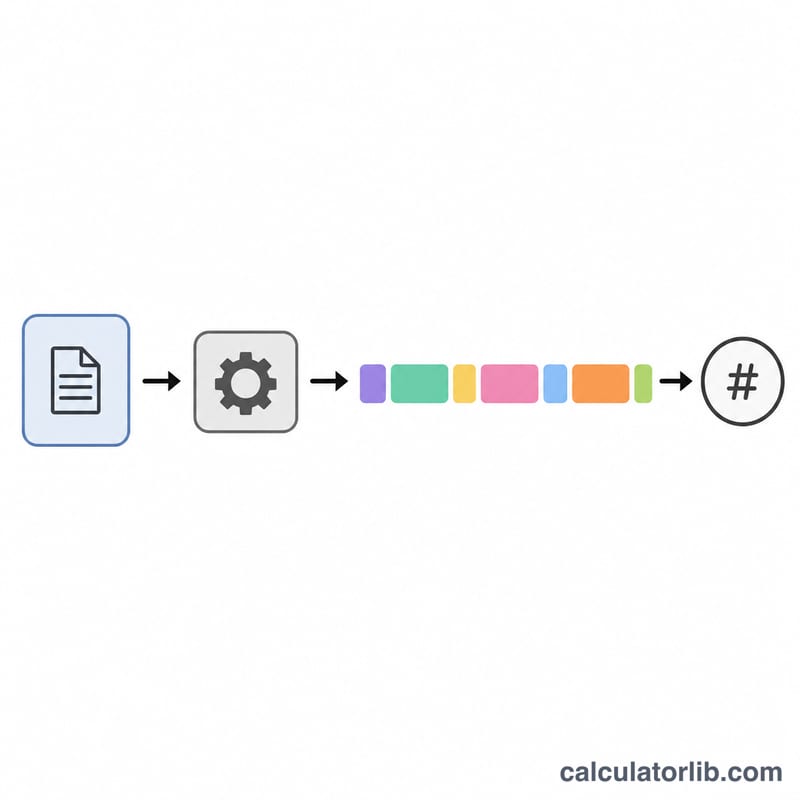
Токенизация — это разбиение текста на небольшие фрагменты, которые называются токенами. Модели OpenAI работают именно с токенами, а не с отдельными символами или словами. Токен может быть длиной в один символ, а может совпадать с целым словом (например, «a» или «apple»). Частотные слова обычно укладываются в один токен, а редкие разбиваются на несколько частей.
Количество токенов вычисляется так:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$Важно: у разных моделей разные токенизаторы, и число токенов напрямую влияет на:
- стоимость запросов к API (оплата идёт за токены и на входе, и на выходе — тарифы OpenAI указаны в долларах США);
- заполнение контекстного окна (у каждой модели есть жёсткий лимит токенов);
- скорость обработки (чем больше токенов, тем дольше ответ).
Типы кодировок
JTokkit поддерживает несколько кодировок, полностью соответствующих токенизаторам OpenAI:
| Кодировка | Описание | Где применяется |
|---|---|---|
cl100k_base |
Токенизатор GPT-4, GPT-4 Turbo, GPT-3.5 Turbo и моделей эмбеддингов text-embedding-3 / ada-002 | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
Расширенный словарь, более аккуратная разбивка исходного кода | GPT-3 davinci, curie, babbage, ada; модели Codex |
p50k_edit |
Специальная кодировка для моделей редактирования текста | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
Исходный токенизатор GPT-3 с базовым словарём | Старые модели davinci, curie, babbage, ada |
o200k_base |
Актуальный токенизатор моделей OpenAI GPT-5, GPT-4.1, GPT-4o и серии o (по данным tiktoken от OpenAI) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
Модели и контекстные окна
У каждой модели OpenAI есть максимальное контекстное окно — предельное число токенов, которое она может обработать за один запрос:
| Модель | Максимум токенов | Кодировка |
|---|---|---|
gpt-4 |
8 192 | cl100k_base |
gpt-4-32k |
32 768 | cl100k_base |
gpt-4-turbo |
128 000 | cl100k_base |
gpt-4o |
128 000 | o200k_base |
gpt-4o-mini |
128 000 | o200k_base |
gpt-3.5-turbo |
4 096 | cl100k_base |
gpt-3.5-turbo-16k |
16 384 | cl100k_base |
text-embedding-ada-002 |
8 191 | cl100k_base |
text-davinci-003 |
4 097 | p50k_base |
code-davinci-002 |
8 001 | p50k_base |
davinci |
2 049 | r50k_base |
Полный список моделей, доступных в калькуляторе, вы найдёте в выпадающем списке выше — кодировка подставляется автоматически.
Методы подсчёта токенов
Калькулятор предлагает два способа подсчёта:
| Метод | Стандартный | Обычный (ordinary) |
|---|---|---|
encode() |
Полная токенизация: возвращает идентификаторы токенов и особым образом обрабатывает HTML | encodeOrdinary() считает HTML обычным текстом |
countTokens() |
Оптимизированный метод: только считает токены, HTML обрабатывается особым образом | countTokensOrdinary() считает HTML обычным текстом |
Что происходит с HTML: если в тексте есть разметка, стандартные методы распознают теги и обрабатывают их отдельно, а «обычные» методы воспринимают их как рядовые символы. Из-за этого итоговые числа могут отличаться. Выбирайте обычные методы, когда нужно, чтобы HTML попал в модель ровно в том виде, в каком вы его написали.
Советы по экономии токенов
- Повторяющийся текст обычно расходует меньше токенов, чем уникальный текст той же длины;
- пробельные символы (пробелы, табуляции, переводы строк) тоже считаются токенами;
- спецсимволы нередко токенизируются поштучно и раздувают счёт;
- частотные слова дешевле редких и узкоспециальных терминов;
- тексты не на английском — в том числе русские — обычно требуют заметно больше токенов, чем такой же текст по-английски;
- исходный код экономно разбивается новыми токенизаторами (o200k_base, cl100k_base).
Типичные примеры подсчёта
| Текст | Токенов | Комментарий |
|---|---|---|
| «Hello world» | 2 | Частотные слова укладываются в один токен |
| «antidisestablishmentarianism» | 5 | Длинные слова дробятся на несколько токенов |
| «こんにちは» | 3 | Нелатинские символы требуют больше токенов |
| «1234567890» | 3 | Числа режутся на группы цифр |
| «<div>Hello</div>» | 4–6 | HTML-теги считаются по-разному в стандартном и обычном режимах |