이 OpenAI 토큰 계산기는 OpenAI의 tiktoken을 자바로 구현한 오픈소스 라이브러리 JTokkit v1.1.0을 사용합니다.
Maven 의존성: com.knuddels:jtokkit:1.1.0
JTokkit은 Knuddels GmbH가 개발·관리하며 MIT 라이선스로 배포됩니다.
구현 방식
이 토큰 계산기는 다음과 같이 구성되어 있습니다.
// Maven 의존성
implementation 'com.knuddels:jtokkit:1.1.0'

// 토큰 계산 구현
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// 사용 예시
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit은 OpenAI 공식 tiktoken 라이브러리와 동일한 방식으로 토큰화하므로, 결과 토큰 수도 그대로 일치합니다.
OpenAI 토큰 계산기 사용 가이드
토큰화란?
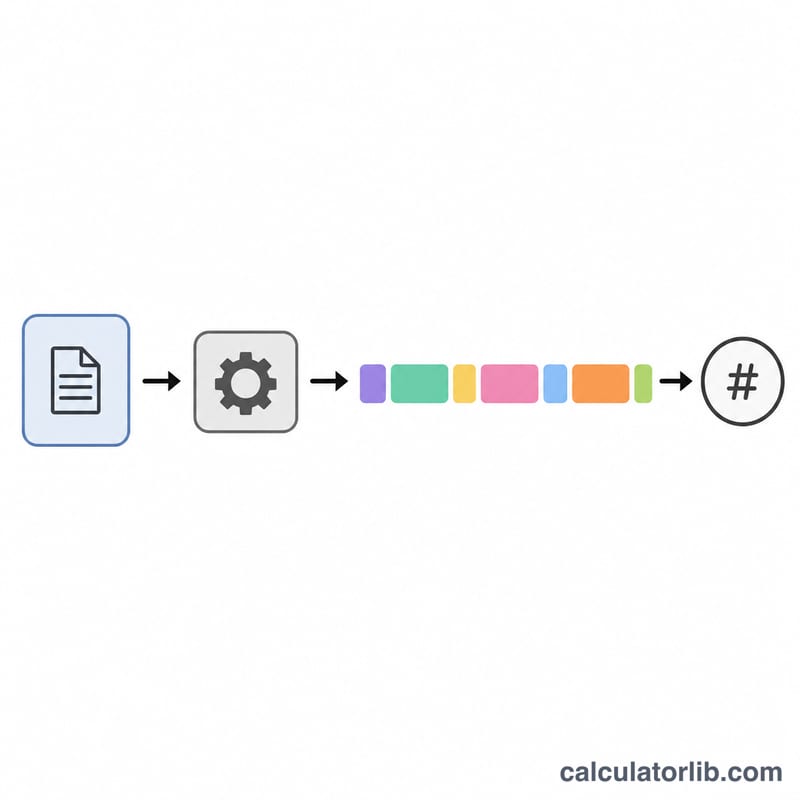
토큰화(tokenization)는 텍스트를 '토큰'이라는 작은 단위로 쪼개는 과정입니다. OpenAI 모델은 글자나 단어가 아니라 이 토큰 단위로 텍스트를 처리합니다. 토큰은 한 글자만큼 짧을 수도, 단어 하나만큼 길 수도 있습니다(예: "a" 또는 "apple"). 자주 쓰이는 단어는 대개 토큰 하나로 처리되지만, 드문 단어는 여러 토큰으로 나뉩니다.
토큰 수는 다음과 같이 정의됩니다.
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$중요: 모델마다 사용하는 토크나이저가 다르며, 토큰 수는 다음 세 가지에 직접적인 영향을 줍니다.
- API 요금 — 입력과 출력 모두 토큰 단위로 과금됩니다
- 컨텍스트 윈도우 — 모든 모델에는 처리 가능한 최대 토큰 수가 정해져 있습니다
- 응답 속도 — 토큰이 많을수록 처리 시간이 길어집니다
인코딩 방식
JTokkit은 OpenAI 토크나이저와 동일한 여러 인코딩 방식을 제공합니다.
| 인코딩 | 설명 | 사용 모델 |
|---|---|---|
cl100k_base |
GPT-4, GPT-4 Turbo, GPT-3.5 Turbo 및 임베딩 모델 text-embedding-3 / ada-002의 토크나이저 | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
어휘를 보강해 코드 처리 성능을 높인 방식 | GPT-3 davinci, curie, babbage, ada 및 Codex 계열 |
p50k_edit |
편집(edit) 전용 모델에 특화된 방식 | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
기본 어휘만 갖춘 초기 GPT-3 토크나이저 | 구버전 davinci, curie, babbage, ada 모델 |
o200k_base |
OpenAI GPT-5, GPT-4.1, GPT-4o, o 시리즈 모델의 현행 토크나이저(OpenAI tiktoken 기준) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
모델별 컨텍스트 윈도우
OpenAI 모델은 각각 한 번의 요청에서 처리할 수 있는 최대 토큰 수(컨텍스트 윈도우)가 정해져 있습니다.
| 모델 | 최대 토큰 수 | 인코딩 방식 |
|---|---|---|
gpt-5 |
272,000 | o200k_base |
gpt-4.1 |
1,047,576 | o200k_base |
gpt-4o |
128,000 | o200k_base |
gpt-4o-mini |
128,000 | o200k_base |
o3 |
200,000 | o200k_base |
o4-mini |
200,000 | o200k_base |
o1 |
200,000 | o200k_base |
gpt-4-turbo |
128,000 | cl100k_base |
gpt-4 |
8,192 | cl100k_base |
gpt-3.5-turbo |
16,385 | cl100k_base |
text-embedding-3-large |
8,191 | cl100k_base |
text-embedding-3-small |
8,191 | cl100k_base |
text-embedding-ada-002 |
8,191 | cl100k_base |
토큰 계산 방식
이 계산기는 두 가지 계산 방식을 제공합니다.
| 메서드 | 표준(Standard) | 일반(Ordinary) |
|---|---|---|
encode() |
HTML을 특별 처리하면서 토큰 ID까지 반환하는 완전한 토큰화 | encodeOrdinary()는 HTML을 일반 텍스트로 취급합니다 |
countTokens() |
HTML을 특별 처리하되 개수만 세도록 최적화된 방식 | countTokensOrdinary()는 HTML을 일반 텍스트로 취급합니다 |
HTML 처리: 텍스트에 HTML이 포함되어 있으면 표준 방식은 태그를 인식해 별도로 처리하고, 일반 방식은 태그를 그냥 문자열로 봅니다. 그래서 같은 텍스트라도 토큰 수가 달라질 수 있습니다. HTML을 작성한 그대로 유지하고 싶다면 일반(Ordinary) 방식을 사용하세요.
토큰 절약 팁
- 반복되는 문장은 같은 길이의 서로 다른 문장보다 토큰을 적게 쓰는 경우가 많습니다
- 공백(스페이스, 탭, 줄바꿈)도 토큰으로 계산됩니다
- 특수문자는 하나씩 따로 토큰화되어 토큰 수를 늘리기 쉽습니다
- 일상적인 단어가 전문 용어나 희귀 단어보다 토큰을 적게 씁니다
- 한국어를 비롯한 비영어권 텍스트는 같은 내용의 영어보다 토큰을 훨씬 많이 소모합니다. 한글은 자모 단위로 쪼개지는 경우가 있어, 상대적으로 한국어 처리가 개선된
o200k_base(GPT-5, GPT-4.1, GPT-4o 등)에서 토큰 수가 눈에 띄게 줄어들기도 합니다 - 코드는 비교적 최신 토크나이저(o200k_base, cl100k_base)에서 효율적으로 토큰화됩니다
토큰 수 예시
| 텍스트 | 토큰 수 | 설명 |
|---|---|---|
| "Hello world" | 2 | 흔한 단어는 대체로 토큰 하나로 처리됩니다 |
| "antidisestablishmentarianism" | 5 | 긴 단어는 여러 토큰으로 쪼개집니다 |
| "こんにちは" | 3 | 한글·일본어 등 비라틴 문자는 토큰이 더 많이 필요합니다 |
| "1234567890" | 3 | 숫자는 몇 자리씩 묶여 여러 토큰이 됩니다 |
| "<div>Hello</div>" | 4~6 | HTML 태그는 표준 방식과 일반 방식에서 결과가 달라질 수 있습니다 |