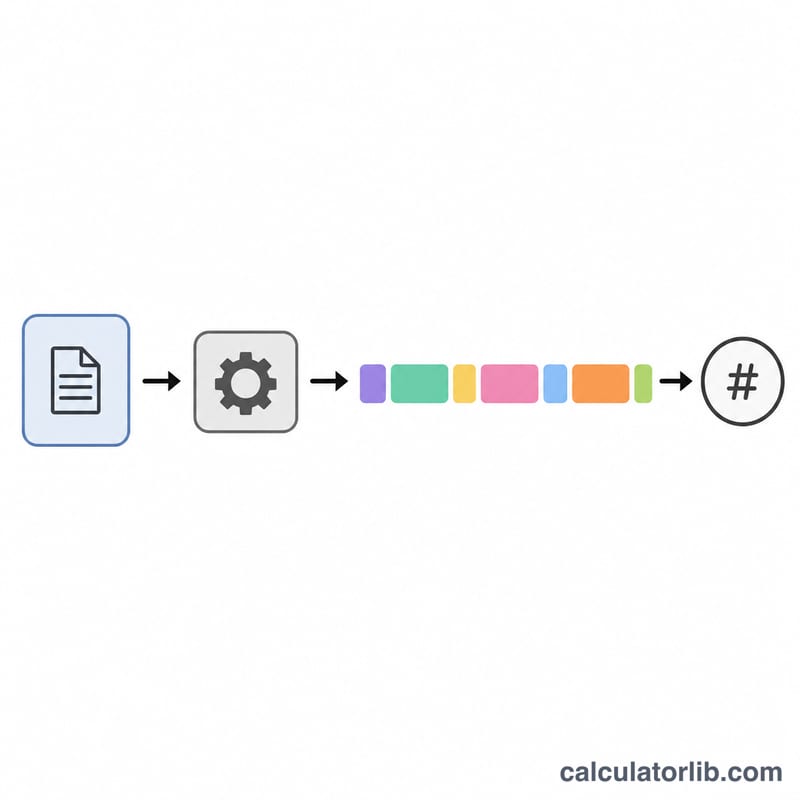
Ce compteur de tokens OpenAI s'appuie sur JTokkit v1.1.0, une implémentation Java open source de tiktoken, le tokeniseur officiel d'OpenAI.
Dépendance Maven : com.knuddels:jtokkit:1.1.0
JTokkit est développé et maintenu par Knuddels GmbH et distribué sous licence MIT.
Détails d'implémentation
Ce compteur de tokens repose sur le code suivant :
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit reproduit exactement la tokenisation de la bibliothèque officielle tiktoken d'OpenAI : les comptages obtenus ici sont donc fidèles à ceux facturés par l'API.
Guide du compteur de tokens OpenAI
Qu'est-ce que la tokenisation ?
La tokenisation consiste à découper un texte en petites unités appelées « tokens » (ou jetons). Les modèles d'OpenAI ne raisonnent ni en caractères ni en mots, mais en tokens. Un token peut se réduire à un seul caractère comme couvrir un mot entier (par exemple « a » ou « pomme »). Les mots courants correspondent souvent à un token unique, tandis que les mots plus rares sont découpés en plusieurs morceaux.
Le nombre de tokens est donné par :
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encodage}}\big(\text{Texte}\big)\Big)$$À retenir : chaque modèle utilise son propre tokeniseur, et le nombre de tokens influe directement sur :
- le coût de l'API (la facturation se fait au token, en entrée comme en sortie) ;
- l'occupation de la fenêtre de contexte (chaque modèle a une limite maximale de tokens) ;
- la vitesse de traitement (plus il y a de tokens, plus la réponse met de temps à arriver).
Types d'encodage
JTokkit propose plusieurs encodages, strictement alignés sur les tokeniseurs d'OpenAI :
| Encodage | Description | Modèles concernés |
|---|---|---|
cl100k_base |
Tokeniseur de GPT-4, GPT-4 Turbo, GPT-3.5 Turbo et des modèles d'embeddings text-embedding-3 / ada-002 | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
Vocabulaire enrichi, meilleure gestion du code | GPT-3 davinci, curie, babbage, ada ; modèles Codex |
p50k_edit |
Spécialisé pour les modèles d'édition de texte | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
Tokeniseur GPT-3 d'origine, vocabulaire de base | Anciens modèles davinci, curie, babbage, ada |
o200k_base |
Tokeniseur actuel des modèles GPT-5, GPT-4.1, GPT-4o et de la série o d'OpenAI (d'après tiktoken d'OpenAI) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
Modèles et fenêtres de contexte
Chaque modèle OpenAI dispose d'une fenêtre de contexte maximale, c'est-à-dire du nombre de tokens qu'il peut traiter en une seule requête :
| Modèle | Tokens max. | Type d'encodage |
|---|---|---|
gpt-5 |
272 000 | o200k_base |
gpt-4.1 |
1 047 576 | o200k_base |
gpt-4o |
128 000 | o200k_base |
gpt-4o-mini |
128 000 | o200k_base |
o3 |
200 000 | o200k_base |
o4-mini |
200 000 | o200k_base |
o1 |
200 000 | o200k_base |
gpt-4-turbo |
128 000 | cl100k_base |
gpt-4 |
8 192 | cl100k_base |
gpt-3.5-turbo |
16 385 | cl100k_base |
text-embedding-3-large |
8 191 | cl100k_base |
text-embedding-3-small |
8 191 | cl100k_base |
text-embedding-ada-002 |
8 191 | cl100k_base |
Méthodes de comptage
Ce calculateur propose deux méthodes de comptage :
| Méthode | Standard | Ordinaire |
|---|---|---|
encode() |
Tokenisation complète : renvoie les identifiants de tokens et applique un traitement particulier au HTML | encodeOrdinary() traite le HTML comme du texte brut |
countTokens() |
Méthode optimisée : compte uniquement les tokens, avec traitement particulier du HTML | countTokensOrdinary() traite le HTML comme du texte brut |
Gestion du HTML : lorsque votre texte contient du HTML, les méthodes standard reconnaissent les balises et leur appliquent un traitement spécifique, alors que les méthodes ordinaires les considèrent comme du texte ordinaire. Les deux approches peuvent donc donner des totaux différents. Privilégiez les méthodes ordinaires si vous souhaitez que votre HTML soit conservé exactement tel qu'il est écrit.
Conseils pour maîtriser vos tokens
- Un texte répétitif consomme souvent moins de tokens qu'un texte varié de même longueur.
- Les espaces (espaces, tabulations, retours à la ligne) comptent comme des tokens.
- Les caractères spéciaux sont parfois tokenisés un par un, ce qui fait grimper le total.
- Les mots courants coûtent généralement moins de tokens que les termes rares ou techniques.
- Un texte en français (ou dans toute autre langue que l'anglais) consomme le plus souvent plus de tokens qu'un texte anglais équivalent : les accents et les mots plus longs y sont pour beaucoup.
- Le code est tokenisé de façon nettement plus économe avec les tokeniseurs récents (o200k_base, cl100k_base).
Exemples courants de comptage
| Texte | Tokens | Remarque |
|---|---|---|
| « Hello world » | 2 | Les mots courants valent souvent un seul token |
| « antidisestablishmentarianism » | 5 | Les mots longs sont découpés en plusieurs tokens |
| « こんにちは » | 3 | Les caractères non latins demandent souvent plus de tokens |
| « 1234567890 » | 3 | Les nombres sont fréquemment découpés en blocs de chiffres |
| « <div>Hello</div> » | 4-6 | Le total varie selon que l'on utilise la méthode standard ou ordinaire |