यह OpenAI टोकन काउंटर JTokkit v1.1.0 पर आधारित है — यह OpenAI की tiktoken लाइब्रेरी का ओपन-सोर्स Java रूपांतरण है।
Maven डिपेंडेंसी: com.knuddels:jtokkit:1.1.0
JTokkit को Knuddels GmbH बनाती और मेंटेन करती है, और यह MIT लाइसेंस के तहत उपलब्ध है।
तकनीकी क्रियान्वयन (Implementation)
यह टोकन काउंटर इस तरह बनाया गया है:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit वही टोकनाइज़ेशन देती है जो OpenAI की आधिकारिक tiktoken लाइब्रेरी देती है, इसलिए यहाँ मिलने वाली टोकन संख्या सटीक रहती है।
OpenAI टोकन काउंटर: पूरी गाइड
टोकनाइज़ेशन क्या है?
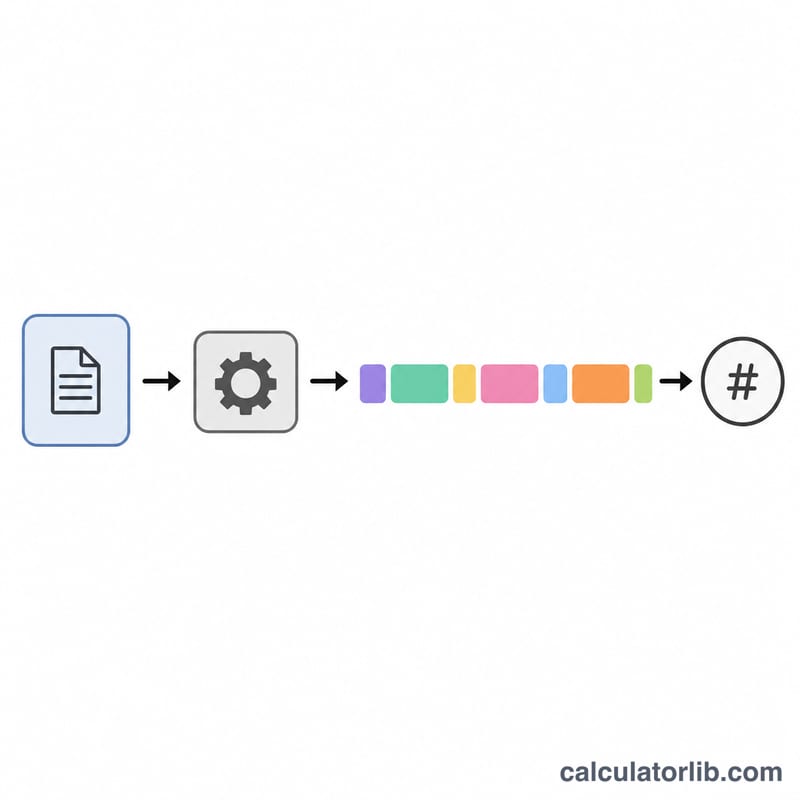
टोकनाइज़ेशन का मतलब है टेक्स्ट को छोटे-छोटे टुकड़ों में बाँटना, जिन्हें टोकन कहते हैं। OpenAI के मॉडल टेक्स्ट को अक्षरों या शब्दों के रूप में नहीं, बल्कि टोकन के रूप में पढ़ते हैं। एक टोकन एक अक्षर जितना छोटा भी हो सकता है और पूरे शब्द जितना बड़ा भी (जैसे "a" या "apple")। आम शब्द अक्सर एक ही टोकन में आ जाते हैं, जबकि कम इस्तेमाल होने वाले शब्द कई टोकन में टूट सकते हैं।
टोकन की संख्या इस तरह निकलती है:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$ध्यान दें: हर मॉडल अलग टोकनाइज़र इस्तेमाल करता है, और आपकी टोकन संख्या सीधे इन बातों को प्रभावित करती है:
- API की लागत (इनपुट और आउटपुट, दोनों का भुगतान प्रति टोकन होता है)
- कॉन्टेक्स्ट विंडो का इस्तेमाल (हर मॉडल की एक अधिकतम टोकन सीमा होती है)
- प्रोसेसिंग स्पीड (जितने ज़्यादा टोकन, उतना ज़्यादा समय)
एन्कोडिंग के प्रकार
JTokkit कई एन्कोडिंग टाइप देती है, जो OpenAI के टोकनाइज़र से पूरी तरह मेल खाते हैं:
| एन्कोडिंग | विवरण | किन मॉडलों में |
|---|---|---|
cl100k_base |
GPT-4, GPT-4 Turbo, GPT-3.5 Turbo और text-embedding-3 / ada-002 एम्बेडिंग मॉडल का टोकनाइज़र | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
बेहतर शब्दावली, कोड के लिए ज़्यादा उपयुक्त | GPT-3 davinci, curie, babbage, ada; Codex मॉडल |
p50k_edit |
ख़ास तौर पर एडिट मॉडलों के लिए | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
मूल GPT-3 टोकनाइज़र, बुनियादी शब्दावली के साथ | पुराने davinci, curie, babbage, ada मॉडल |
o200k_base |
OpenAI के GPT-5, GPT-4.1, GPT-4o और o-सीरीज़ मॉडल का मौजूदा टोकनाइज़र (OpenAI के tiktoken के अनुसार) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
मॉडल और उनकी कॉन्टेक्स्ट विंडो
हर OpenAI मॉडल की एक अधिकतम कॉन्टेक्स्ट विंडो होती है, यानी वह एक ही रिक्वेस्ट में कितने टोकन संभाल सकता है:
| मॉडल | अधिकतम टोकन | एन्कोडिंग टाइप |
|---|---|---|
gpt-5 |
272,000 | o200k_base |
gpt-4.1 |
1,047,576 | o200k_base |
gpt-4o |
128,000 | o200k_base |
gpt-4o-mini |
128,000 | o200k_base |
o3 |
200,000 | o200k_base |
o4-mini |
200,000 | o200k_base |
o1 |
200,000 | o200k_base |
gpt-4-turbo |
128,000 | cl100k_base |
gpt-4 |
8,192 | cl100k_base |
gpt-3.5-turbo |
16,385 | cl100k_base |
text-embedding-3-large |
8,191 | cl100k_base |
text-embedding-3-small |
8,191 | cl100k_base |
text-embedding-ada-002 |
8,191 | cl100k_base |
टोकन गिनने के तरीक़े
यह कैलकुलेटर गिनती के दो तरीक़े देता है:
| मेथड | स्टैंडर्ड | ऑर्डिनरी |
|---|---|---|
encode() |
पूरी टोकनाइज़ेशन, जो टोकन ID लौटाती है और HTML को विशेष तरीक़े से संभालती है | encodeOrdinary() HTML को सादे टेक्स्ट की तरह मानती है |
countTokens() |
ऑप्टिमाइज़्ड मेथड, जो सिर्फ़ टोकन गिनती है और HTML को विशेष तरीक़े से संभालती है | countTokensOrdinary() HTML को सादे टेक्स्ट की तरह मानती है |
HTML का असर: अगर आपके टेक्स्ट में HTML है, तो स्टैंडर्ड मेथड टैग्स को पहचानकर अलग ढंग से प्रोसेस करती हैं, जबकि ऑर्डिनरी मेथड उन्हें साधारण टेक्स्ट मानती हैं। इसी वजह से दोनों की टोकन संख्या अलग-अलग आ सकती है। अगर आप चाहते हैं कि आपका HTML हूबहू वैसा ही रहे जैसा लिखा गया है, तो ऑर्डिनरी मेथड चुनें।
टोकन बचाने के काम के सुझाव
- दोहराव वाला टेक्स्ट उतनी ही लंबाई के अनोखे टेक्स्ट से अक्सर कम टोकन लेता है
- ख़ाली जगह (स्पेस, टैब, नई लाइन) भी टोकन में गिनी जाती है
- विशेष चिह्न अलग-अलग टोकन बन सकते हैं, जिससे कुल संख्या बढ़ जाती है
- आम शब्द दुर्लभ या तकनीकी शब्दों की तुलना में कम टोकन लेते हैं
- ग़ैर-अंग्रेज़ी टेक्स्ट (जैसे हिंदी/देवनागरी) उसी अर्थ के अंग्रेज़ी टेक्स्ट से अक्सर ज़्यादा टोकन लेता है
- कोड नए टोकनाइज़र (o200k_base, cl100k_base) के साथ ज़्यादा किफ़ायती तरीक़े से टोकनाइज़ होता है
कुछ आम उदाहरण
| टेक्स्ट | टोकन | टिप्पणी |
|---|---|---|
| "Hello world" | 2 | आम शब्द अक्सर एक-एक टोकन में आ जाते हैं |
| "antidisestablishmentarianism" | 5 | लंबे शब्द कई टोकन में टूट जाते हैं |
| "こんにちは" | 3 | ग़ैर-लैटिन लिपियों को आमतौर पर ज़्यादा टोकन चाहिए |
| "1234567890" | 3 | अंक अक्सर कई हिस्सों में बँट जाते हैं |
| "<div>Hello</div>" | 4-6 | स्टैंडर्ड और ऑर्डिनरी मेथड में HTML टैग की गिनती अलग हो सकती है |