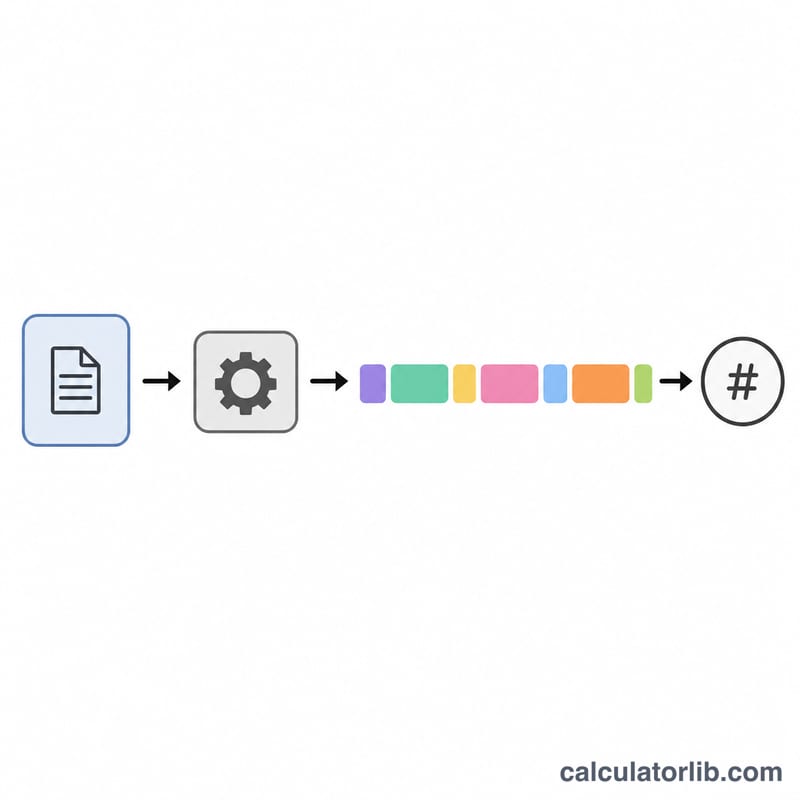
Công cụ đếm token OpenAI này sử dụng JTokkit v1.1.0 – bản cài đặt mã nguồn mở bằng Java của thư viện tiktoken do OpenAI phát triển.
Khai báo Maven: com.knuddels:jtokkit:1.1.0
JTokkit được phát triển và duy trì bởi Knuddels GmbH, phát hành theo giấy phép MIT.
Chi tiết triển khai
Công cụ đếm token này được xây dựng như sau:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit cho ra kết quả tách token giống hệt thư viện tiktoken chính thức của OpenAI, nên số token bạn nhận được là chính xác.
Hướng dẫn dùng công cụ đếm token OpenAI
Tokenization là gì?
Tokenization (tách token) là quá trình chia nhỏ văn bản thành những đơn vị gọi là token. Các model của OpenAI không đọc văn bản theo từng ký tự hay từng từ, mà xử lý theo token. Một token có thể ngắn chỉ một ký tự, cũng có thể dài bằng cả một từ (ví dụ "a" hoặc "apple"). Những từ thông dụng thường chỉ tốn một token, trong khi từ hiếm gặp có thể bị tách thành nhiều token.
Số token được tính bằng:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$Lưu ý quan trọng: Mỗi model dùng một bộ tokenizer khác nhau, và số token ảnh hưởng trực tiếp đến:
- Chi phí API (bạn trả tiền theo token, tính cả đầu vào lẫn đầu ra – thường thanh toán bằng USD)
- Mức sử dụng cửa sổ ngữ cảnh (mọi model đều có giới hạn token tối đa)
- Tốc độ xử lý (càng nhiều token thì càng lâu)
Đây là công cụ dành riêng cho hệ sinh thái model của OpenAI (GPT-4, GPT-4o, GPT-3.5…). Nếu bạn dùng model của nhà cung cấp khác (Claude, Gemini, hay các model tiếng Việt như PhoGPT, Vistral), cách tách token sẽ khác, nên con số ở đây chỉ mang tính tham khảo.
Các kiểu encoding
JTokkit hỗ trợ nhiều kiểu encoding tương ứng với các tokenizer của OpenAI:
| Mã hóa | Mô tả | Dùng cho |
|---|---|---|
cl100k_base |
Tokenizer của GPT-4, GPT-4 Turbo, GPT-3.5 Turbo và các mô hình embedding text-embedding-3 / ada-002 | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
Từ vựng được cải tiến, xử lý mã nguồn tốt hơn | GPT-3 davinci, curie, babbage, ada; các model Codex |
p50k_edit |
Dành riêng cho các model chỉnh sửa (edit) | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
Tokenizer GPT-3 nguyên bản với bộ từ vựng cơ bản | Các model davinci, curie, babbage, ada đời cũ |
o200k_base |
Tokenizer hiện hành của GPT-5, GPT-4.1, GPT-4o và dòng o-series của OpenAI (theo tiktoken của OpenAI) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
Model và cửa sổ ngữ cảnh
Mỗi model của OpenAI có một cửa sổ ngữ cảnh tối đa (số token xử lý được trong một lần gọi):
| Model | Token tối đa | Kiểu encoding |
|---|---|---|
gpt-5 |
272.000 | o200k_base |
gpt-4.1 |
1.047.576 | o200k_base |
gpt-4o |
128.000 | o200k_base |
gpt-4o-mini |
128.000 | o200k_base |
o3 |
200.000 | o200k_base |
o4-mini |
200.000 | o200k_base |
o1 |
200.000 | o200k_base |
gpt-4-turbo |
128.000 | cl100k_base |
gpt-4 |
8.192 | cl100k_base |
gpt-3.5-turbo |
16.385 | cl100k_base |
text-embedding-3-large |
8.191 | cl100k_base |
text-embedding-3-small |
8.191 | cl100k_base |
text-embedding-ada-002 |
8.191 | cl100k_base |
Các phương thức đếm token
Công cụ này cung cấp hai cách đếm:
| Phương thức | Tiêu chuẩn | Thông thường |
|---|---|---|
encode() |
Tách token đầy đủ, trả về danh sách ID token và xử lý riêng cho HTML | encodeOrdinary() coi HTML như văn bản thuần |
countTokens() |
Phương thức tối ưu, chỉ đếm số token và có xử lý riêng cho HTML | countTokensOrdinary() coi HTML như văn bản thuần |
Về cách xử lý HTML: Khi văn bản của bạn có chứa HTML, các phương thức tiêu chuẩn sẽ nhận diện và xử lý thẻ HTML theo cách riêng, còn các phương thức thông thường coi thẻ HTML như văn bản bình thường. Vì vậy hai cách có thể cho ra số token khác nhau. Hãy chọn phương thức thông thường nếu bạn muốn giữ nguyên HTML đúng như đã viết.
Mẹo tiết kiệm token
- Văn bản lặp lại thường tốn ít token hơn văn bản cùng độ dài nhưng không trùng lặp
- Khoảng trắng (dấu cách, tab, xuống dòng) cũng được tính là token
- Ký tự đặc biệt có thể bị tách riêng từng ký tự, làm số token tăng lên
- Từ thông dụng thường tốn ít token hơn từ hiếm hoặc thuật ngữ chuyên ngành
- Văn bản không phải tiếng Anh thường tốn nhiều token hơn nội dung tiếng Anh tương đương – tiếng Việt có dấu là một ví dụ điển hình, cùng một ý nhưng số token có thể cao hơn đáng kể, kéo theo chi phí API tăng
- Mã nguồn được tách token khá hiệu quả với các tokenizer mới (o200k_base, cl100k_base)
Vài ví dụ về số token
| Văn bản | Số token | Ghi chú |
|---|---|---|
| "Hello world" | 2 | Từ thông dụng thường chỉ tốn một token |
| "antidisestablishmentarianism" | 5 | Từ dài bị tách thành nhiều token |
| "こんにちは" | 3 | Ký tự ngoài bảng chữ Latinh thường tốn nhiều token hơn |
| "1234567890" | 3 | Chuỗi số thường được chia thành nhiều token |
| "<div>Hello</div>" | 4-6 | Thẻ HTML cho kết quả khác nhau giữa phương thức tiêu chuẩn và thông thường |