この OpenAI トークンカウンターは、OpenAI の tiktoken を Java で実装したオープンソースライブラリ JTokkit v1.1.0 を利用しています。
Maven の依存関係: com.knuddels:jtokkit:1.1.0
JTokkit は Knuddels GmbH が開発・保守しており、MIT ライセンスで公開されています。
実装の詳細
本ツールは次のコードで構成されています。
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit は OpenAI 公式の tiktoken と同一のトークン化処理を行うため、実際の API 課金と同じ基準で正確なトークン数を確認できます。
OpenAI トークンカウンター 活用ガイド
トークン化(トークナイズ)とは?
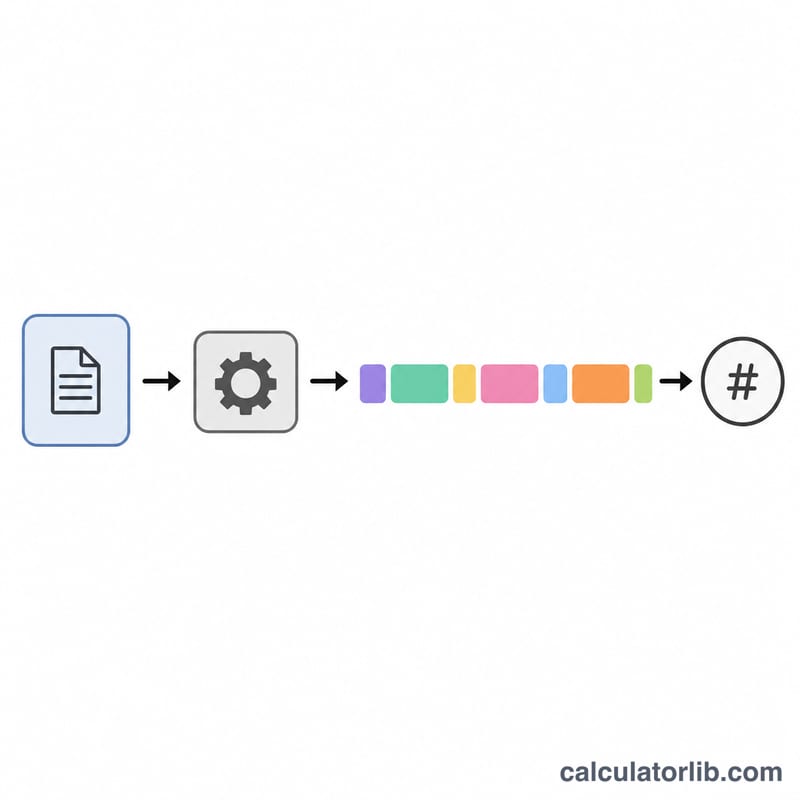
トークン化とは、テキストを「トークン」と呼ばれる小さな単位に分割する処理のことです。OpenAI のモデルは、文字や単語そのものではなくトークンの列としてテキストを処理します。トークンの長さは 1 文字のこともあれば、1 単語まるごと(例:「a」「apple」)のこともあります。頻出する語は 1 トークンで表されることが多く、珍しい語は複数のトークンに分割されます。
トークン数は次の式で表せます。
$$\text{トークン数} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{エンコーディング}}\big(\text{テキスト}\big)\Big)$$重要: モデルごとに使われるトークナイザーが異なります。そしてトークン数は、次の 3 点に直接影響します。
- API の利用料金(入力・出力ともにトークン単位で課金されます)
- コンテキストウィンドウの消費量(どのモデルにもトークン数の上限があります)
- 処理速度(トークンが多いほど応答に時間がかかります)
なお、本ツールが対象とするのは米国 OpenAI 社のモデル群です。Anthropic の Claude や Google の Gemini、国内 LLM などは、それぞれ独自のトークナイザーを採用しているため、ここで得られるトークン数はそのまま当てはまりません。他社モデルのコスト試算には各社の公式カウンターをご利用ください。
エンコーディングの種類
JTokkit は、OpenAI のトークナイザーに対応した以下のエンコーディングを提供しています。
| エンコーディング | 特徴 | 主な対象モデル |
|---|---|---|
cl100k_base |
GPT-4、GPT-4 Turbo、GPT-3.5 Turbo、および埋め込みモデル text-embedding-3 / ada-002 のトークナイザー | GPT-4、GPT-4 Turbo、GPT-3.5 Turbo、text-embedding-3-small/large、text-embedding-ada-002 |
p50k_base |
語彙が拡張され、コードの扱いが向上したトークナイザー | GPT-3 の davinci/curie/babbage/ada、Codex 系モデル |
p50k_edit |
編集(edit)系モデル専用 | text-davinci-edit-001、code-davinci-edit-001 |
r50k_base |
初代 GPT-3 用。基本的な語彙のみのトークナイザー | 旧世代の davinci/curie/babbage/ada |
o200k_base |
OpenAIのGPT-5、GPT-4.1、GPT-4o、oシリーズで使われている現行のトークナイザー(OpenAIのtiktokenによる)。日本語の効率が大きく向上 | GPT-5、GPT-4.1、GPT-4o、GPT-4o-mini、o1、o3、o4-mini |
モデルとコンテキストウィンドウ
OpenAI の各モデルには、1 回のリクエストで扱えるトークン数の上限(コンテキストウィンドウ)が定められています。代表的なモデルは次のとおりです。
| モデル | 最大トークン数 | エンコーディング |
|---|---|---|
gpt-4o |
128,000 | o200k_base |
gpt-4o-mini |
128,000 | o200k_base |
gpt-4-turbo |
128,000 | cl100k_base |
gpt-4-32k |
32,768 | cl100k_base |
gpt-4 |
8,192 | cl100k_base |
gpt-3.5-turbo-16k |
16,384 | cl100k_base |
gpt-3.5-turbo |
4,096 | cl100k_base |
text-embedding-ada-002 |
8,191 | cl100k_base |
text-davinci-003 |
4,097 | p50k_base |
davinci |
2,049 | r50k_base |
上表は代表例です。計算機のプルダウンでモデルを選ぶと、そのモデルの上限値と現在の使用率が自動で表示されます。
2 つのカウント方式
本ツールでは、次の 2 通りの数え方を選べます。
| メソッド | 標準(Standard) | 通常(Ordinary) |
|---|---|---|
encode() |
トークン ID まで返す完全なトークン化。HTML を特別扱いします | encodeOrdinary() は HTML をただのテキストとして扱います |
countTokens() |
個数のみを数える高速版。HTML を特別扱いします | countTokensOrdinary() は HTML をただのテキストとして扱います |
HTML の扱いについて: テキストに HTML が含まれる場合、標準メソッドはタグを認識して特別に処理しますが、通常メソッドはタグを普通の文字列として扱います。そのため同じ文章でもトークン数が変わることがあります。HTML を書いたそのままの形で送りたい場合は、通常メソッドの結果を目安にしてください。
トークン数を抑えるコツ
- 繰り返しの多い文章は、同じ長さでも表現がバラバラな文章よりトークン数が少なくなりがちです
- 空白(半角スペース、タブ、改行)もトークンとして数えられます
- 記号・特殊文字は 1 文字ずつ分割されることがあり、トークン数が増える原因になります
- 日常的な語は、専門用語や珍しい語よりトークン数が少なく済みます
- 日本語をはじめとする非英語のテキストは、同じ内容の英語より多くのトークンを消費しがちです(cl100k_base では顕著。o200k_base ではかなり改善されています)
- ソースコードは新しめのトークナイザー(o200k_base、cl100k_base)で効率よくトークン化されます
トークン数の具体例
| テキスト | トークン数 | ポイント |
|---|---|---|
| 「Hello world」 | 2 | よく使われる単語は 1 語=1 トークンになりやすい |
| 「antidisestablishmentarianism」 | 5 | 長い単語は複数トークンに分割される |
| 「こんにちは」 | 3 | 非ラテン文字はトークンを多く消費しやすい |
| 「1234567890」 | 3 | 数字は数桁ずつのかたまりに分割されることが多い |
| 「<div>Hello</div>」 | 4〜6 | HTML タグは標準/通常のどちらで数えるかで結果が変わる |