本 OpenAI Token 計算器採用 JTokkit v1.1.0,這是 OpenAI tiktoken 的開源 Java 實作版本。
Maven 相依套件:com.knuddels:jtokkit:1.1.0
JTokkit 由 Knuddels GmbH 開發與維護,並以 MIT 授權條款釋出。
實作細節
本計算器的核心程式如下:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit 的斷詞結果與 OpenAI 官方的 tiktoken 函式庫完全一致,因此算出來的 Token 數量可直接用於估算 API 用量與費用。
OpenAI Token 計算器使用指南
什麼是 Token 與斷詞(Tokenization)?
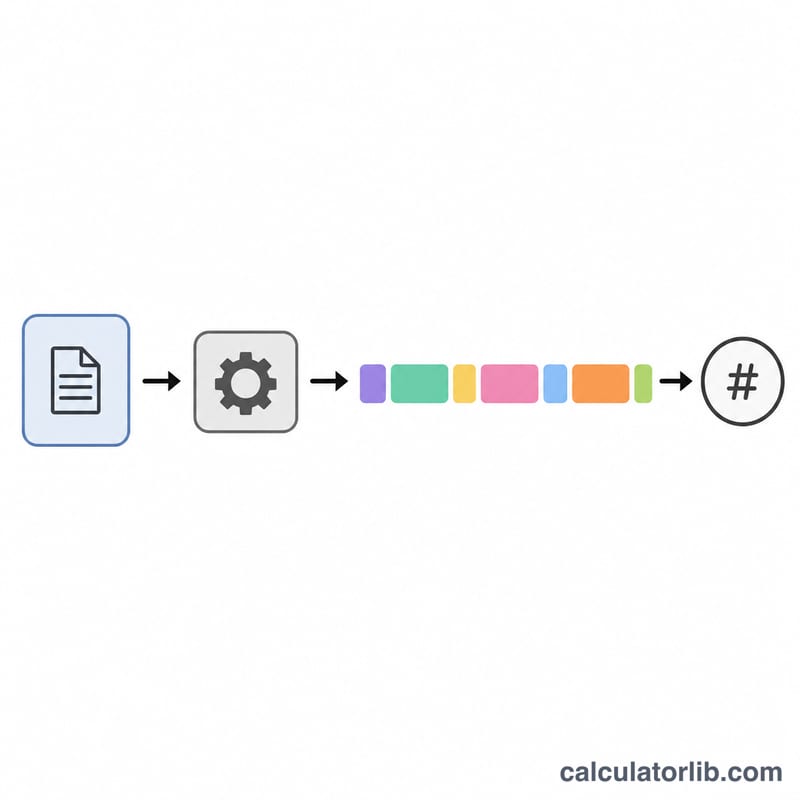
斷詞是把文字切成一小段一小段「Token」的過程。OpenAI 的模型並不是逐字或逐詞閱讀文章,而是以 Token 為單位處理文字。 一個 Token 可能短到只有一個字元,也可能剛好是一個完整單字(例如「a」或「apple」)。常見字詞通常只佔一個 Token, 而較冷僻的字詞則可能被拆成好幾個 Token。
Token 數量的計算方式為:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$重點提醒:不同模型使用不同的斷詞器,而 Token 數量會直接影響三件事:
- API 費用(輸入與輸出都是按 Token 計價,並以美元結算)
- 上下文視窗(Context Window)用量,每個模型都有 Token 上限
- 回應速度(Token 越多,處理時間越長)
本工具是針對「OpenAI 模型」設計的 Token 計算器。Anthropic Claude、Google Gemini 等其他業者採用各自的斷詞器, 同一段文字算出來的 Token 數量並不相同,計費方式也不一樣,請勿直接互相套用。
編碼類型(Encoding Types)
JTokkit 提供多種編碼類型,完整對應 OpenAI 各世代的斷詞器:
| 編碼 | 說明 | 適用模型 |
|---|---|---|
cl100k_base |
GPT-4、GPT-4 Turbo、GPT-3.5 Turbo 及 text-embedding-3 / ada-002 嵌入模型使用的斷詞器 | GPT-4、GPT-4 Turbo、GPT-3.5 Turbo、text-embedding-3-small/large、text-embedding-ada-002 |
p50k_base |
詞彙表經過改良,程式碼處理效果較佳 | GPT-3 davinci、curie、babbage、ada;Codex 系列 |
p50k_edit |
專為編輯(edit)類模型設計 | text-davinci-edit-001、code-davinci-edit-001 |
r50k_base |
最早期的 GPT-3 斷詞器,詞彙表較為基本 | 舊版 davinci、curie、babbage、ada 模型 |
o200k_base |
OpenAI GPT-5、GPT-4.1、GPT-4o 與 o 系列模型目前使用的斷詞器(依據 OpenAI 的 tiktoken) | GPT-5、GPT-4.1、GPT-4o、GPT-4o-mini、o1、o3、o4-mini |
模型與上下文視窗
每個 OpenAI 模型都有上下文視窗上限,也就是單次請求所能處理的最大 Token 數:
| 模型 | Token 上限 | 編碼類型 |
|---|---|---|
gpt-5 |
272,000 | o200k_base |
gpt-4.1 |
1,047,576 | o200k_base |
gpt-4o |
128,000 | o200k_base |
gpt-4o-mini |
128,000 | o200k_base |
o3 |
200,000 | o200k_base |
o4-mini |
200,000 | o200k_base |
o1 |
200,000 | o200k_base |
gpt-4-turbo |
128,000 | cl100k_base |
gpt-4 |
8,192 | cl100k_base |
gpt-3.5-turbo |
16,385 | cl100k_base |
text-embedding-3-large |
8,191 | cl100k_base |
text-embedding-3-small |
8,191 | cl100k_base |
text-embedding-ada-002 |
8,191 | cl100k_base |
兩種 Token 計算方法
本計算器提供兩種計算模式:
| 方法 | 標準模式 | 一般模式 |
|---|---|---|
encode() |
完整斷詞並回傳 Token ID,對 HTML 會做特殊處理 | encodeOrdinary() 會把 HTML 當成純文字看待 |
countTokens() |
最佳化過的計數方法,只回傳數量,對 HTML 會做特殊處理 | countTokensOrdinary() 會把 HTML 當成純文字看待 |
關於 HTML:當文字中含有 HTML 時,標準模式會辨識標籤並以特殊方式處理,一般模式則把標籤當成普通文字, 兩者算出的 Token 數量因此可能不同。若你希望 HTML 原封不動地送進模型,請選擇一般模式來估算。
節省 Token 的實用心法
- 重複性高的文字通常比同樣長度的不重複文字更省 Token
- 空白字元(空格、Tab、換行)同樣會計入 Token
- 特殊符號常被單獨切成一個 Token,容易讓總數暴增
- 常用字詞耗用的 Token 通常比冷僻字或專業術語少
- 非英語文字(含中文)多半比意思相同的英文耗用更多 Token,撰寫長提示詞時要特別留意
- 程式碼在較新的斷詞器(o200k_base、cl100k_base)中切得更有效率
以 o200k_base 為例,中文的斷詞效率已比舊版編碼改善不少,但整體而言,同一段內容用中文書寫仍比英文佔用更多 Token, 估算 API 預算時建議直接以實測數字為準。
常見的 Token 數量範例
| 文字 | Token 數 | 說明 |
|---|---|---|
| 「Hello world」 | 2 | 常用字詞多半各佔一個 Token |
| 「antidisestablishmentarianism」 | 5 | 長單字會被拆成多個 Token |
| 「こんにちは」 | 3 | 非拉丁文字通常需要更多 Token |
| 「1234567890」 | 3 | 數字常被切成好幾段 |
| 「<div>Hello</div>」 | 4-6 | HTML 標籤在標準模式與一般模式下的計算結果可能不同 |