Bu OpenAI Token Sayacı, OpenAI'nin tiktoken kütüphanesinin açık kaynaklı Java uygulaması olan JTokkit v1.1.0 sürümünü kullanır.
Maven bağımlılığı: com.knuddels:jtokkit:1.1.0
JTokkit, Knuddels GmbH tarafından geliştirilip sürdürülmektedir ve MIT lisansı ile sunulmaktadır.
Teknik Ayrıntılar
Bu token sayacı şu şekilde hayata geçirildi:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit, OpenAI'nin resmi tiktoken kütüphanesiyle birebir aynı tokenizasyonu uygular; dolayısıyla buradaki token sayıları gerçek kullanımla örtüşür.
OpenAI Token Sayacı Rehberi
Tokenizasyon nedir?
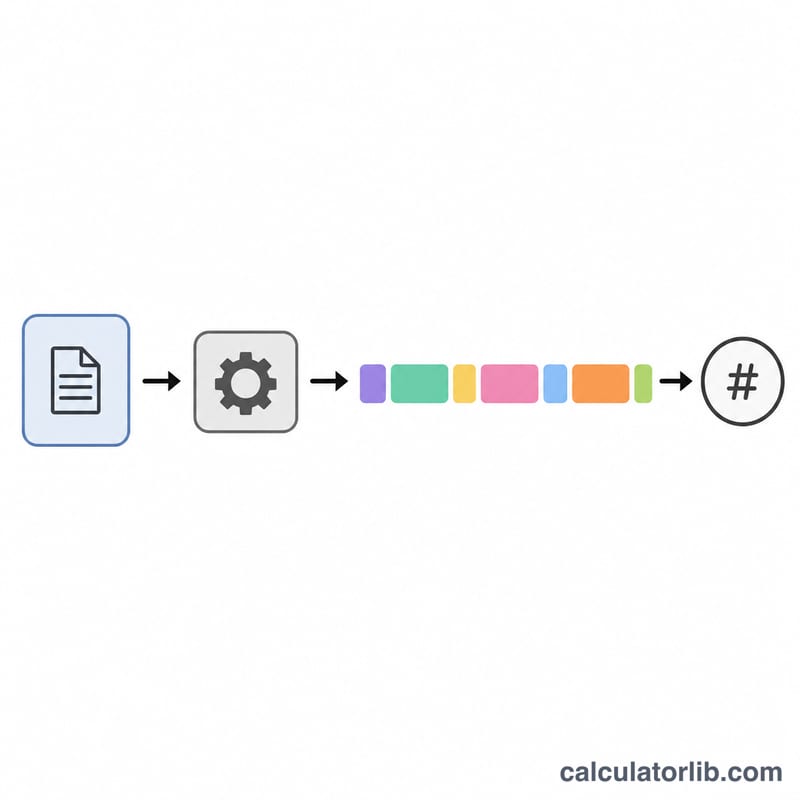
Tokenizasyon, metnin "token" adı verilen daha küçük parçalara bölünmesi işlemidir. OpenAI modelleri metni harf harf ya da kelime kelime değil, token'lar hâlinde işler. Bir token tek bir karakter kadar kısa olabileceği gibi bütün bir kelimeye de karşılık gelebilir (örneğin "a" ya da "apple"). Sık kullanılan kelimeler çoğunlukla tek token'dır; daha az rastlanan kelimeler ise birden fazla parçaya ayrılır.
Token sayısı şu şekilde ifade edilir:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$Önemli: Her model farklı bir tokenizer kullanır ve token sayısı doğrudan şunları etkiler:
- API maliyeti (hem girdi hem çıktı için token başına ödeme yaparsınız)
- Bağlam penceresi kullanımı (her modelin bir üst token sınırı vardır)
- İşlem hızı (token sayısı arttıkça yanıt süresi uzar)
Encoding Türleri
JTokkit, OpenAI'nin tokenizer'larıyla eşleşen birkaç encoding türü sunar:
| Kodlama | Açıklama | Kullanan modeller |
|---|---|---|
cl100k_base |
GPT-4, GPT-4 Turbo, GPT-3.5 Turbo ile text-embedding-3 / ada-002 embedding modellerinin tokenizer'ı | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
Kod işleme becerisi geliştirilmiş, sözlüğü genişletilmiş sürüm | GPT-3 davinci, curie, babbage, ada; Codex modelleri |
p50k_edit |
Düzenleme (edit) modelleri için özelleştirilmiş sürüm | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
Temel sözlüğe sahip ilk GPT-3 tokenizer'ı | Eski davinci, curie, babbage, ada modelleri |
o200k_base |
OpenAI'ın GPT-5, GPT-4.1, GPT-4o ve o serisi modellerinin güncel tokenizer'ı (OpenAI'ın tiktoken kütüphanesine göre) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
Modeller ve Bağlam Pencereleri
Her OpenAI modelinin tek bir istekte işleyebileceği azami token sayısı, yani bir bağlam penceresi vardır:
| Model | Azami Token | Encoding Türü |
|---|---|---|
gpt-5 |
272.000 | o200k_base |
gpt-4.1 |
1.047.576 | o200k_base |
gpt-4o |
128.000 | o200k_base |
gpt-4o-mini |
128.000 | o200k_base |
o3 |
200.000 | o200k_base |
o4-mini |
200.000 | o200k_base |
o1 |
200.000 | o200k_base |
gpt-4-turbo |
128.000 | cl100k_base |
gpt-4 |
8.192 | cl100k_base |
gpt-3.5-turbo |
16.385 | cl100k_base |
text-embedding-3-large |
8.191 | cl100k_base |
text-embedding-3-small |
8.191 | cl100k_base |
text-embedding-ada-002 |
8.191 | cl100k_base |
Token Sayma Yöntemleri
Bu hesaplayıcı iki farklı sayma yöntemi sunar:
| Yöntem | Standart | Sıradan (Ordinary) |
|---|---|---|
encode() |
HTML'i özel olarak ele alan, token ID'lerini de döndüren tam tokenizasyon | encodeOrdinary() HTML'i düz metin gibi işler |
countTokens() |
HTML'i özel olarak ele alan, yalnızca sayım yapan optimize edilmiş yöntem | countTokensOrdinary() HTML'i düz metin gibi işler |
HTML'in ele alınışı: Metniniz HTML içeriyorsa standart yöntemler etiketleri tanıyıp özel biçimde işler; "ordinary" yöntemler ise etiketleri sıradan metin olarak sayar. Bu fark, aynı metin için farklı token sonuçları doğurabilir. HTML'inizin yazdığınız hâliyle birebir korunmasını istiyorsanız "ordinary" yöntemleri tercih edin.
Token Sayımında Pratik İpuçları
- Tekrar eden metinler, aynı uzunluktaki özgün metinlere göre genellikle daha az token harcar
- Boşluklar (boşluk, sekme, satır sonu) da token olarak sayılır
- Özel karakterler tek tek token'lanabilir ve toplam sayıyı yükseltir
- Yaygın kelimeler, nadir ya da teknik terimlere kıyasla daha az token tüketir
- İngilizce dışındaki metinler — Türkçe dâhil — aynı içeriğin İngilizcesine göre çoğu zaman daha fazla token harcar; Türkçedeki ekler ayrı parçalara bölündüğü için maliyet farkı ciddi olabilir
- Kod, yeni tokenizer'larla (o200k_base, cl100k_base) çok daha verimli token'lanır
Sık Karşılaşılan Token Sayısı Örnekleri
| Metin | Token | Not |
|---|---|---|
| "Hello world" | 2 | Yaygın kelimeler çoğunlukla tek token sayılır |
| "antidisestablishmentarianism" | 5 | Uzun kelimeler birden fazla parçaya bölünür |
| "こんにちは" | 3 | Latin alfabesi dışındaki karakterler daha fazla token gerektirir |
| "1234567890" | 3 | Sayılar genellikle birkaç parçaya bölünerek işlenir |
| "<div>Hello</div>" | 4-6 | HTML etiketleri standart ve ordinary yöntemlerde farklı sayılabilir |