تعتمد حاسبة توكنات OpenAI هذه على مكتبة JTokkit الإصدار 1.1.0، وهي تنفيذ مفتوح المصدر بلغة Java لمكتبة tiktoken الرسمية من OpenAI.
اعتمادية Maven: com.knuddels:jtokkit:1.1.0
تطوّر شركة Knuddels GmbH هذه المكتبة وتتولى صيانتها، وهي متاحة بموجب رخصة MIT.
تفاصيل التنفيذ البرمجي
بُنيت هذه الأداة على النحو التالي:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
تُنتج JTokkit نفس نتائج التقطيع التي تنتجها مكتبة tiktoken الرسمية من OpenAI، ما يضمن دقة عدد التوكنات الظاهر أمامك.
دليل استخدام حاسبة توكنات OpenAI
ما المقصود بالتقطيع إلى توكنات؟
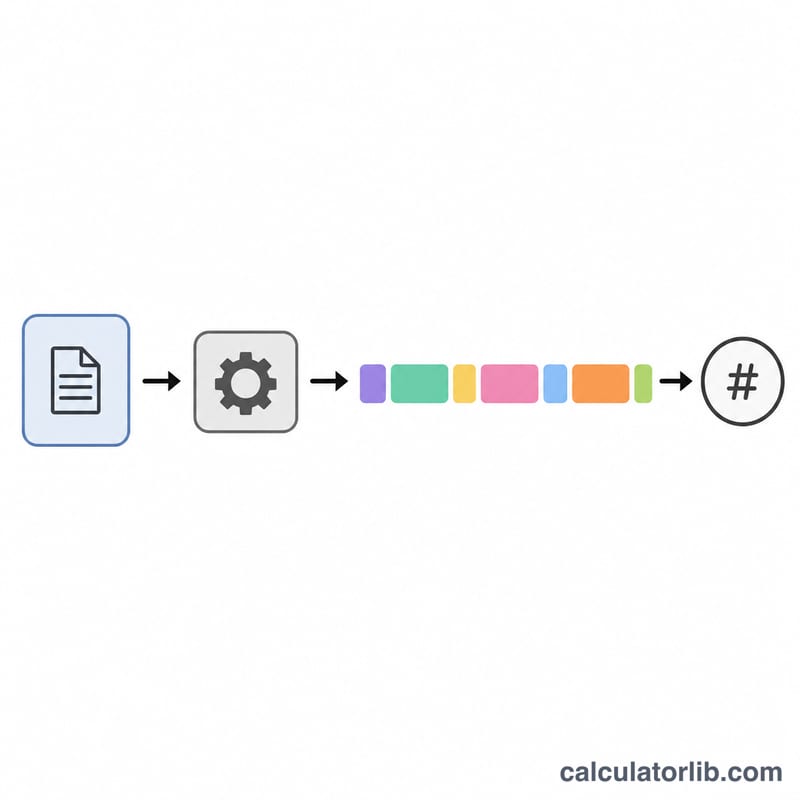
التقطيع (Tokenization) هو تقسيم النص إلى وحدات صغيرة تُسمى «توكنات». نماذج OpenAI لا تقرأ الحروف أو الكلمات كما نقرأها نحن، بل تتعامل مع هذه التوكنات فقط. وقد يكون التوكن حرفًا واحدًا أو كلمة كاملة (مثل «a» أو «apple»). الكلمات الشائعة تُمثَّل غالبًا بتوكن واحد، بينما تُقسَّم الكلمات النادرة إلى عدة توكنات.
ويُحسب عدد التوكنات بالعلاقة التالية:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Text}\big)\Big)$$مهم: لكل عائلة من النماذج مُقطِّع مختلف، وعدد التوكنات يؤثر مباشرةً في:
- تكلفة الاستخدام عبر الـ API (الفوترة بالتوكن على المدخلات والمخرجات معًا)
- استهلاك نافذة السياق (لكل نموذج حد أقصى لا يمكن تجاوزه)
- سرعة الاستجابة (كلما زادت التوكنات طال زمن المعالجة)
أنواع الترميز (Encodings)
توفّر JTokkit عدة أنواع ترميز مطابقة لمُقطِّعات OpenAI:
| الترميز | الوصف | النماذج التي تستخدمه |
|---|---|---|
cl100k_base |
مُقطِّع نماذج GPT-4 وGPT-4 Turbo وGPT-3.5 Turbo ونماذج التضمين text-embedding-3 / ada-002 | GPT-4، GPT-4 Turbo، GPT-3.5 Turbo، text-embedding-3-small/large، text-embedding-ada-002 |
p50k_base |
مفردات محسّنة مع معالجة أفضل للشيفرة البرمجية | نماذج GPT-3: davinci وcurie وbabbage وada، ونماذج Codex |
p50k_edit |
مخصص لنماذج التحرير (Edit) | text-davinci-edit-001، code-davinci-edit-001 |
r50k_base |
المُقطِّع الأصلي لنماذج GPT-3 بمفردات أساسية | الإصدارات الأقدم من davinci وcurie وbabbage وada |
o200k_base |
المُقطِّع الحالي لنماذج GPT-5 وGPT-4.1 وGPT-4o وسلسلة o من OpenAI (وفق مكتبة tiktoken من OpenAI) | GPT-5، GPT-4.1، GPT-4o، GPT-4o-mini، o1، o3، o4-mini |
النماذج ونوافذ السياق
لكل نموذج من نماذج OpenAI نافذة سياق قصوى، أي أقصى عدد توكنات يستطيع معالجته في الطلب الواحد:
| النموذج | الحد الأقصى للتوكنات | نوع الترميز |
|---|---|---|
GPT-4o |
128,000 | o200k_base |
GPT-4o-mini |
128,000 | o200k_base |
GPT-4-turbo |
128,000 | cl100k_base |
GPT-4-32k |
32,768 | cl100k_base |
GPT-4 |
8,192 | cl100k_base |
GPT-3.5-Turbo |
16,385 | cl100k_base |
text-embedding-ada-002 |
8,191 | cl100k_base |
code-davinci-002 |
8,001 | p50k_base |
text-davinci-003 |
4,097 | p50k_base |
davinci |
2,049 | r50k_base |
تعرض القائمة المنسدلة في الحاسبة أعلاه جميع النماذج المدعومة مع حدودها الفعلية، وتختار الترميز المناسب تلقائيًا بمجرد اختيارك للنموذج.
طرق عدّ التوكنات
تتيح لك هذه الحاسبة طريقتين للعدّ:
| الدالة | الوضع القياسي | الوضع العادي |
|---|---|---|
encode() |
تقطيع كامل يُعيد معرفات التوكنات مع معالجة خاصة لوسوم HTML | encodeOrdinary() تتعامل مع HTML كنص عادي |
countTokens() |
طريقة مُحسَّنة تكتفي بعدّ التوكنات مع معالجة خاصة لوسوم HTML | countTokensOrdinary() تتعامل مع HTML كنص عادي |
التعامل مع HTML: إذا احتوى نصك على وسوم HTML، فإن الطرق القياسية تتعرّف عليها وتعالجها بشكل خاص، بينما تعدّها الطرق العادية نصًا اعتياديًا، وهو ما قد يعطي أعدادًا مختلفة من التوكنات. استخدم الطرق العادية إذا أردت الحفاظ على شيفرة HTML كما كتبتها تمامًا.
نصائح عملية لتقليل التوكنات
- النصوص المتكررة تستهلك عادةً توكنات أقل من نصوص فريدة بالطول نفسه
- المسافات وعلامات الجدولة والأسطر الجديدة تُحتسب هي أيضًا ضمن التوكنات
- الرموز والمحارف الخاصة قد تُقطَّع كل واحد منها على حدة فيرتفع العدد
- الكلمات الشائعة أوفر في التوكنات من المصطلحات النادرة أو التقنية
- النصوص غير الإنجليزية — ومنها العربية — تستهلك غالبًا توكنات أكثر من نص إنجليزي بالمعنى نفسه، لذا ضع ذلك في حسبان تكلفتك
- الشيفرة البرمجية تُقطَّع بكفاءة أعلى مع المُقطِّعات الأحدث (o200k_base وcl100k_base)
أمثلة شائعة على عدد التوكنات
| النص | التوكنات | ملاحظة |
|---|---|---|
| "Hello world" | 2 | الكلمات الشائعة تُحتسب غالبًا كتوكن واحد لكل كلمة |
| "antidisestablishmentarianism" | 5 | الكلمات الطويلة تُقسَّم إلى عدة توكنات |
| "こんにちは" | 3 | الحروف غير اللاتينية تحتاج عادةً إلى توكنات أكثر |
| "1234567890" | 3 | الأرقام تُقسَّم عادةً إلى مجموعات من عدة توكنات |
| "<div>Hello</div>" | 4-6 | قد يختلف عدد وسوم HTML بين الطريقة القياسية والطريقة العادية |