Este contador de tokens de OpenAI funciona con JTokkit v1.1.0, una implementación en Java de código abierto del tiktoken de OpenAI.
Dependencia de Maven: com.knuddels:jtokkit:1.1.0
JTokkit está desarrollado y mantenido por Knuddels GmbH y se distribuye bajo licencia MIT.
Detalles de la implementación
Así está construido este contador de tokens:
// Maven dependency
implementation 'com.knuddels:jtokkit:1.1.0'

// Token counting implementation
import com.knuddels.jtokkit.Encodings;
import com.knuddels.jtokkit.api.Encoding;
import com.knuddels.jtokkit.api.EncodingRegistry;
import com.knuddels.jtokkit.api.EncodingType;
import com.knuddels.jtokkit.api.ModelType;

// Usage example
EncodingRegistry registry = Encodings.newDefaultEncodingRegistry();
Encoding encoding = registry.getEncoding(EncodingType.CL100K_BASE);
int tokenCount = encoding.countTokens(text);
JTokkit aplica exactamente la misma tokenización que la biblioteca oficial tiktoken de OpenAI, de modo que el recuento de tokens es fiable.
Guía del contador de tokens de OpenAI
¿Qué es la tokenización?
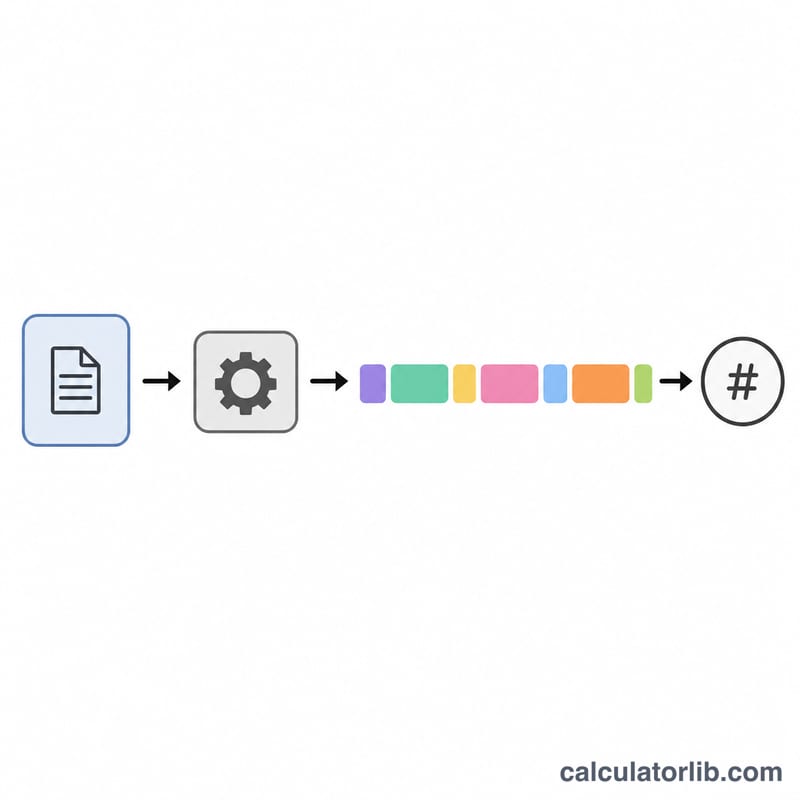
Tokenizar consiste en dividir un texto en unidades más pequeñas llamadas tokens. Los modelos de OpenAI no procesan letras ni palabras sueltas, sino tokens. Un token puede ser tan corto como un solo carácter o tan largo como una palabra completa (por ejemplo, «a» o «casa»). Las palabras frecuentes suelen ocupar un único token, mientras que las poco habituales se parten en varios.
El número de tokens se obtiene así:
$$\text{Tokens} = \operatorname{len}\Big(\operatorname{encode}_{\,\text{Encoding}}\big(\text{Texto}\big)\Big)$$Importante: cada modelo usa un tokenizador distinto, y el recuento de tokens repercute directamente en:
- El coste de la API (se paga por token, tanto de entrada como de salida)
- El uso de la ventana de contexto (todos los modelos tienen un límite máximo de tokens)
- La velocidad de respuesta (cuantos más tokens, más tarda el procesamiento)
Tipos de codificación
JTokkit incluye varias codificaciones que se corresponden con los tokenizadores de OpenAI:
| Codificación | Descripción | Modelos que la usan |
|---|---|---|
cl100k_base |
Tokenizador de GPT-4, GPT-4 Turbo, GPT-3.5 Turbo y de los modelos de embeddings text-embedding-3 / ada-002 | GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, text-embedding-3-small/large, text-embedding-ada-002 |
p50k_base |
Vocabulario ampliado que gestiona mejor el código fuente | GPT-3 davinci, curie, babbage, ada; modelos Codex |
p50k_edit |
Especializado en los modelos de edición | text-davinci-edit-001, code-davinci-edit-001 |
r50k_base |
Tokenizador original de GPT-3, con vocabulario básico | Modelos antiguos davinci, curie, babbage y ada |
o200k_base |
Tokenizador actual de los modelos GPT-5, GPT-4.1, GPT-4o y de la serie o de OpenAI (según tiktoken de OpenAI) | GPT-5, GPT-4.1, GPT-4o, GPT-4o-mini, o1, o3, o4-mini |
Modelos y ventanas de contexto
Cada modelo de OpenAI tiene una ventana de contexto máxima, es decir, el número de tokens que puede procesar en una sola petición:
| Modelo | Tokens máx. | Tipo de codificación |
|---|---|---|
gpt-5 |
272.000 | o200k_base |
gpt-4.1 |
1.047.576 | o200k_base |
gpt-4o |
128.000 | o200k_base |
gpt-4o-mini |
128.000 | o200k_base |
o3 |
200.000 | o200k_base |
o4-mini |
200.000 | o200k_base |
o1 |
200.000 | o200k_base |
gpt-4-turbo |
128.000 | cl100k_base |
gpt-4 |
8.192 | cl100k_base |
gpt-3.5-turbo |
16.385 | cl100k_base |
text-embedding-3-large |
8.191 | cl100k_base |
text-embedding-3-small |
8.191 | cl100k_base |
text-embedding-ada-002 |
8.191 | cl100k_base |
Métodos de recuento de tokens
Esta calculadora ofrece dos formas de contar:
| Método | Estándar | Ordinario |
|---|---|---|
encode() |
Tokenización completa que devuelve los identificadores de token y trata el HTML de forma especial | encodeOrdinary() trata el HTML como texto plano |
countTokens() |
Método optimizado que solo cuenta tokens y trata el HTML de forma especial | countTokensOrdinary() trata el HTML como texto plano |
Tratamiento del HTML: si tu texto contiene HTML, los métodos estándar reconocen las etiquetas y las procesan de forma especial, mientras que los métodos ordinarios las consideran texto corriente. Por eso el resultado puede variar de un método a otro. Usa los métodos ordinarios cuando quieras que el HTML se conserve exactamente tal y como lo escribiste.
Consejos para contar tokens
- El texto repetitivo suele consumir menos tokens que un texto irrepetible de la misma longitud
- Los espacios en blanco (espacios, tabulaciones y saltos de línea) también cuentan como tokens
- Los caracteres especiales pueden tokenizarse de uno en uno y disparar el recuento
- Las palabras frecuentes gastan menos tokens que los términos raros o muy técnicos
- El texto en español y otros idiomas distintos del inglés suele consumir más tokens que el equivalente en inglés (los acentos y la eñe se parten a menudo en varios tokens)
- El código fuente se tokeniza de forma bastante eficiente con los tokenizadores más recientes (o200k_base, cl100k_base)
Ejemplos habituales de recuento
| Texto | Tokens | Observación |
|---|---|---|
| "Hello world" | 2 | Las palabras frecuentes suelen ocupar un solo token |
| "antidisestablishmentarianism" | 5 | Las palabras largas se dividen en varios tokens |
| "こんにちは" | 3 | Los caracteres no latinos suelen necesitar más tokens |
| "1234567890" | 3 | Las cifras se agrupan en bloques de varios tokens |
| "<div>Hello</div>" | 4-6 | Las etiquetas HTML pueden contarse distinto según el método estándar u ordinario |