Was ist der TF-IDF-Rechner?
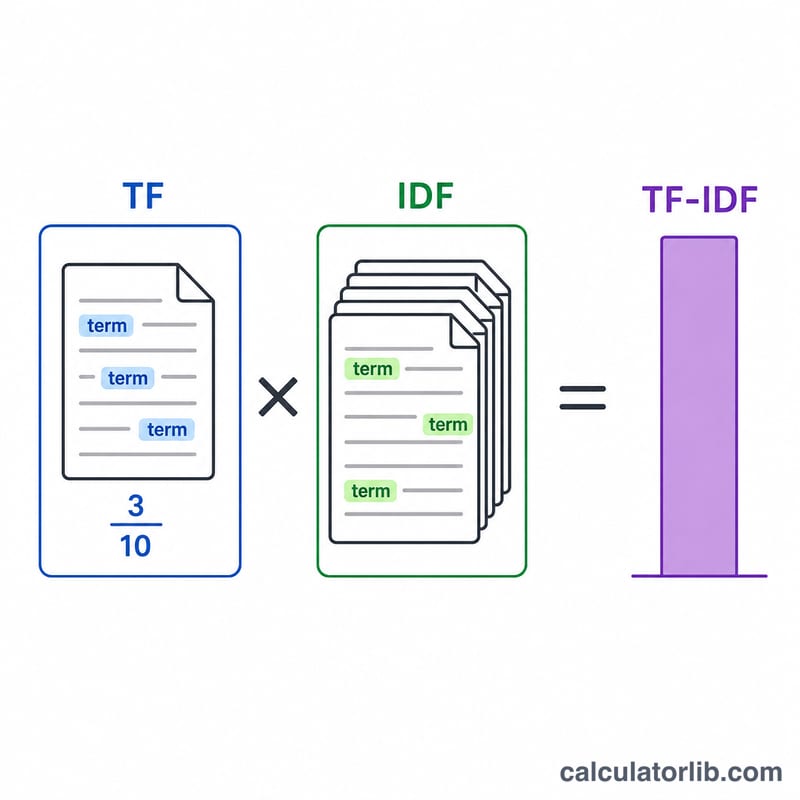
TF-IDF (Term Frequency–Inverse Document Frequency) ist eine Kennzahl aus dem Information Retrieval, der Suchmaschinentechnik und dem Text Mining. Sie misst, wie wichtig ein Wort für ein einzelnes Dokument innerhalb einer größeren Dokumentensammlung (dem sogenannten Korpus) ist. Mit diesem Rechner geben Sie ein Dokument, einen Zielbegriff, die Gesamtzahl der Dokumente in Ihrem Korpus sowie die Anzahl der Dokumente ein, die den Begriff enthalten. Anschließend berechnet er die Termfrequenz (TF), die inverse Dokumentfrequenz (IDF) und den kombinierten TF-IDF-Wert.
So verwenden Sie den Rechner
- Dokument: Fügen Sie den Text des Dokuments ein, das Sie analysieren möchten.
- Begriff: Geben Sie das einzelne Wort oder die Phrase ein, die bewertet werden soll.
- Korpusgröße: Die Gesamtzahl der Dokumente in Ihrer Sammlung (\(N\)).
- Dokumente mit dem Begriff: Wie viele Dokumente den Begriff mindestens einmal enthalten.
Der Rechner zählt, wie oft der Begriff in Ihrem Dokument vorkommt, und teilt diese Zahl durch die Gesamtwortzahl. Anschließend verknüpft er das Ergebnis mit der Seltenheit des Begriffs im gesamten Korpus.
Die Formel erklärt
Die Standardformel für TF-IDF lautet:
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{wobei}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{Anzahl von }\text{Begriff}\text{ in }\text{Dokument}}{\text{Wörter insgesamt in }\text{Dokument}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Korpusgröße}}{\text{Dokumente mit Begriff} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF = (Häufigkeit, mit der der Begriff im Dokument vorkommt) ÷ (Gesamtwortzahl des Dokuments)
- IDF = \(\log(N \div \text{Anzahl der Dokumente, die den Begriff enthalten})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
Ein hoher TF-IDF-Wert bedeutet, dass der Begriff in Ihrem Dokument häufig, im Korpus insgesamt aber selten vorkommt – ein starkes Indiz dafür, dass das Wort für dieses Dokument kennzeichnend und aussagekräftig ist.
Rechenbeispiel
Angenommen, Ihr Dokument umfasst 100 Wörter und der Begriff „marketing“ kommt 5-mal vor. Ihr Korpus enthält 1.000 Dokumente, und 100 davon erwähnen „marketing“.
- TF = \(5 \div 100 = 0{,}05\)
- IDF = \(\log(1000 \div 100) = \log(10) = 1\) (Basis 10)
- TF-IDF = \(0{,}05 \times 1 = 0{,}05\)
Käme „marketing“ stattdessen nur in 10 Dokumenten vor, stiege der IDF-Wert auf \(\log(100) = 2\) und der Wert würde sich auf 0,10 verdoppeln – seltenere, markantere Begriffe werden also belohnt.
Wichtige Begriffe und Variablen
| Begriff | Symbol | Definition |
|---|---|---|
| Term (Begriff) | \(t\) | Das Wort, der Wortstamm oder die Phrase, die bewertet wird. Was als ein Term gilt, muss im gesamten Korpus einheitlich festgelegt sein. |
| Dokument | \(d\) | Eine zu bewertende Texteinheit – ein Artikel, eine Seite, eine Produktbeschreibung, ein Support-Ticket. TF bezieht sich immer auf ein einzelnes Dokument. |
| Korpus | \(D\) | Die gesamte Dokumentensammlung, an der die Seltenheit gemessen wird. IDF ist eine Eigenschaft des Korpus, nicht des Dokuments. |
| Korpusgröße | \(N\) | Die Anzahl der Dokumente im Korpus, einschließlich des bewerteten Dokuments. |
| Dokumentfrequenz | \(df\) | Wie viele Dokumente den Begriff mindestens einmal enthalten. Es werden Dokumente gezählt, nie Vorkommen, daher gilt \(0 \le df \le N\). |
| Absolute Termanzahl | \(tf\) | Die Häufigkeit, mit der der Begriff im einen Dokument vorkommt – die nicht normalisierte Anzahl. |
| Termfrequenz | TF | Die normalisierte Anzahl: \(tf\) geteilt durch die Gesamtwortzahl des Dokuments. Ein Anteil zwischen 0 und 1, der den Einfluss der Dokumentlänge beseitigt. |
| Inverse Dokumentfrequenz | IDF | Ein logarithmisches Maß für die globale Seltenheit. Groß, wenn der Begriff in wenigen Dokumenten vorkommt, klein, wenn er in vielen vorkommt. |
| TF-IDF | — | Das Produkt \(\text{TF} \times \text{IDF}\): hoch, wenn ein Begriff lokal häufig und global selten ist. |
| Tokenisierung | — | Das Zerlegen von Rohtext in zählbare Tokens – üblicherweise Umwandlung in Kleinbuchstaben, Entfernen von Satzzeichen und Festlegen, wie Zahlen, Bindestriche und Kontraktionen behandelt werden. Sie bestimmt sowohl den Nenner von TF als auch, was als Treffer zählt. |
| Stoppwort | — | Ein sehr häufiges Funktionswort (der, von, und, ist), das kaum thematische Information trägt. Wird oft vor der Bewertung entfernt, obwohl TF-IDF solche Wörter von selbst unterdrückt, weil ihr IDF nahe dem Minimum liegt. |
| Glättung (Smoothing) | — | Die \(+1\)-Terme in \(\ln(1 + N/(df+1))\). Die \(+1\) im Nenner verhindert eine Division durch null, wenn \(df = 0\) ist (ein im Korpus nicht vorkommender Begriff); die \(+1\) innerhalb des Logarithmus hält das Argument über 1, sodass das Ergebnis stets streng positiv ist und nie null oder negativ wird. |
| Logarithmusbasis | \(\ln\), \(\log_{10}\) | Die im IDF verwendete Logarithmusbasis. Ein Basiswechsel multipliziert jeden IDF-Wert lediglich mit einer Konstanten – \(\ln x = \log_{10}x \times \ln 10 \approx 2{,}3026\,\log_{10}x\) –, sodass die Rangfolge der Begriffe unverändert bleibt, die absoluten Zahlen jedoch nicht. Geben Sie daher immer an, welche Basis Sie verwendet haben. |
| Vokabular | \(V\) | Die Menge der unterschiedlichen Terme im Korpus nach der Tokenisierung. Ihre Größe entspricht der Dimension des TF-IDF-Vektorraums. |
Beachten Sie, dass TF-IDF eine Familie von Formeln ist und keine einzelne Formel: Zu den Varianten zählen TF mit absoluter Anzahl, logarithmisch normalisiertes TF \(1 + \ln(tf)\), erweitertes (augmented) TF sowie ungeglättetes oder probabilistisches IDF. Werte aus unterschiedlichen Varianten sollten niemals direkt miteinander verglichen werden.
Häufig gestellte Fragen
Warum wird beim IDF ein Logarithmus verwendet? Der Logarithmus dämpft den Einfluss extrem seltener Begriffe, sodass ein einzelnes Vorkommen den Wert nicht dominiert und die Ergebnisse ausgewogen bleiben.
Welche Logarithmusbasis sollte ich verwenden? Die Basis 10 und der natürliche Logarithmus (ln) sind beide üblich. Die Basis skaliert die Ergebnisse nur einheitlich, daher bleiben Vergleiche innerhalb desselben Korpus gültig.
Was bedeutet ein Wert von null? Kommt ein Begriff in jedem Dokument vor (\(N\) = Dokumente mit dem Begriff), ergibt der IDF \(\log(1) = 0\). Der TF-IDF-Wert ist dann null – das Wort hat keinen unterscheidenden Wert.
Ähnliche Rechner
- Kosinus-Ähnlichkeit-Rechner – Ähnlichkeit zwischen zwei Vektoren.