TF-IDF 계산기란?
TF-IDF(Term Frequency–Inverse Document Frequency, 단어 빈도–역문서 빈도)는 정보 검색, 검색 엔진, 텍스트 마이닝 분야에서 특정 단어가 여러 문서 집합(코퍼스) 안의 한 문서에서 얼마나 중요한지를 수치로 나타내는 통계 지표입니다. 이 계산기에서는 분석할 문서, 점수를 매길 단어, 코퍼스에 포함된 전체 문서 수, 그리고 그 단어가 등장하는 문서의 수를 입력할 수 있습니다. 그러면 단어 빈도(TF), 역문서 빈도(IDF), 그리고 이 둘을 결합한 TF-IDF 점수를 한 번에 계산해 줍니다.
사용 방법
- 문서: 분석하려는 문서의 텍스트를 붙여 넣으세요.
- 단어: 점수를 매기고 싶은 단어나 구를 입력하세요.
- 코퍼스 크기: 전체 문서 집합에 들어 있는 문서의 총 개수(\(N\))입니다.
- 단어 포함 문서 수: 해당 단어가 한 번 이상 등장하는 문서의 개수입니다.
계산기는 문서 안에서 그 단어가 몇 번 나오는지 세어 전체 단어 수로 나눈 뒤, 코퍼스 전체에서 그 단어가 얼마나 희소한지를 함께 반영해 최종 점수를 산출합니다.
공식 풀이
표준 TF-IDF 공식은 다음과 같습니다.
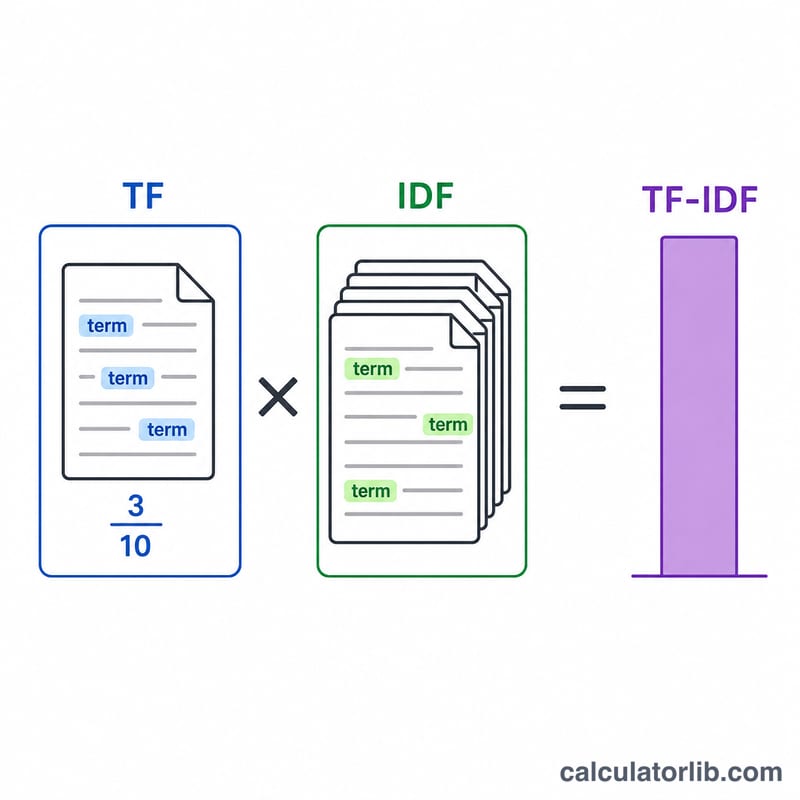
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF \(=\) (문서에서 단어가 등장한 횟수) \(\div\) (문서의 전체 단어 수)
- IDF \(= \log(N \div\) 해당 단어를 포함한 문서 수\()\)
- TF-IDF \(= \text{TF} \times \text{IDF}\)
TF-IDF 점수가 높다는 것은 그 단어가 해당 문서에서는 자주 등장하지만 코퍼스 전체에서는 드물게 나타난다는 뜻입니다. 즉, 그 단어가 그 문서를 잘 구별해 주는 특징적이고 의미 있는 단어라는 강력한 신호입니다.
예제로 보는 계산
예를 들어 문서가 100개의 단어로 이루어져 있고 그 안에 "마케팅"이라는 단어가 5번 등장한다고 가정해 봅시다. 코퍼스에는 총 1,000개의 문서가 있고, 그중 100개의 문서가 "마케팅"을 언급합니다.
- $$\text{TF} = 5 \div 100 = 0.05$$
- $$\text{IDF} = \log(1000 \div 100) = \log(10) = 1 \ (\text{밑이 10})$$
- $$\text{TF-IDF} = 0.05 \times 1 = 0.05$$
만약 "마케팅"이 10개의 문서에만 등장했다면 IDF는 \(\log(100) = 2\)로 올라가고, 점수도 0.10으로 두 배가 됩니다. 더 희소하고 특징적인 단어에 더 높은 가중치를 주는 셈입니다.
주요 용어 및 변수
| 용어 | 기호 | 정의 |
|---|---|---|
| 용어 | \(t\) | 점수가 매겨지는 단어, 어근 또는 구문. 용어로 간주되는 것이 무엇이든 전체 말뭉치에서 일관되게 정의되어야 합니다. |
| 문서 | \(d\) | 점수가 매겨지는 텍스트의 한 단위 — 기사, 페이지, 제품 설명, 지원 티켓. TF는 항상 단일 문서에 상대적입니다. |
| 말뭉치 | \(D\) | 희귀성이 판단되는 문서의 전체 모음. IDF는 문서의 속성이 아니라 말뭉치의 속성입니다. |
| 말뭉치 크기 | \(N\) | 점수가 매겨지는 것을 포함하여 말뭉치의 문서 수. |
| 문서 빈도 | \(df\) | 용어를 최소한 한 번 포함하는 문서의 수. 문서의 개수로 계산되며, 절대 발생 횟수가 아니므로 \(0 \le df \le N\). |
| 원시 용어 수 | \(tf\) | 한 문서 내에서 용어가 발생하는 횟수 — 정규화되지 않은 수. |
| 용어 빈도 | TF | 정규화된 수, 문서의 전체 단어 수로 나눈 \(tf\). 문서 길이의 영향을 제거하는 0과 1 사이의 비율. |
| 역 문서 빈도 | IDF | 전역 희귀성의 로그 측정값. 용어가 적은 문서에 나타날 때는 크고, 많은 문서에 나타날 때는 작습니다. |
| TF-IDF | — | 곱셈 \(\text{TF} \times \text{IDF}\): 용어가 국소적으로 빈번하고 전역적으로 희귀할 때 높음. |
| 토큰화 | — | 원시 텍스트를 계산 가능한 토큰으로 분할 — 일반적으로 소문자화, 구두점 제거, 숫자, 하이픈 및 축약형 처리 방식 결정. TF 분모와 일치하는 것으로 계산되는 것을 모두 수정합니다. |
| 불용어 | — | 거의 주제 정보를 전달하지 않는 매우 일반적인 기능 단어 (the, of, and, is). 점수 매기기 전에 제거되는 경우가 많지만, TF-IDF는 IDF가 최소값에 가깝기 때문에 자체적으로 이러한 단어를 억제합니다. |
| 평활 | — | \(\ln(1 + N/(df+1))\)의 \(+1\) 항. 분모의 \(+1\)은 \(df = 0\)일 때(말뭉치에서 나타나지 않은 용어) 0으로 나누기를 방지하고; 로그 안의 \(+1\)은 인수를 1 이상으로 유지하므로 결과는 항상 순수 양수이며 절대 0 또는 음수가 아닙니다. |
| 로그 밑 | \(\ln\), \(\log_{10}\) | IDF에 사용되는 로그의 밑. 밑을 변경하면 모든 IDF에 상수만 곱해집니다 — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — 따라서 용어의 순위는 변경되지 않지만 절대값은 변경됩니다. 항상 사용한 밑을 명시하세요. |
| 어휘 | \(V\) | 토큰화 후 말뭉치 전체에서 서로 다른 용어의 집합. 그 크기는 TF-IDF 벡터 공간의 차원입니다. |
TF-IDF는 단일 공식이 아니라 공식 모음이라는 점에 유의하세요: 변형에는 원시 수 TF, 로그 정규화 TF \(1 + \ln(tf)\), 증강 TF, 평활되지 않은 또는 확률적 IDF가 포함됩니다. 서로 다른 변형의 점수를 직접 비교해서는 안 됩니다.
자주 묻는 질문
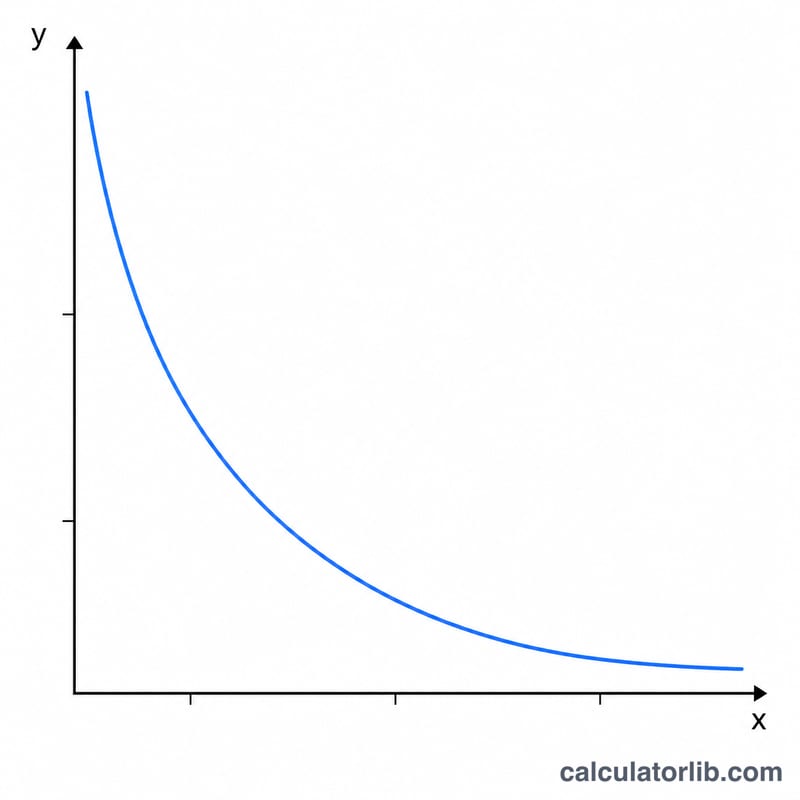
IDF에 왜 로그를 사용하나요? 로그는 극단적으로 희소한 단어의 영향을 완화해, 단 한 번의 등장이 점수를 좌우하지 않도록 막아 줍니다. 덕분에 결과가 한쪽으로 치우치지 않고 균형을 유지합니다.
로그의 밑은 무엇을 써야 하나요? 밑이 10인 상용로그와 자연로그(\(\ln\))가 모두 흔히 쓰입니다. 밑을 무엇으로 하든 결과 전체가 같은 비율로 조정될 뿐이므로, 동일한 코퍼스 안에서의 비교에는 영향을 주지 않습니다.
점수가 0이면 무슨 뜻인가요? 어떤 단어가 모든 문서에 등장한다면(\(N =\) 단어 포함 문서 수), IDF는 \(\log(1) = 0\)이 되어 TF-IDF 점수도 0이 됩니다. 즉, 그 단어는 문서를 구별하는 데 아무런 변별력이 없다는 의미입니다.