Что такое калькулятор TF-IDF?
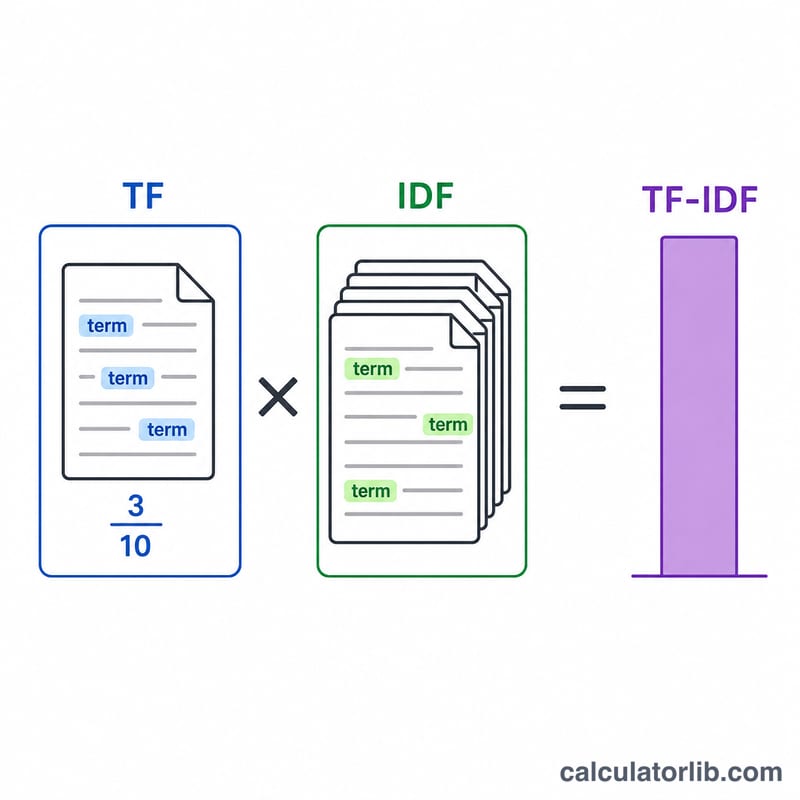
TF-IDF (от англ. Term Frequency — Inverse Document Frequency, то есть «частота термина — обратная частота документа») — это числовая мера, которую применяют в информационном поиске, поисковых системах и анализе текста. Она показывает, насколько важно конкретное слово для отдельного документа на фоне всей коллекции документов (так называемого корпуса). С помощью этого калькулятора вы вводите текст документа, интересующий вас термин, общее число документов в корпусе и количество документов, в которых этот термин встречается. После этого инструмент рассчитывает частоту термина (TF), обратную частоту документа (IDF) и итоговый вес TF-IDF.
Как пользоваться калькулятором
- Документ: вставьте текст документа, который хотите проанализировать.
- Термин: укажите слово или словосочетание, вес которого нужно оценить.
- Размер корпуса: общее число документов в вашей коллекции (\(N\)).
- Документы с термином: сколько документов содержат этот термин хотя бы один раз.
Калькулятор подсчитывает, как часто термин встречается в вашем документе, делит это число на общее количество слов, а затем учитывает, насколько редко термин попадается во всём корпусе.
Разбор формулы
Классическая формула TF-IDF выглядит так:
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF = (сколько раз термин встречается в документе) ÷ (общее число слов в документе)
- IDF = \(\log(N \div \text{число документов, содержащих термин})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
Высокий вес TF-IDF означает, что термин часто встречается в вашем документе, но редко — во всём корпусе. Это явный сигнал того, что слово отличает данный документ от остальных и несёт для него смысловую нагрузку.
Разбор на примере
Допустим, в вашем документе 100 слов, а термин «маркетинг» встречается 5 раз. В корпусе 1000 документов, и в 100 из них упоминается «маркетинг».
- TF = \(5 \div 100 = 0{,}05\)
- IDF = \(\log(1000 \div 100) = \log(10) = 1\) (по основанию 10)
- TF-IDF = \(0{,}05 \times 1 = 0{,}05\)
Если бы «маркетинг» встречался только в 10 документах, IDF вырос бы до \(\log(100) = 2\), а итоговый вес удвоился бы до \(0{,}10\) — так формула вознаграждает более редкие и характерные термины.
Ключевые термины и переменные
| Термин | Символ | Определение |
|---|---|---|
| Термин | \(t\) | Слово, основа или фраза, получающая оценку. То, что считается одним термином, должно быть определено последовательно по всему корпусу. |
| Документ | \(d\) | Одна единица текста, получающая оценку — статья, страница, описание продукта, билет поддержки. TF всегда относится к одному документу. |
| Корпус | \(D\) | Полная коллекция документов, по которой оценивается редкость. IDF — это свойство корпуса, а не документа. |
| Размер корпуса | \(N\) | Количество документов в корпусе, включая документ, получающий оценку. |
| Частота документа | \(df\) | Сколько документов содержат термин по крайней мере один раз. Подсчет документов, а не вхождений, поэтому \(0 \le df \le N\). |
| Сырой подсчет термина | \(tf\) | Количество раз, когда термин встречается в документе — ненормализованный подсчет. |
| Частота термина | TF | Нормализованный подсчет, \(tf\) разделённый на общее количество слов в документе. Доля от 0 до 1, которая устраняет влияние длины документа. |
| Обратная частота документа | IDF | Логарифмическая мера глобальной редкости. Большая, когда термин встречается в нескольких документах, маленькая, когда он встречается во многих. |
| TF-IDF | — | Произведение \(\text{TF} \times \text{IDF}\): высокое, когда термин часто встречается локально и редок глобально. |
| Токенизация | — | Разбиение необработанного текста на счетные токены — обычно приведение к нижнему регистру, удаление пунктуации и решение о том, как обрабатывать цифры, дефисы и сокращения. Это устанавливает как знаменатель TF, так и то, что считается совпадением. |
| Стоп-слово | — | Очень распространённое служебное слово (и, в, не, это), которое несёт мало тематической информации. Часто удаляется перед оценкой, хотя TF-IDF подавляет такие слова самостоятельно, потому что их IDF близко к минимуму. |
| Сглаживание | — | Члены \(+1\) в \(\ln(1 + N/(df+1))\). Член \(+1\) в знаменателе предотвращает деление на ноль, когда \(df = 0\) (термин, не встречающийся в корпусе); член \(+1\) внутри логарифма сохраняет аргумент выше 1, поэтому результат всегда строго положительный и никогда не равен нулю или отрицателен. |
| Основание логарифма | \(\ln\), \(\log_{10}\) | Основание логарифма, используемое в IDF. Изменение основания только умножает каждый IDF на константу — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — поэтому ранжирование терминов не изменяется, в то время как абсолютные числа изменяются. Всегда указывайте, какое основание вы использовали. |
| Словарь | \(V\) | Набор различных терминов по всему корпусу после токенизации. Его размер — это размерность пространства TF-IDF векторов. |
Обратите внимание, что TF-IDF — это семейство формул, а не единая формула: варианты включают TF с сырым подсчетом, логарифмически нормализованный TF \(1 + \ln(tf)\), дополненный TF и несглаженный или вероятностный IDF. Оценки от различных вариантов никогда не должны сравниваться напрямую.
Часто задаваемые вопросы
Зачем в IDF используется логарифм? Логарифм сглаживает влияние крайне редких терминов: благодаря ему единственное вхождение не «перетягивает» весь результат на себя, и значения остаются сбалансированными.
Какое основание логарифма выбрать? Чаще всего применяют основание 10 или натуральный логарифм (\(\ln\)). Основание лишь равномерно масштабирует все результаты, поэтому сравнения внутри одного корпуса остаются корректными.
Что означает нулевой вес? Если термин встречается в каждом документе (\(N\) = числу документов с термином), то IDF превращается в \(\log(1) = 0\), и итоговый вес TF-IDF тоже становится нулевым — такое слово не помогает отличить один документ от другого.