Qu'est-ce que le calculateur TF-IDF ?
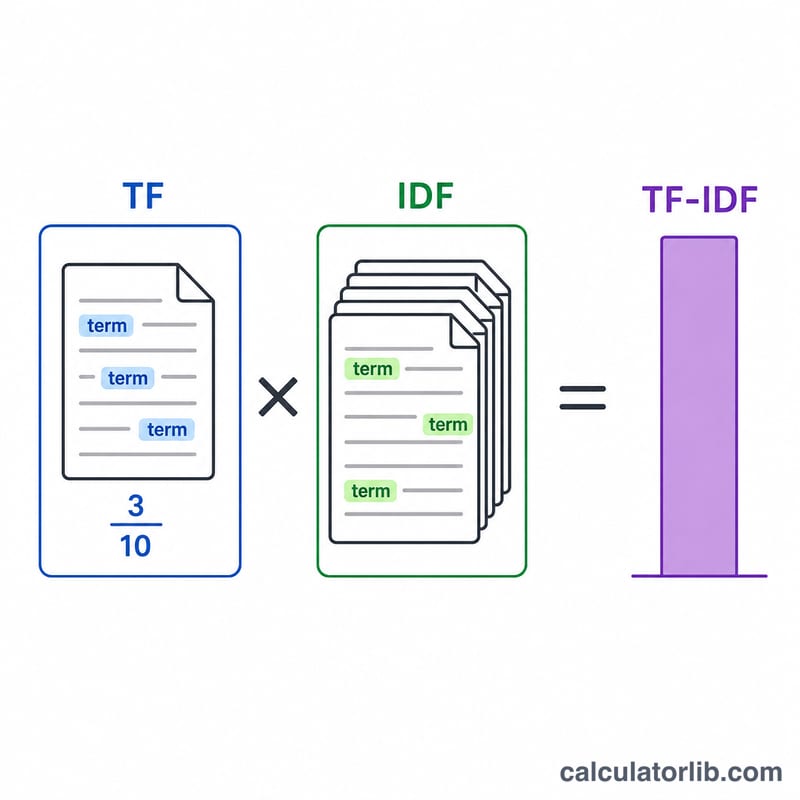
Le TF-IDF (Term Frequency–Inverse Document Frequency, soit « fréquence du terme – fréquence inverse de document ») est une mesure statistique utilisée en recherche d'information, dans les moteurs de recherche et en fouille de textes. Il évalue l'importance d'un mot au sein d'un document donné, par rapport à un ensemble plus vaste de documents (appelé corpus). Ce calculateur vous permet de saisir un document, un terme cible, le nombre total de documents de votre corpus, ainsi que le nombre de documents qui contiennent ce terme. Il calcule ensuite la fréquence du terme (TF), la fréquence inverse de document (IDF) et le score TF-IDF combiné.
Comment l'utiliser
- Document : collez le texte du document que vous souhaitez analyser.
- Terme : indiquez le mot ou l'expression dont vous voulez calculer le score.
- Taille du corpus : le nombre total de documents de votre collection (\(N\)).
- Documents contenant le terme : le nombre de documents où le terme apparaît au moins une fois.
Le calculateur compte le nombre d'occurrences du terme dans votre document, le divise par le nombre total de mots, puis combine ce résultat avec la rareté du terme à l'échelle du corpus.
La formule expliquée
La formule standard du TF-IDF est la suivante :
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF = (nombre d'occurrences du terme dans le document) ÷ (nombre total de mots du document)
- IDF = log(\(N\) ÷ nombre de documents contenant le terme)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
Un score TF-IDF élevé signifie que le terme apparaît fréquemment dans votre document mais rarement dans l'ensemble du corpus : c'est un signal fort indiquant que ce mot est distinctif et porteur de sens pour ce document.
Exemple concret
Supposons que votre document compte 100 mots et que le terme « marketing » y apparaisse 5 fois. Votre corpus contient 1 000 documents, dont 100 mentionnent « marketing ».
- TF = \(5 \div 100 = 0{,}05\)
- IDF = \(\log(1000 \div 100) = \log(10) = 1\) (en base 10)
- TF-IDF = \(0{,}05 \times 1 = 0{,}05\)
Si « marketing » n'apparaissait que dans 10 documents, l'IDF passerait à \(\log(100) = 2\), ce qui doublerait le score pour atteindre 0,10 : les termes plus rares et plus distinctifs sont ainsi valorisés.
Termes et variables clés
| Terme | Symbole | Définition |
|---|---|---|
| Terme | \(t\) | Le mot, la racine ou l'expression en cours d'évaluation. Ce qui compte comme un terme doit être défini de manière cohérente dans l'ensemble du corpus. |
| Document | \(d\) | Une unité de texte en cours d'évaluation — un article, une page, une description de produit, un ticket d'assistance. TF est toujours relatif à un seul document. |
| Corpus | \(D\) | La collection complète de documents par rapport à laquelle la rareté est jugée. IDF est une propriété du corpus, pas du document. |
| Taille du corpus | \(N\) | Le nombre de documents dans le corpus, y compris celui en cours d'évaluation. |
| Fréquence de document | \(df\) | Le nombre de documents contenant le terme au moins une fois. Un décompte de documents, jamais d'occurrences, donc \(0 \le df \le N\). |
| Nombre de termes bruts | \(tf\) | Le nombre de fois où le terme apparaît dans le document unique — le décompte non normalisé. |
| Fréquence des termes | TF | Le décompte normalisé, \(tf\) divisé par le nombre total de mots du document. Une proportion entre 0 et 1 qui supprime l'effet de la longueur du document. |
| Fréquence inverse de document | IDF | Une mesure logarithmique de la rareté globale. Grande quand le terme apparaît dans peu de documents, petite quand il apparaît dans nombreux documents. |
| TF-IDF | — | Le produit \(\text{TF} \times \text{IDF}\) : élevé quand un terme est localement fréquent et globalement rare. |
| Tokenisation | — | Division du texte brut en jetons dénombrables — généralement minuscules, suppression de la ponctuation, et décision de la façon de traiter les nombres, les traits d'union et les contractions. Elle fixe le dénominateur TF et ce qui compte comme une correspondance. |
| Mot vide | — | Un mot fonctionnel très courant (le, de, et, est) qui porte peu d'information thématique. Souvent supprimé avant l'évaluation, bien que TF-IDF supprime de tels mots de lui-même car leur IDF est proche du minimum. |
| Lissage | — | Les \(+1\) dans \(\ln(1 + N/(df+1))\). Le \(+1\) dans le dénominateur empêche la division par zéro quand \(df = 0\) (un terme absent du corpus) ; le \(+1\) à l'intérieur du logarithme maintient l'argument au-dessus de 1, donc le résultat est toujours strictement positif et jamais zéro ou négatif. |
| Base logarithmique | \(\ln\), \(\log_{10}\) | La base du logarithme utilisée dans IDF. Changer de base ne fait que multiplier chaque IDF par une constante — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — donc le classement des termes ne change pas tandis que les nombres absolus ne le font pas. Déclarez toujours la base que vous avez utilisée. |
| Vocabulaire | \(V\) | L'ensemble des termes distincts dans le corpus après tokenisation. Sa taille est la dimensionnalité de l'espace vectoriel TF-IDF. |
Notez que TF-IDF est une famille de formules plutôt qu'une seule : les variantes incluent TF à décompte brut, TF normalisé par le logarithme \(1 + \ln(tf)\), TF augmenté, et IDF non lissé ou probabiliste. Les scores provenant de variantes différentes ne doivent jamais être comparés directement.
Questions fréquentes
Pourquoi utiliser un logarithme dans l'IDF ? Le logarithme atténue l'effet des termes extrêmement rares, afin qu'une seule occurrence ne domine pas le score et que les résultats restent équilibrés.
Quelle base de logarithme choisir ? La base 10 et le logarithme népérien (\(\ln\)) sont tous deux courants. La base ne fait qu'appliquer une échelle uniforme aux résultats : les comparaisons au sein d'un même corpus restent donc valables.
Que signifie un score nul ? Si un terme apparaît dans tous les documents (\(N\) = nombre de documents contenant le terme), l'IDF vaut \(\log(1) = 0\), ce qui rend le score TF-IDF nul : le mot n'apporte alors aucune valeur distinctive.