ما هي حاسبة TF-IDF؟
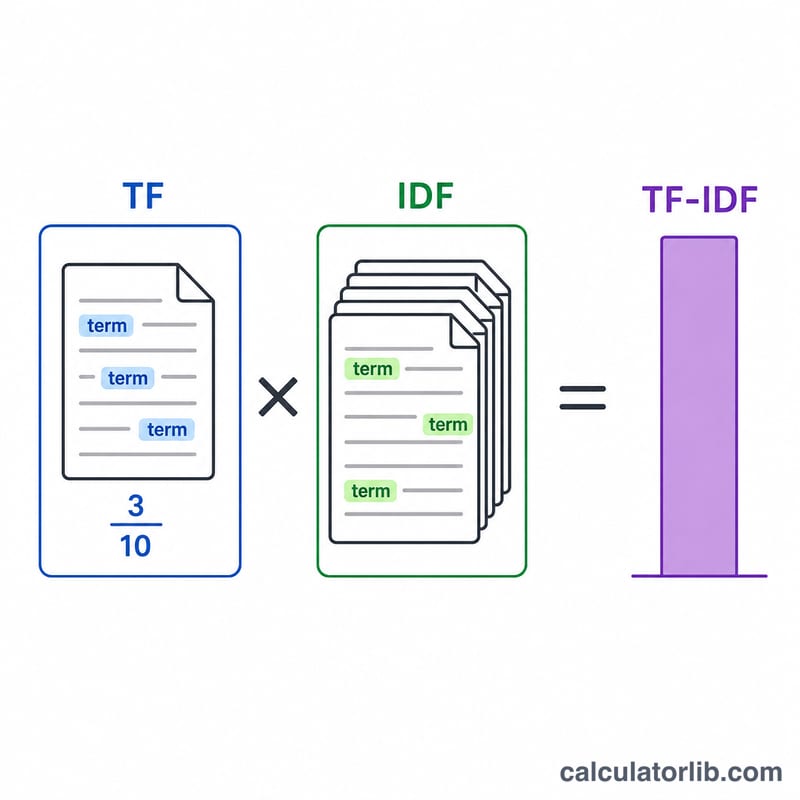
إن TF-IDF (اختصار لـ Term Frequency–Inverse Document Frequency، أي تكرار الكلمة مقابل التكرار العكسي للوثائق) مقياس إحصائي يُستخدم في استرجاع المعلومات ومحركات البحث والتنقيب في النصوص لتقدير مدى أهمية كلمة معينة داخل وثيقة واحدة ضمن مجموعة أكبر من الوثائق تُسمى "المتن" أو الـ corpus. تتيح لك هذه الحاسبة إدخال نص الوثيقة، والكلمة المستهدفة، وإجمالي عدد الوثائق في مجموعتك، وعدد الوثائق التي تحتوي على هذه الكلمة. ثم تحسب لك تكرار الكلمة (TF) والتكرار العكسي للوثائق (IDF) ودرجة TF-IDF المجمّعة.
كيفية الاستخدام
- النص: الصق نص الوثيقة التي تريد تحليلها.
- الكلمة: أدخل الكلمة أو العبارة المفردة التي ترغب في حساب درجتها.
- حجم المجموعة: إجمالي عدد الوثائق في مجموعتك (\(N\)).
- الوثائق التي تحتوي الكلمة: عدد الوثائق التي تظهر فيها الكلمة مرة واحدة على الأقل.
تحسب الأداة عدد مرات ظهور الكلمة في نصك ثم تقسمه على إجمالي عدد الكلمات، وتدمج النتيجة مع مدى ندرة الكلمة عبر مجموعة الوثائق بأكملها.
شرح المعادلة
معادلة TF-IDF القياسية هي:
$$\text{TF-IDF} = \text{TF} \times \text{IDF}$$- TF = (عدد مرات ظهور الكلمة في الوثيقة) ÷ (إجمالي الكلمات في الوثيقة)
- IDF = \(\log(N \div \text{عدد الوثائق التي تحتوي الكلمة})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
تعني درجة TF-IDF المرتفعة أن الكلمة تتكرر كثيرًا داخل وثيقتك لكنها نادرة عبر بقية الوثائق — وهي إشارة قوية إلى أن الكلمة مميزة وذات دلالة خاصة لتلك الوثيقة.
مثال تطبيقي
لنفترض أن وثيقتك تتكوّن من 100 كلمة، وأن كلمة "تسويق" تظهر فيها 5 مرات. وتحتوي مجموعتك على 1,000 وثيقة، تذكر 100 منها كلمة "تسويق".
- $$\text{TF} = 5 \div 100 = 0.05$$
- $$\text{IDF} = \log(1000 \div 100) = \log(10) = 1 \quad(\text{للأساس }10)$$
- $$\text{TF-IDF} = 0.05 \times 1 = 0.05$$
أما لو ظهرت كلمة "تسويق" في 10 وثائق فقط، فإن قيمة IDF سترتفع إلى \(\log(100) = 2\)، وبذلك تتضاعف الدرجة إلى 0.10 — مكافأةً للكلمات الأندر والأكثر تميزًا.
المصطلحات والمتغيرات الأساسية
| المصطلح | الرمز | التعريف |
|---|---|---|
| المصطلح | \(t\) | الكلمة أو الجذر أو العبارة التي يتم حساب درجتها. أي شيء يُعتبر مصطلحاً واحداً يجب أن يُعرّف بشكل متسق في جميع أنحاء المجموعة. |
| المستند | \(d\) | وحدة نصية واحدة يتم حساب درجتها — مقالة أو صفحة أو وصف منتج أو تذكرة دعم. يكون TF دائماً بالنسبة إلى مستند واحد. |
| المجموعة | \(D\) | المجموعة الكاملة من المستندات التي يتم الحكم على ندرة المصطلح بناءً عليها. يعتبر IDF خاصية المجموعة وليس المستند. |
| حجم المجموعة | \(N\) | عدد المستندات في المجموعة، بما فيها المستند الذي يتم حساب درجته. |
| تكرار المستند | \(df\) | عدد المستندات التي تحتوي على المصطلح مرة واحدة على الأقل. عد للمستندات، وليس للتكرارات، لذا \(0 \le df \le N\). |
| عدد المصطلح الخام | \(tf\) | عدد المرات التي يظهر فيها المصطلح داخل المستند الواحد — العد غير المعياري. |
| تكرار المصطلح | TF | العد المعياري، \(tf\) مقسوماً على إجمالي عدد الكلمات في المستند. نسبة بين 0 و1 تزيل تأثير طول المستند. |
| معكوس تكرار المستند | IDF | مقياس لوغاريتمي للندرة العالمية. كبير عندما يظهر المصطلح في عدد قليل من المستندات، صغير عندما يظهر في الكثير منها. |
| TF-IDF | — | حاصل الضرب \(\text{TF} \times \text{IDF}\): عالي عندما يكون المصطلح متكرراً محلياً ونادراً عالمياً. |
| التجزئة | — | تقسيم النص الخام إلى وحدات قابلة للعد — عادة تحويل الأحرف إلى أحرف صغيرة، وإزالة علامات الترقيم، والاختيار بشأن كيفية معاملة الأرقام والواصلات والاختصارات. إنه يحدد مقسوم TF والذي يُعتبر مطابقة. |
| كلمة وقف | — | كلمة دالة شائعة جداً (ال, من, و, هو) تحمل معلومات موضوعية قليلة. غالباً ما يتم حذفها قبل الحساب، على الرغم من أن TF-IDF يقمع مثل هذه الكلمات بمفردها لأن IDF الخاص بها قريب من الحد الأدنى. |
| التمليس | — | حدود \(+1\) في \(\ln(1 + N/(df+1))\). حد \(+1\) في المقسوم عليه يمنع القسمة على صفر عندما يكون \(df = 0\) (مصطلح غير مرئي في المجموعة)؛ حد \(+1\) داخل اللوغاريتم يحافظ على الحجة أعلى من 1، لذا تكون النتيجة دائماً موجبة تماماً وليست أبداً صفراً أو سالبة. |
| قاعدة اللوغاريتم | \(\ln\), \(\log_{10}\) | قاعدة اللوغاريتم المستخدمة في IDF. تغيير القاعدة فقط يضرب كل IDF بثابت — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — لذا فإن ترتيب المصطلحات لم يتغير بينما الأرقام المطلقة لم تتغير. اذكر دائماً أي قاعدة استخدمت. |
| المفردات | \(V\) | مجموعة المصطلحات المميزة عبر المجموعة بعد التجزئة. حجمها هو بعد فضاء متجه TF-IDF. |
لاحظ أن TF-IDF هي عائلة من الصيغ وليست صيغة واحدة: تشمل المتغيرات TF العد الخام، و TF معياري لوغاريتمياً \(1 + \ln(tf)\)، و TF معزز، و IDF بدون تمليس أو احتمالي. يجب عدم مقارنة الدرجات من متغيرات مختلفة مباشرة.
الأسئلة الشائعة
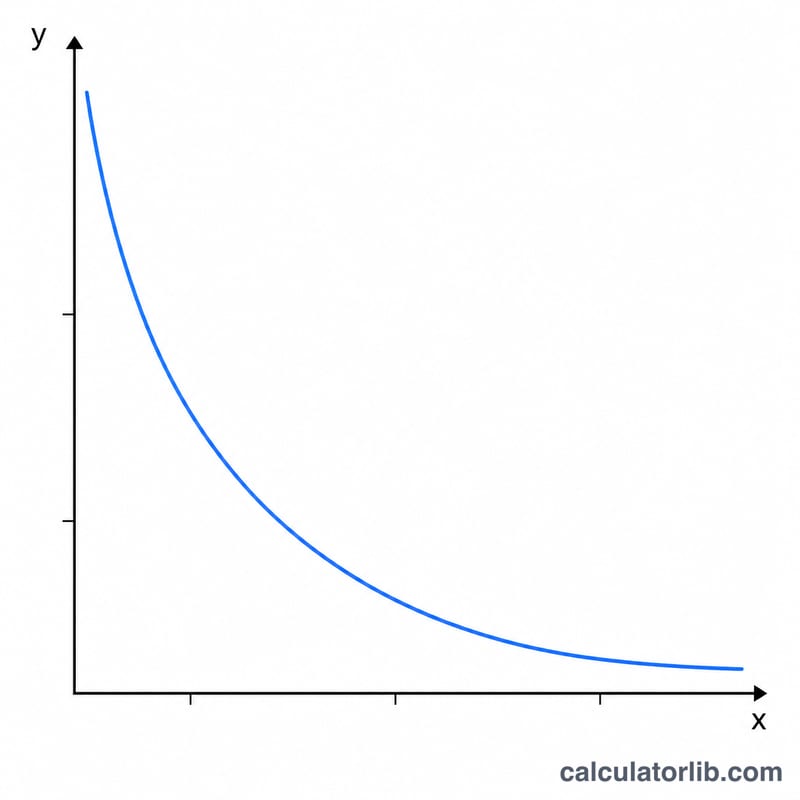
لماذا نستخدم اللوغاريتم في حساب IDF؟ يخفّف اللوغاريتم من تأثير الكلمات شديدة الندرة، حتى لا يسيطر ظهورٌ واحد على الدرجة بأكملها، مما يحافظ على توازن النتائج.
أي أساس لوغاريتمي ينبغي أن أستخدم؟ كلٌّ من الأساس 10 واللوغاريتم الطبيعي (\(\ln\)) شائع الاستخدام. ولا يؤثر الأساس إلا في تحجيم النتائج بشكل موحّد، لذا تبقى المقارنات داخل المجموعة نفسها صحيحة.
ماذا تعني الدرجة صفر؟ إذا ظهرت الكلمة في كل وثيقة (\(N = \text{عدد الوثائق التي تحتوي الكلمة}\))، فإن IDF يصبح \(\log(1) = 0\)، وتغدو درجة TF-IDF صفرًا — أي أن الكلمة لا تحمل أي قيمة تمييزية.