Công cụ tính TF-IDF là gì?
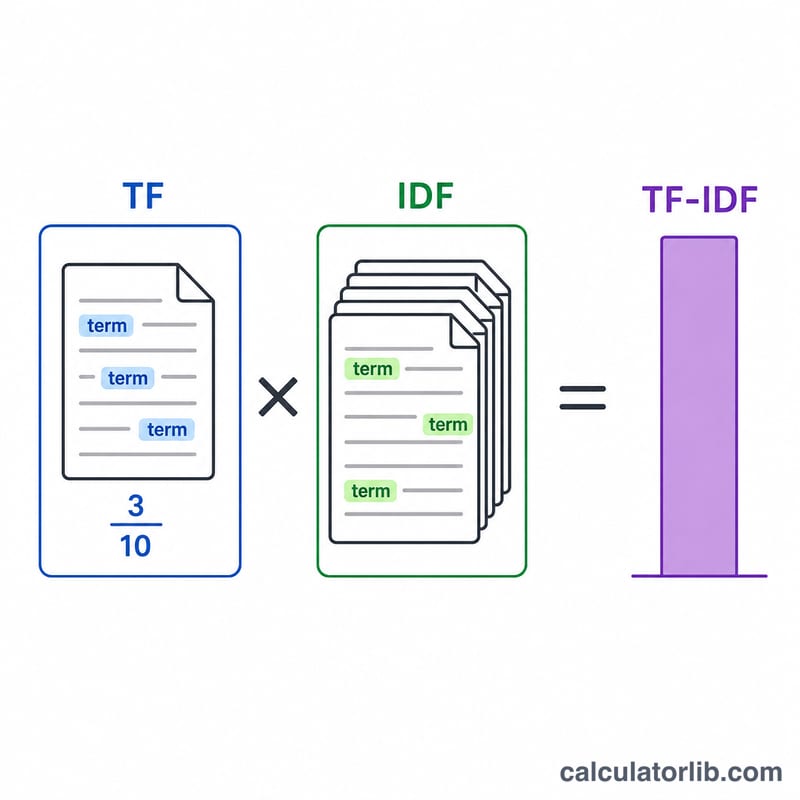
TF-IDF (Term Frequency–Inverse Document Frequency, tức Tần suất từ – Tần suất tài liệu nghịch đảo) là một chỉ số thống kê được dùng rộng rãi trong truy xuất thông tin, công cụ tìm kiếm và khai phá văn bản nhằm đo lường mức độ quan trọng của một từ đối với một tài liệu cụ thể trong tổng thể một tập hợp tài liệu lớn hơn (gọi là corpus, hay tập ngữ liệu). Công cụ này cho phép bạn nhập một tài liệu, một từ khóa cần xét, tổng số tài liệu trong tập ngữ liệu của bạn, cùng với số lượng tài liệu thực sự chứa từ khóa đó. Từ những thông tin này, công cụ sẽ tính ra tần suất từ (TF), tần suất tài liệu nghịch đảo (IDF) và điểm TF-IDF tổng hợp.
Cách sử dụng
- Tài liệu: Dán nội dung văn bản mà bạn muốn phân tích.
- Từ khóa: Nhập một từ hoặc cụm từ mà bạn muốn chấm điểm.
- Kích thước tập ngữ liệu: Tổng số tài liệu trong bộ sưu tập của bạn (\(N\)).
- Số tài liệu chứa từ khóa: Có bao nhiêu tài liệu chứa từ khóa ít nhất một lần.
Công cụ sẽ đếm số lần từ khóa xuất hiện trong tài liệu của bạn, chia cho tổng số từ, rồi kết hợp kết quả đó với mức độ hiếm gặp của từ khóa trên toàn bộ tập ngữ liệu.
Giải thích công thức
Công thức TF-IDF tiêu chuẩn như sau:
- TF \(= \dfrac{\text{số lần từ khóa xuất hiện trong tài liệu}}{\text{tổng số từ trong tài liệu}}\)
- IDF \(= \log\!\left(\dfrac{N}{\text{số tài liệu chứa từ khóa}}\right)\)
- TF-IDF \(= \text{TF} \times \text{IDF}\)
$$\text{TF-IDF} = \text{TF} \times \text{IDF}$$
Điểm TF-IDF càng cao nghĩa là từ khóa xuất hiện thường xuyên trong tài liệu của bạn nhưng lại hiếm gặp trên toàn tập ngữ liệu — đây là dấu hiệu mạnh cho thấy từ đó mang tính đặc trưng và có ý nghĩa quan trọng đối với tài liệu ấy.
Ví dụ minh họa
Giả sử tài liệu của bạn có 100 từ và từ "marketing" xuất hiện 5 lần. Tập ngữ liệu của bạn gồm 1.000 tài liệu, trong đó có 100 tài liệu nhắc đến "marketing".
- $$\text{TF} = 5 \div 100 = 0{,}05$$
- $$\text{IDF} = \log(1000 \div 100) = \log(10) = 1 \quad (\text{cơ số 10})$$
- $$\text{TF-IDF} = 0{,}05 \times 1 = 0{,}05$$
Nếu "marketing" chỉ xuất hiện trong 10 tài liệu, IDF sẽ tăng lên \(\log(100) = 2\), làm điểm số tăng gấp đôi lên \(0{,}10\) — tức là tưởng thưởng cho những từ hiếm gặp và mang tính đặc trưng hơn.
Các Thuật Ngữ và Biến
| Thuật Ngữ | Ký Hiệu | Định Nghĩa |
|---|---|---|
| Thuật Ngữ | \(t\) | Từ, gốc từ hoặc cụm từ được chấm điểm. Bất kỳ thứ gì được tính là một thuật ngữ phải được xác định nhất quán trên toàn bộ kho dữ liệu. |
| Tài Liệu | \(d\) | Một đơn vị văn bản được chấm điểm — một bài viết, một trang, mô tả sản phẩm, vé hỗ trợ. TF luôn tương đối với một tài liệu duy nhất. |
| Kho Dữ Liệu | \(D\) | Tập hợp đầy đủ các tài liệu dựa trên đó sự hiếm hoi được đánh giá. IDF là một thuộc tính của kho dữ liệu, không phải của tài liệu. |
| Kích Thước Kho Dữ Liệu | \(N\) | Số lượng tài liệu trong kho dữ liệu, bao gồm cả tài liệu được chấm điểm. |
| Tần Suất Tài Liệu | \(df\) | Có bao nhiêu tài liệu chứa thuật ngữ ít nhất một lần. Một đếm các tài liệu, không bao giờ đếm các lần xuất hiện, vì vậy \(0 \le df \le N\). |
| Đếm Thuật Ngữ Thô | \(tf\) | Số lần thuật ngữ xuất hiện bên trong tài liệu — đếm chưa chuẩn hóa. |
| Tần Suất Thuật Ngữ | TF | Đếm chuẩn hóa, \(tf\) chia cho tổng số từ của tài liệu. Một tỷ lệ từ 0 đến 1 loại bỏ ảnh hưởng của độ dài tài liệu. |
| Tần Suất Tài Liệu Nghịch Đảo | IDF | Một thước đo logarit của sự hiếm hoi toàn cầu. Lớn khi thuật ngữ xuất hiện trong ít tài liệu, nhỏ khi xuất hiện trong nhiều tài liệu. |
| TF-IDF | — | Tích \(\text{TF} \times \text{IDF}\): cao khi một thuật ngữ xuất hiện thường xuyên cục bộ và hiếm trên toàn cầu. |
| Phân Tích Từ | — | Tách văn bản thô thành các token có thể đếm được — thường là chuyển thành chữ thường, loại bỏ dấu câu, và quyết định cách xử lý các số, dấu gạch ngang và các liên kết. Nó khắc phục cả mẫu số TF và thứ tính là một kết quả phù hợp. |
| Từ Dừng | — | Một từ chức năng rất phổ biến (các, của, và, là) mang thông tin chủ đề ít. Thường bị loại bỏ trước khi chấm điểm, mặc dù TF-IDF tự động loại bỏ các từ như vậy vì IDF của chúng gần giá trị tối thiểu. |
| Làm Mịn | — | Các số hạng \(+1\) trong \(\ln(1 + N/(df+1))\). Số \(+1\) trong mẫu số ngăn chặn phép chia cho không khi \(df = 0\) (một thuật ngữ không tìm thấy trong kho dữ liệu); số \(+1\) bên trong logarit giữ cho đối số lớn hơn 1, vì vậy kết quả luôn hoàn toàn dương và không bao giờ bằng không hoặc âm. |
| Cơ Số Logarit | \(\ln\), \(\log_{10}\) | Cơ số logarit được sử dụng trong IDF. Thay đổi cơ số chỉ nhân mọi IDF với một hằng số — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — vì vậy thứ hạng của các thuật ngữ không thay đổi trong khi các số tuyệt đối có thay đổi. Luôn nêu rõ cơ số bạn đã sử dụng. |
| Từ Vựng | \(V\) | Tập hợp các thuật ngữ riêng biệt trên toàn bộ kho dữ liệu sau khi phân tích từ. Kích thước của nó là chiều của không gian vectơ TF-IDF. |
Lưu ý rằng TF-IDF là một họ các công thức chứ không phải một công thức duy nhất: các biến thể bao gồm TF đếm thô, TF chuẩn hóa logarit \(1 + \ln(tf)\), TF tăng cường, và IDF không được làm mịn hoặc xác suất. Điểm từ các biến thể khác nhau không bao giờ nên so sánh trực tiếp.
Câu hỏi thường gặp
Tại sao IDF lại dùng logarit? Hàm log giúp giảm nhẹ ảnh hưởng của những từ cực kỳ hiếm gặp, để một lần xuất hiện duy nhất không chi phối toàn bộ điểm số, nhờ đó kết quả luôn cân bằng.
Nên dùng cơ số log nào? Cả cơ số 10 lẫn logarit tự nhiên (\(\ln\)) đều phổ biến. Cơ số chỉ làm thay đổi kết quả theo cùng một tỷ lệ, nên việc so sánh trong cùng một tập ngữ liệu vẫn hoàn toàn hợp lệ.
Điểm bằng 0 có ý nghĩa gì? Nếu một từ xuất hiện trong mọi tài liệu (\(N = \) số tài liệu chứa từ), thì IDF trở thành \(\log(1) = 0\), khiến điểm TF-IDF bằng 0 — nghĩa là từ đó không mang giá trị phân biệt nào cả.